외부 데이터 소스
DataFlux Func를 통해 MySQL, Prometheus 등 다양한 유형의 외부 데이터 소스를 Guance에 연결할 수 있습니다. 또한 TiDB Cloud Lake를 직접 연결하여 데이터를 통합 조회하고 시각화할 수 있습니다.
기능
- 네이티브 쿼리: 차트에서 데이터 소스의 네이티브 쿼리문을 직접 사용하며, 추가 변환이 필요하지 않습니다.
- 데이터 보호: Func 데이터 소스의 연결 정보는 로컬 Func에 저장됩니다. TiDB Cloud Lake의 Lake DSN은 플랫폼에서 암호화하여 저장하며, 비밀번호와 전체 DSN은 목록, 상세 정보 및 쿼리에서 표시되지 않습니다.
- 사용자 정의 관리: 실제 필요에 따라 다양한 외부 데이터 소스를 손쉽게 추가하고 관리할 수 있습니다.
- 실시간 데이터: 외부 데이터 소스에 직접 연결하여 실시간으로 데이터를 가져오고, 즉시 응답하여 의사 결정을 내릴 수 있습니다.
연결 방식
| 연결 방식 | 적용 데이터 소스 | 설명 |
|---|---|---|
| DataFlux Func를 통해 연결 | MySQL, Prometheus 등 | 이미 배포된 DataFlux Func와 Connector를 재사용하며, ID 등 기존 설정은 변경하지 않고 유지해야 합니다. |
| TiDB Cloud Lake 직접 연결 | TiDB Cloud Lake | Guance 서버가 TiDB Cloud Lake Driver를 통해 연결하며, DataFlux Func에 의존하지 않고 데이터 소스 ID도 입력할 필요가 없습니다. |
TiDB Cloud Lake를 직접 연결해야 하는 경우 TiDB Cloud Lake 연결 및 쿼리를 참고하세요.
DataFlux Func를 통해 연결
Guance 측에서 데이터 소스 추가
확장에서 직접 연결된 DataFlux Func를 추가하거나 확인하여 모든 연결된 외부 데이터 소스를 관리합니다.
참고
이 방식은 두 번째 경로보다 초보자에게 더 친숙하므로 권장합니다.
- DataFlux Func를 드롭다운에서 선택합니다.
- 지원하는 데이터 소스 유형을 선택합니다.
- 연결 속성을 정의합니다. 여기에는 ID, 데이터 소스 제목, 연결된 호스트, 포트, 데이터베이스, 사용자, 비밀번호가 포함됩니다.
- 필요에 따라 연결을 테스트합니다.
- 저장합니다.
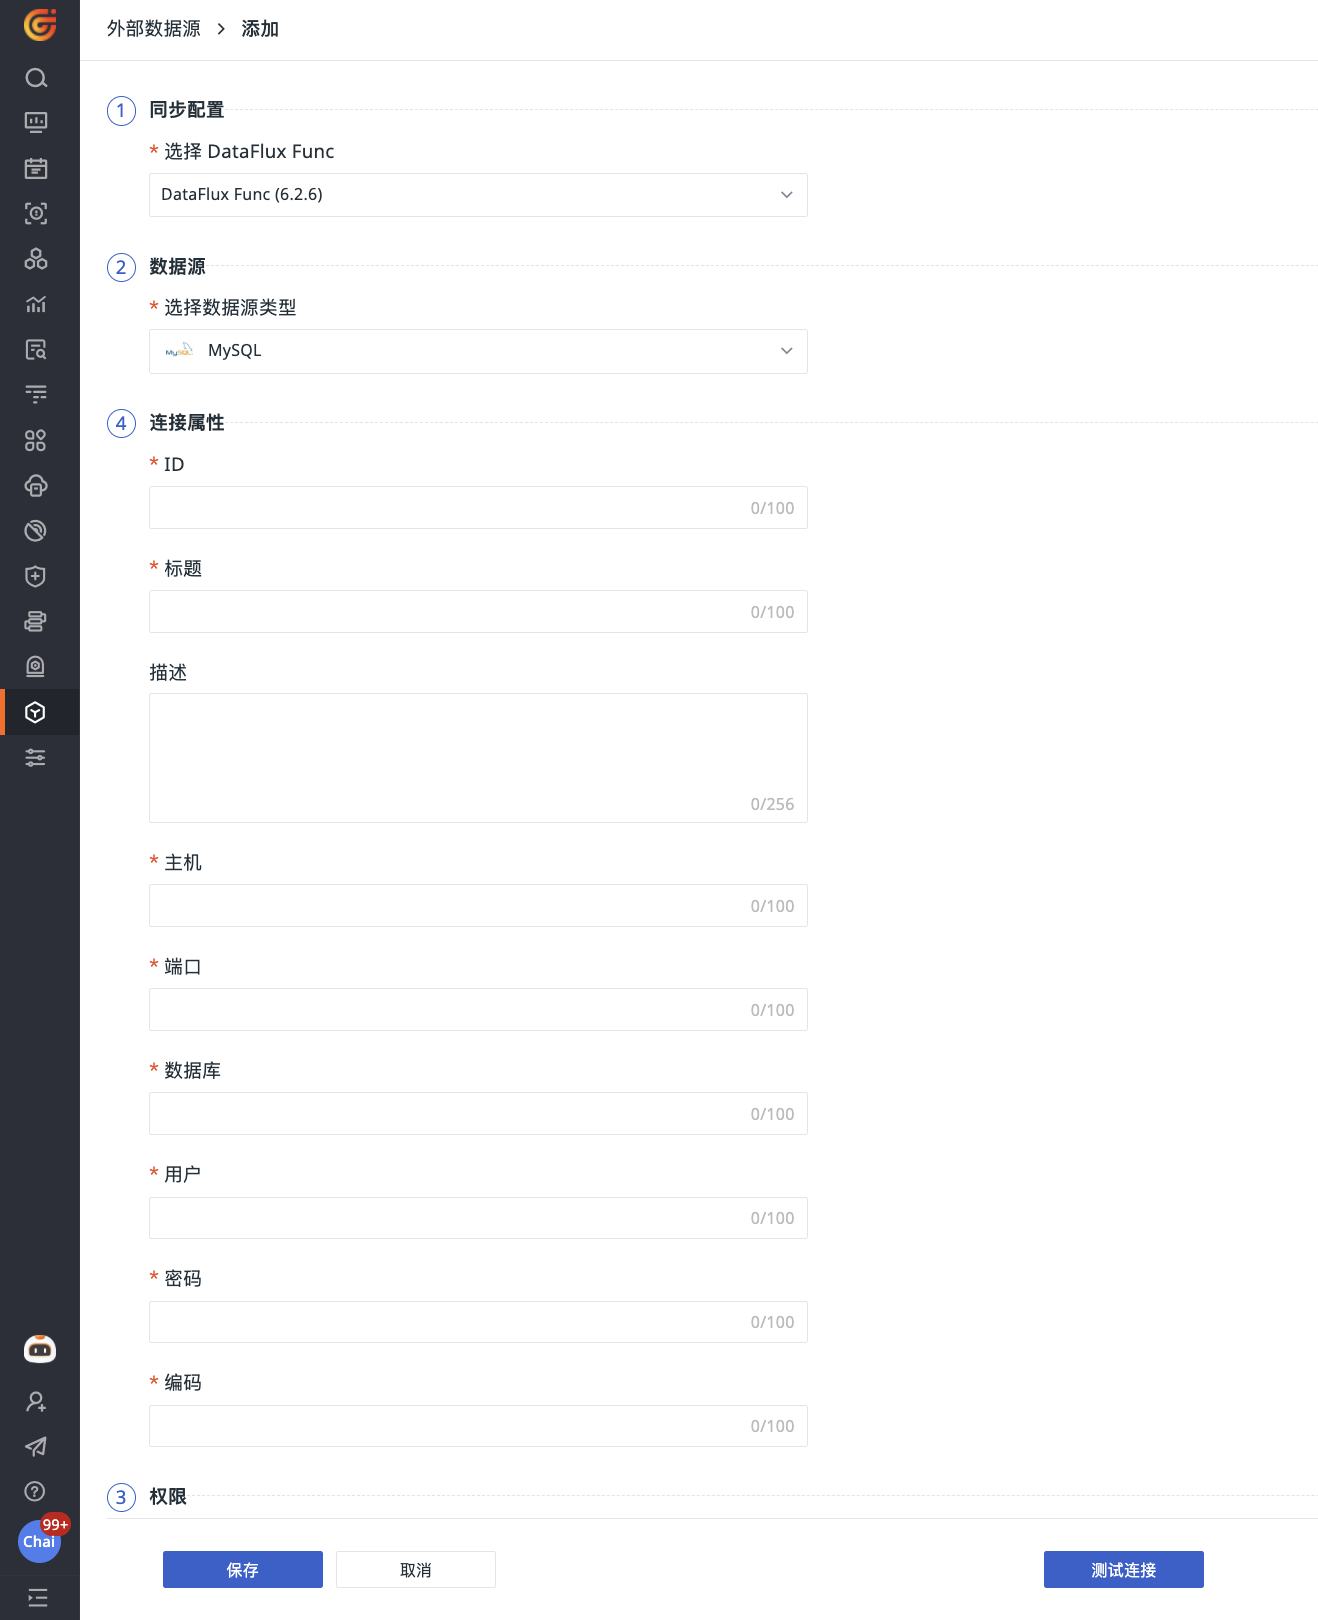
Func를 사용하여 외부 데이터 소스 쿼리
참고
여기서 "외부 데이터 소스"는 광범위한 의미를 가지며, 일반적인 외부 데이터 저장 시스템(MySQL, Redis 등 데이터베이스)과 타사 시스템(예: Guance 콘솔)을 모두 포함합니다.
Func와 Guance 연결
커넥터를 통해 개발자는 Guance 시스템에 연결할 수 있습니다.
개발 > 커넥터 > 커넥터 추가 페이지로 이동합니다:
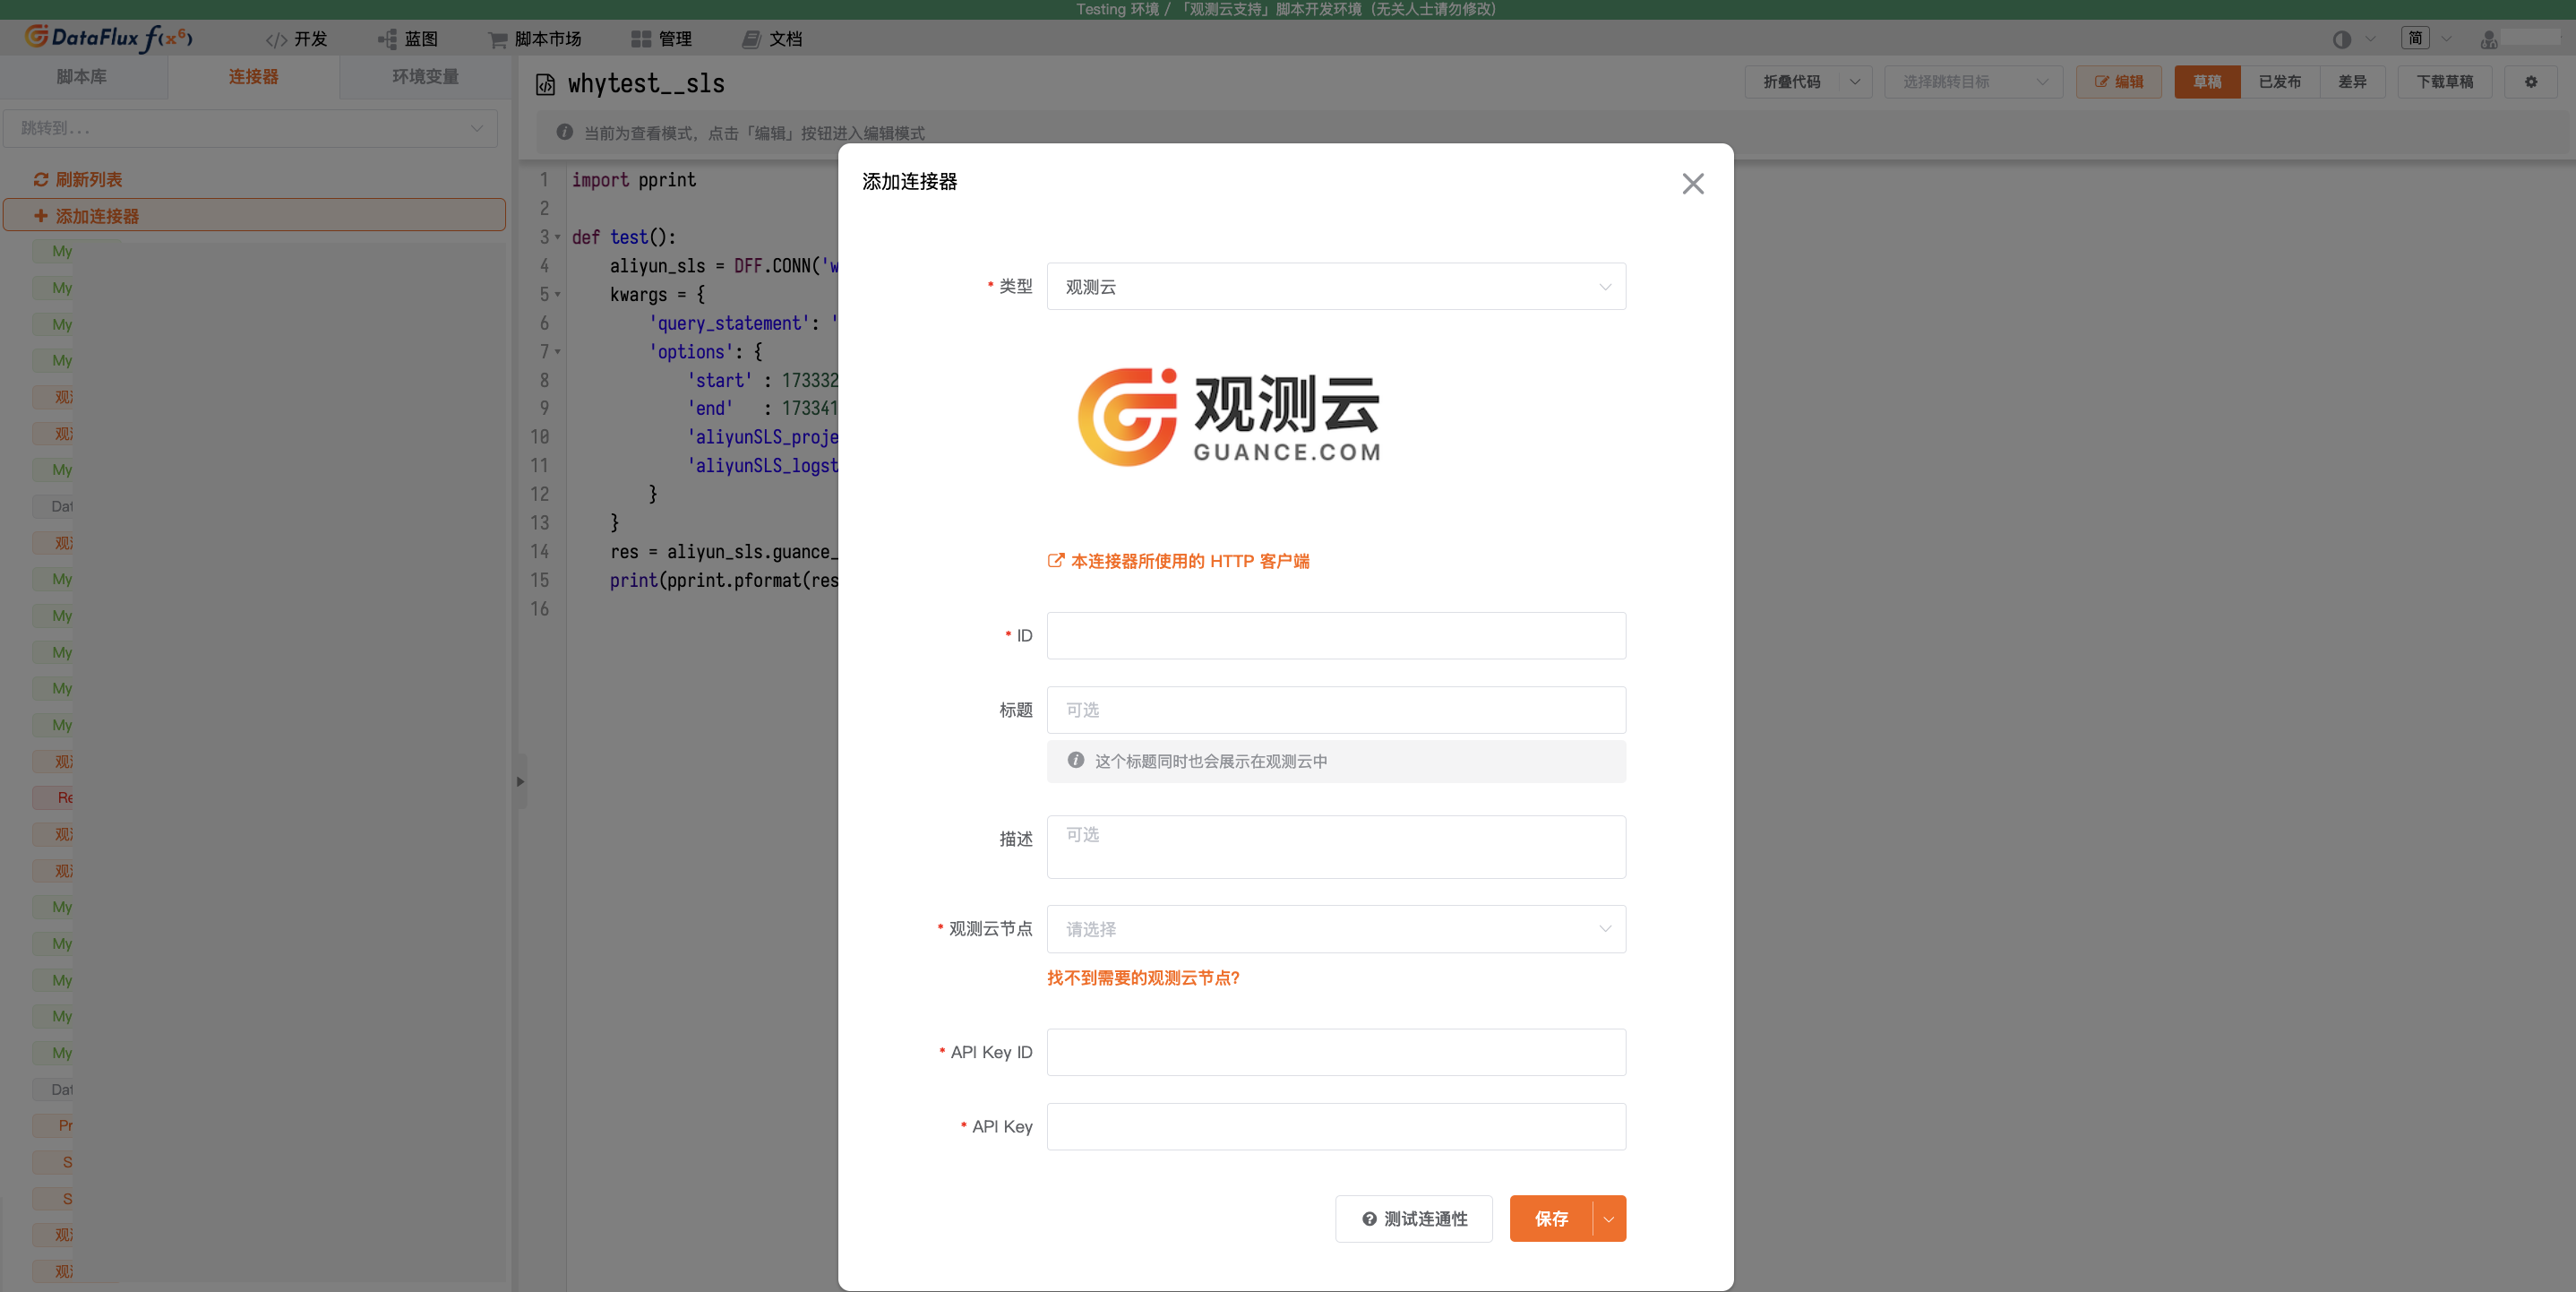
- 커넥터 유형을 선택합니다.
- 이 커넥터의 ID를 사용자 정의합니다.
- 제목을 추가합니다. 이 제목은 Guance 워크스페이스에 동기화되어 표시됩니다.
- 필요에 따라 커넥터 설명을 입력합니다.
- Guance 노드를 선택합니다.
- API Key ID와 API Key를 추가합니다.
- 필요에 따라 연결을 테스트합니다.
- 저장합니다.
연결이 완료되면 Func 플랫폼에서 다음 두 가지 방식으로 데이터 소스를 쿼리할 수 있습니다.
API Key 가져오는 방법
- Guance 워크스페이스 > 관리 > API Key 관리로 이동합니다.
- 페이지 오른쪽에서 Key 생성을 클릭합니다.
- 이름을 입력합니다.
- 확인을 클릭합니다. 시스템이 자동으로 API Key를 생성하며, API Key에서 확인할 수 있습니다.
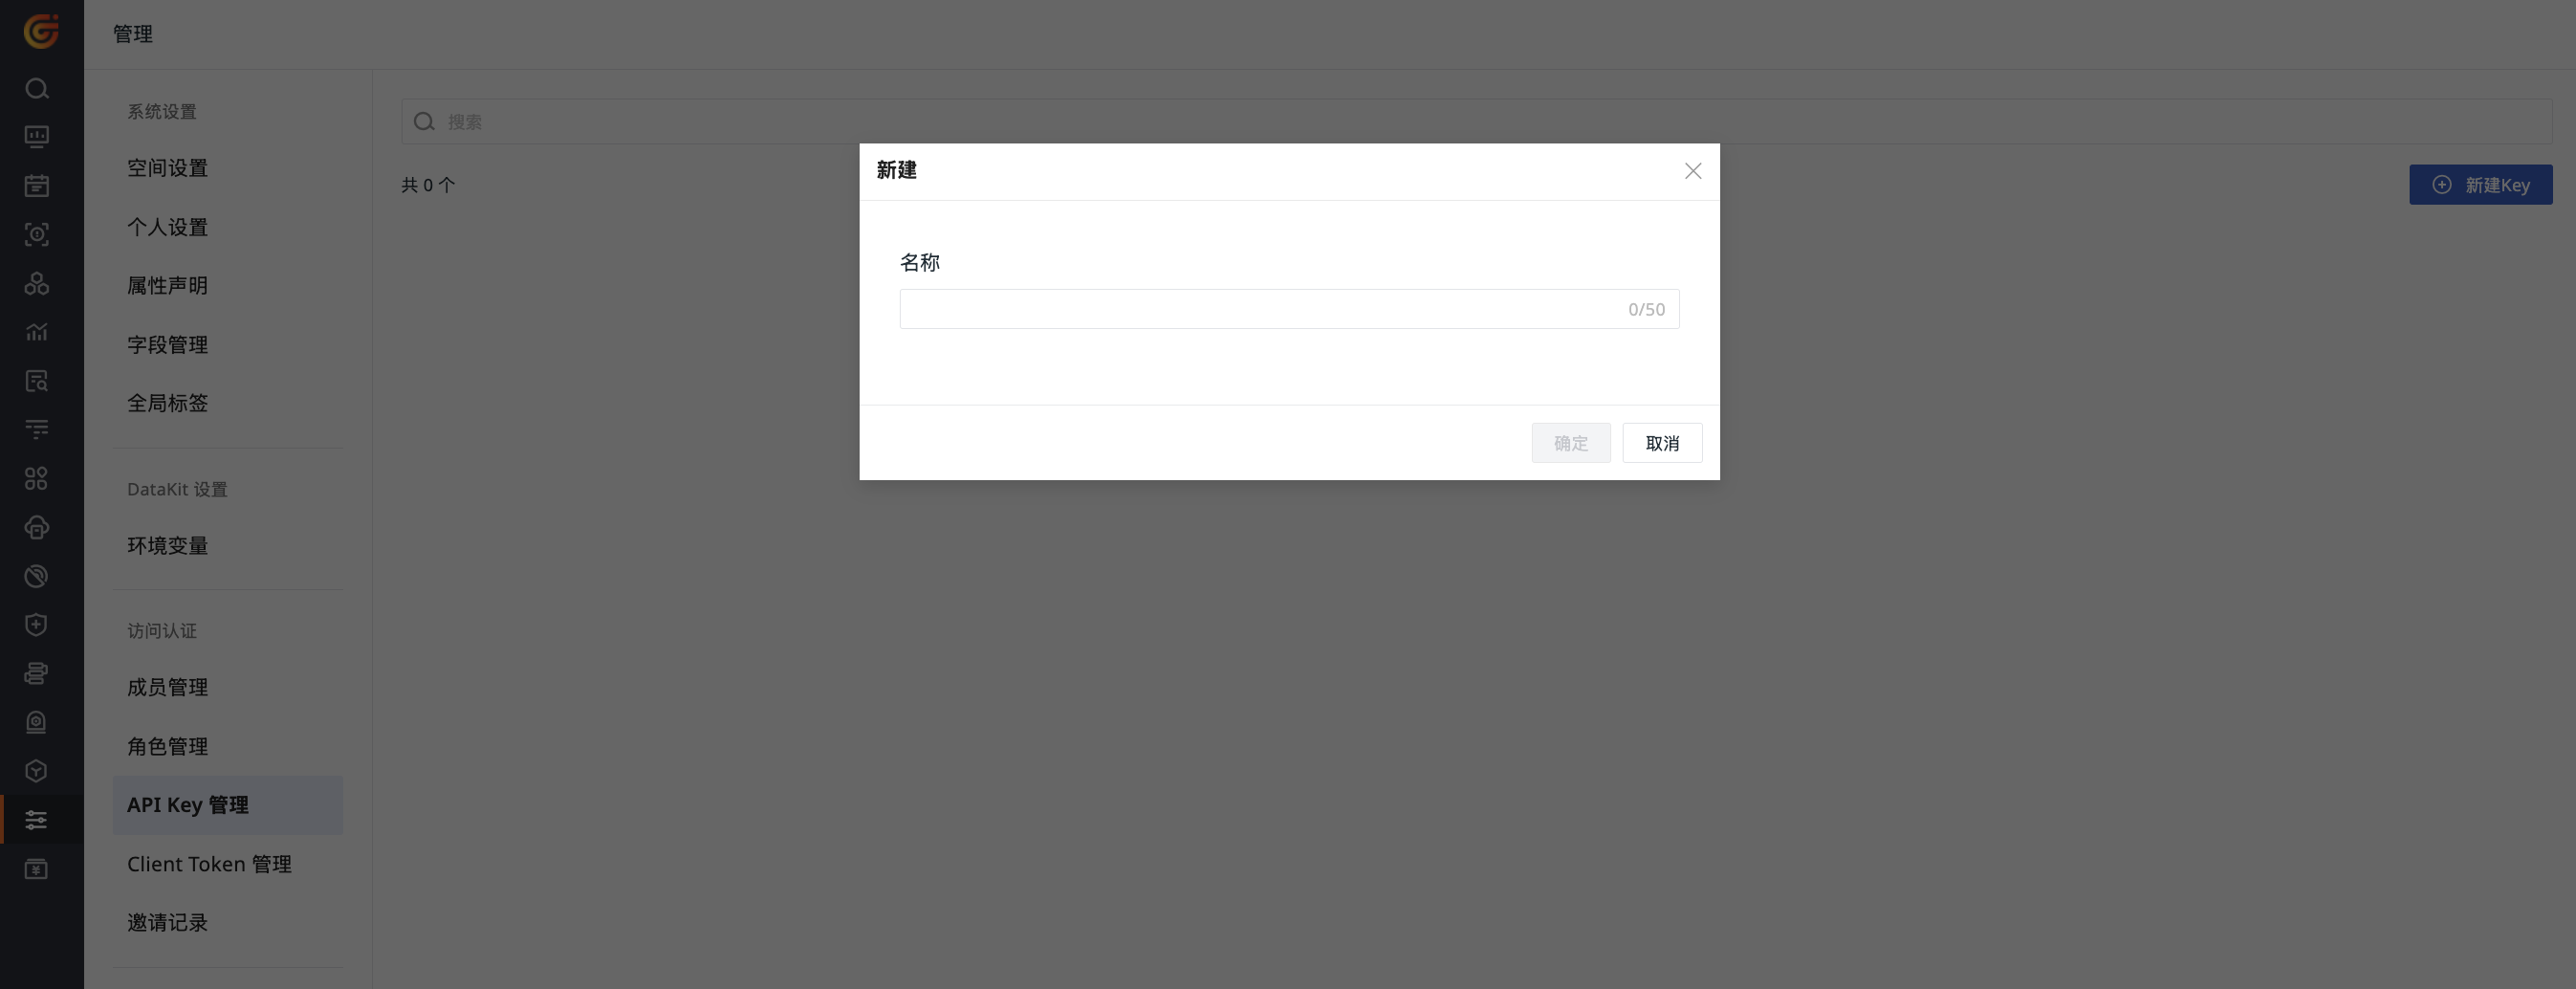
자세한 내용은 API Key 관리를 참고하세요.
커넥터 사용
커넥터를 정상적으로 추가한 후 스크립트에서 커넥터 ID를 사용하여 해당 커넥터의 작업 객체를 가져올 수 있습니다.
위 커넥터 예시에서 해당 커넥터의 작업 객체를 가져오는 코드는 다음과 같습니다.
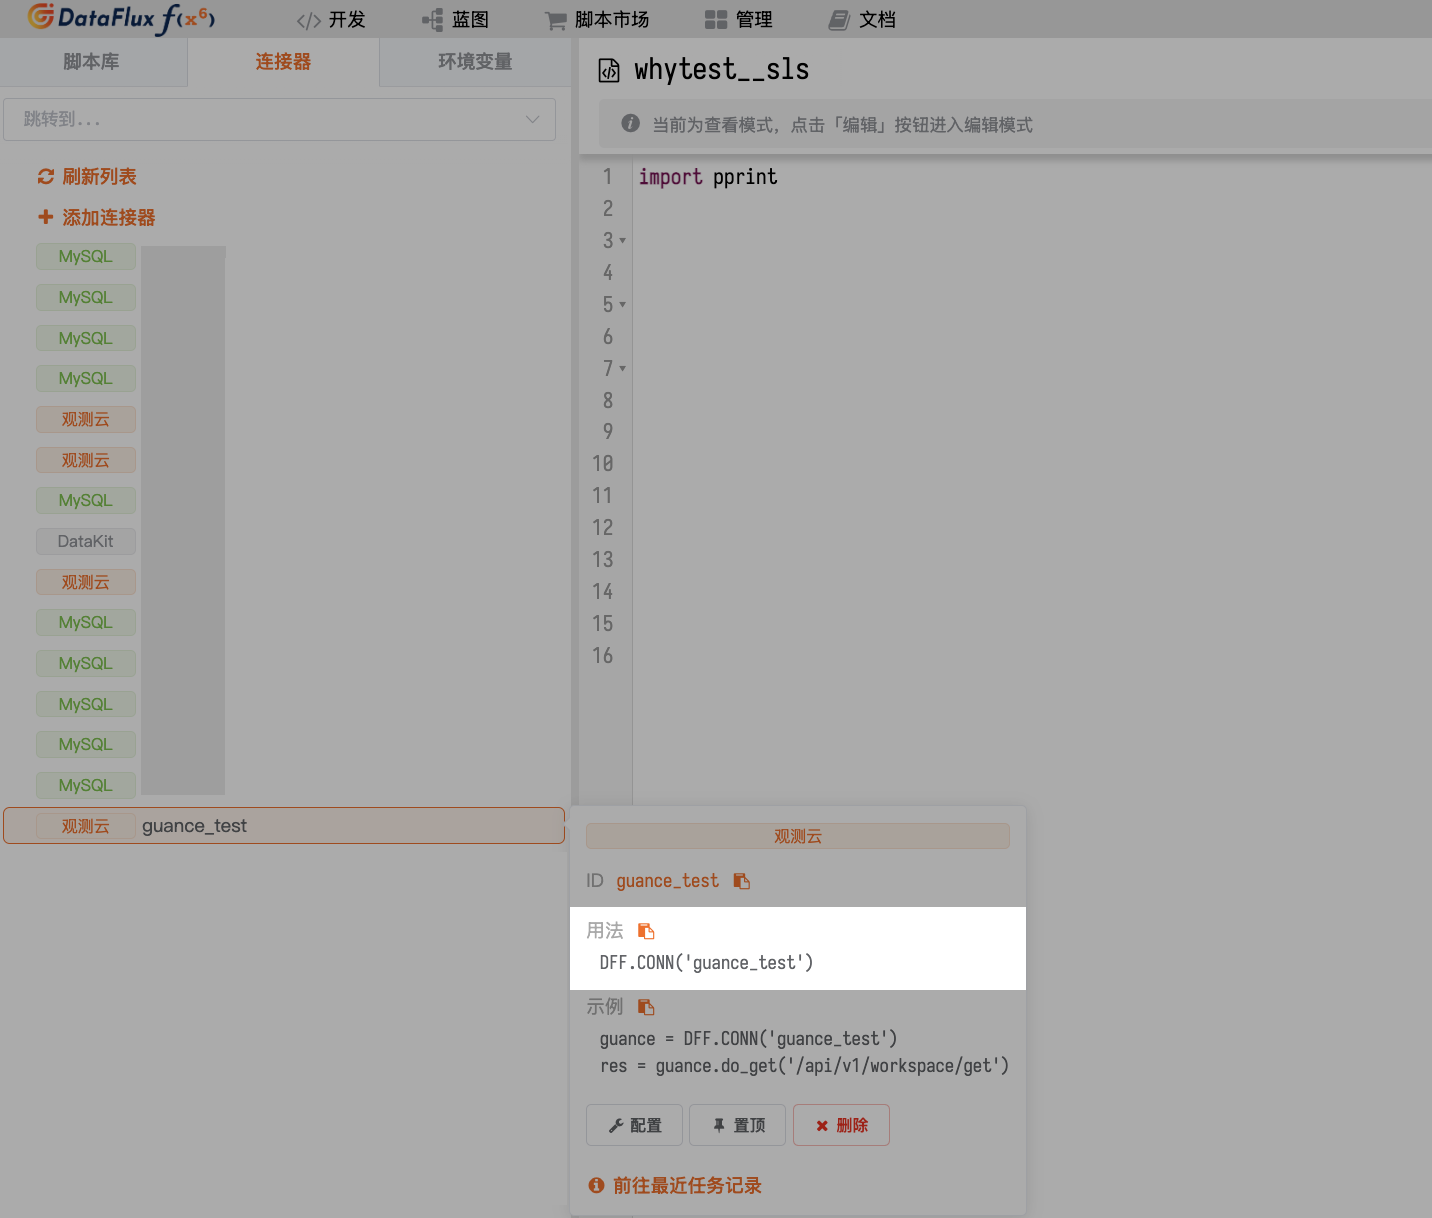
직접 스크립트 작성
커넥터를 사용하는 것 외에도 직접 함수를 작성하여 데이터를 쿼리할 수 있습니다.
사용자가 MySQL 커넥터(ID를 mysql로 정의)를 올바르게 생성했고, 이 MySQL에 my_table이라는 테이블이 있으며 다음 데이터가 포함되어 있다고 가정합니다.
id |
userId |
username |
reqMethod |
reqRoute |
reqCost |
createTime |
|---|---|---|---|---|---|---|
| 1 | u-001 | admin | POST | /api/v1/scripts/:id/do/modify | 23 | 1730840906 |
| 2 | u-002 | admin | POST | /api/v1/scripts/:id/do/publish | 99 | 1730840906 |
| 3 | u-003 | zhang3 | POST | /api/v1/scripts/:id/do/publish | 3941 | 1730863223 |
| 4 | u-004 | zhang3 | POST | /api/v1/scripts/:id/do/publish | 159 | 1730863244 |
| 5 | u-005 | li4 | POST | /api/v1/scripts/:id/do/publish | 44 | 1730863335 |
| ... |
이때 데이터 쿼리 함수를 사용하여 이 테이블의 데이터를 쿼리하고, 필드 추출 규칙은 다음과 같다고 가정합니다.
| 원본 필드 | 추출 대상 |
|---|---|
createTime |
시간 time |
reqCost |
열 req_cost |
reqMethod |
열 req_method |
reqRoute |
열 req_route |
userId |
태그 user_id |
username |
태그 username |
그러면 전체 참조 코드는 다음과 같습니다.
- 데이터 쿼리 함수 예시
import json

@DFF.API('my_table에서 데이터 쿼리', category='dataPlatform.dataQueryFunc')
def query_from_my_table(time_range):
    # 커넥터 작업 객체 가져오기
    mysql = DFF.CONN('mysql')

    # MySQL 쿼리문
    sql = '''
      SELECT
        createTime, userId, username, reqMethod, reqRoute, reqCost
      FROM
        my_table
      WHERE
        createTime     > ?
        AND createTime < ?
      LIMIT 5
    '''

    # 전달된 time_range 단위는 밀리초
    # MySQL에서 createTime 필드 단위는 초이므로 변환 필요
    sql_params = [
      int(time_range[0] / 1000),
      int(time_range[1] / 1000),
    ]

    # 쿼리 실행
    db_res = mysql.query(sql, sql_params)

    # DQL 유사 반환 결과로 변환

    # 태그에 따라 여러 데이터 시퀀스가 생성될 수 있음
    # 데이터 시퀀스 태그를 Key로 사용하여 매핑 테이블 생성
    series_map = {}

    # 원본 데이터를 순회하며 구조를 변환하여 매핑 테이블에 저장
    for d in db_res:
        # 태그 수집
        tags = {
            'user_id' : d.get('userId'),
            'username': d.get('username'),
        }

        # 태그 직렬화 (tag key 정렬 필요, 출력 일관성 보장)
        tags_dump = json.dumps(tags, sort_keys=True, ensure_ascii=True)

        # 이 태그의 데이터 시리즈가 아직 생성되지 않은 경우 생성
        if tags_dump not in series_map:
            # 데이터 시리즈 series 기본 구조
            series_map[tags_dump] = {
                'columns': [ 'time', 'req_cost', 'req_method', 'req_route' ], # 열 (1열은 항상 time)
                'tags'   : tags,                                              # 태그
                'values' : [],                                                # 값 목록
            }

        # 시간, 열을 추출하고 value에 추가
        series = series_map[tags_dump]
        value = [
            d.get('createTime') * 1000, # 시간 time (출력 단위는 밀리초가 필요하므로 실제 상황에 맞게 변환)
            d.get('reqCost'),           # 열 req_cost
            d.get('reqMethod'),         # 열 req_method
            d.get('reqRoute'),          # 열 req_route
        ]
        series['values'].append(value)

    # DQL 외부 구조 추가
    dql_like_res = {
        # 데이터 시리즈
        'series': [ list(series_map.values()) ] # 여기에 배열을 한 번 더 감싸야 함
    }
    return dql_like_res
데이터 변환 처리만 알고 싶고 쿼리 과정은 신경 쓰지 않는 경우(또는 현재 실제 데이터베이스가 없는 경우) 다음 코드를 참고할 수 있습니다.
- 데이터 쿼리 함수 예시 (MySQL 쿼리 부분 제외)
import json

@DFF.API('특정 소스에서 데이터 쿼리', category='dataPlatform.dataQueryFunc')
def query_from_somewhere(time_range):
    # 어떤 방식으로든 원본 데이터를 가져왔다고 가정
    db_res = [
        {'createTime': 1730840906, 'reqCost': 23,   'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/modify',  'username': 'admin',  'userId': 'u-001'},
        {'createTime': 1730840906, 'reqCost': 99,   'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/publish', 'username': 'admin',  'userId': 'u-001'},
        {'createTime': 1730863223, 'reqCost': 3941, 'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/publish', 'username': 'zhang3', 'userId': 'u-002'},
        {'createTime': 1730863244, 'reqCost': 159,  'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/publish', 'username': 'zhang3', 'userId': 'u-002'},
        {'createTime': 1730863335, 'reqCost': 44,   'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/publish', 'username': 'li4',    'userId': 'u-003'}
    ]

    # DQL 유사 반환 결과로 변환

    # 태그에 따라 여러 데이터 시퀀스가 생성될 수 있음
    # 데이터 시퀀스 태그를 Key로 사용하여 매핑 테이블 생성
    series_map = {}

    # 원본 데이터를 순회하며 구조를 변환하여 매핑 테이블에 저장
    for d in db_res:
        # 태그 수집
        tags = {
            'user_id' : d.get('userId'),
            'username': d.get('username'),
        }

        # 태그 직렬화 (tag key 정렬 필요, 출력 일관성 보장)
        tags_dump = json.dumps(tags, sort_keys=True, ensure_ascii=True)

        # 이 태그의 데이터 시리즈가 아직 생성되지 않은 경우 생성
        if tags_dump not in series_map:
            # 데이터 시리즈 series 기본 구조
            series_map[tags_dump] = {
                'columns': [ 'time', 'req_cost', 'req_method', 'req_route' ], # 열 (1열은 항상 time)
                'tags'   : tags,                                              # 태그
                'values' : [],                                                # 값 목록
            }

        # 시간, 열을 추출하고 value에 추가
        series = series_map[tags_dump]
        value = [
            d.get('createTime') * 1000, # 시간 time (출력 단위는 밀리초가 필요하므로 실제 상황에 맞게 변환)
            d.get('reqCost'),           # 열 req_cost
            d.get('reqMethod'),         # 열 req_method
            d.get('reqRoute'),          # 열 req_route
        ]
        series['values'].append(value)

    # DQL 외부 구조 추가
    dql_like_res = {
        # 데이터 시리즈
        'series': [ list(series_map.values()) ] # 여기에 배열을 한 번 더 감싸야 함
    }
    return dql_like_res
- 반환 결과 예시
{
  "series": [
    [
      {
        "columns": ["time", "req_cost", "req_method", "req_route"],
        "tags": {"user_id": "u-001", "username": "admin"},
        "values": [
          [1730840906000, 23, "POST", "/api/v1/scripts/:id/do/modify" ],
          [1730840906000, 99, "POST", "/api/v1/scripts/:id/do/publish"]
        ]
      },
      {
        "columns": ["time", "req_cost", "req_method", "req_route"],
        "tags": {"user_id": "u-002", "username": "zhang3"},
        "values": [
          [1730863223000, 3941, "POST", "/api/v1/scripts/:id/do/publish"],
          [1730863244000,  159, "POST", "/api/v1/scripts/:id/do/publish"]
        ]
      },
      {
        "columns": ["time", "req_cost", "req_method", "req_route"],
        "tags": {"user_id": "u-003", "username": "li4"},
        "values": [
          [1730863335000, 44, "POST", "/api/v1/scripts/:id/do/publish"]
        ]
      }
    ]
  ]
}
관리 목록
연결된 모든 데이터 소스는 통합 > 외부 데이터 소스 > 연결된 데이터 소스에서 확인할 수 있습니다.
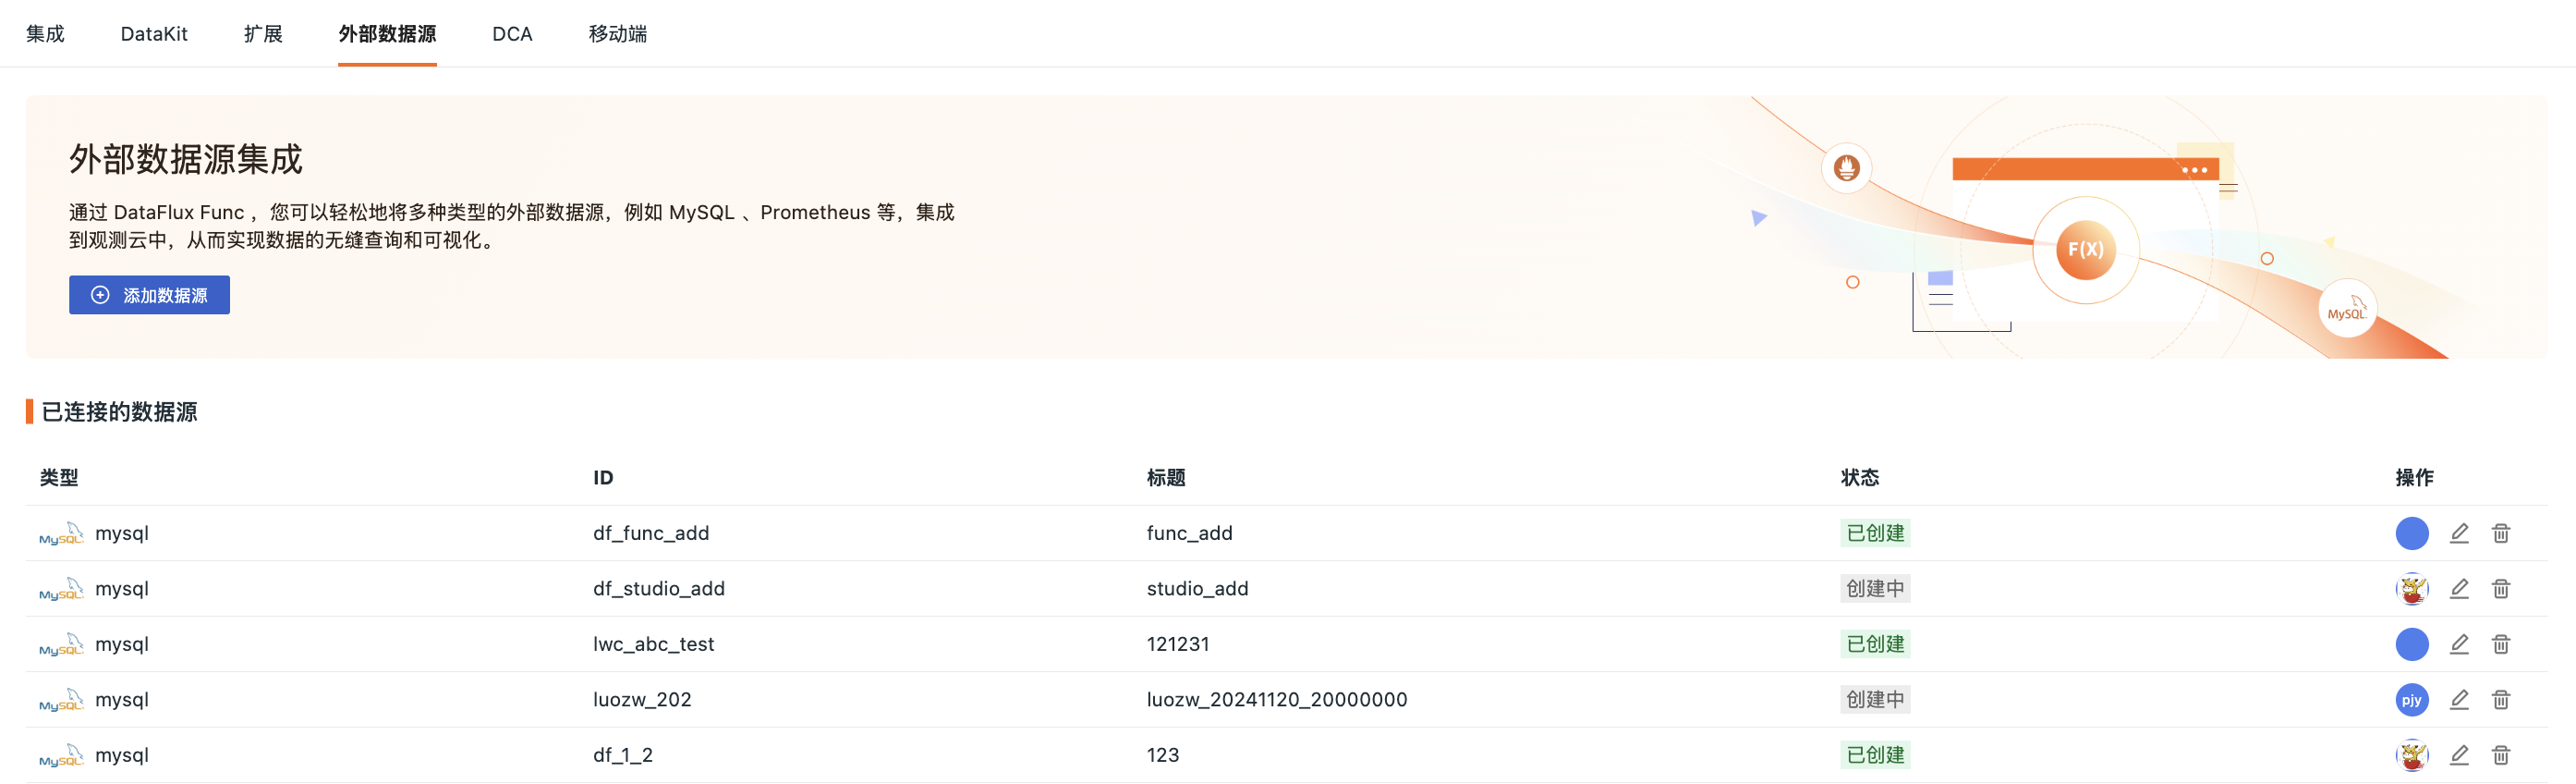
목록에서 다음 작업을 수행할 수 있습니다.
- 데이터 소스의 유형, ID, 상태, 생성 정보 및 업데이트 정보 등을 확인합니다.
- 특정 데이터 소스를 편집하여 DataFlux Func, 데이터 소스 유형 및 ID를 제외한 구성을 수정합니다.
- 특정 데이터 소스를 삭제합니다.
사용 사례
Guance에서 외부 데이터 소스를 사용하여 쿼리하는 대표적인 사용 사례 중 하나는 차트 > 차트 쿼리입니다.
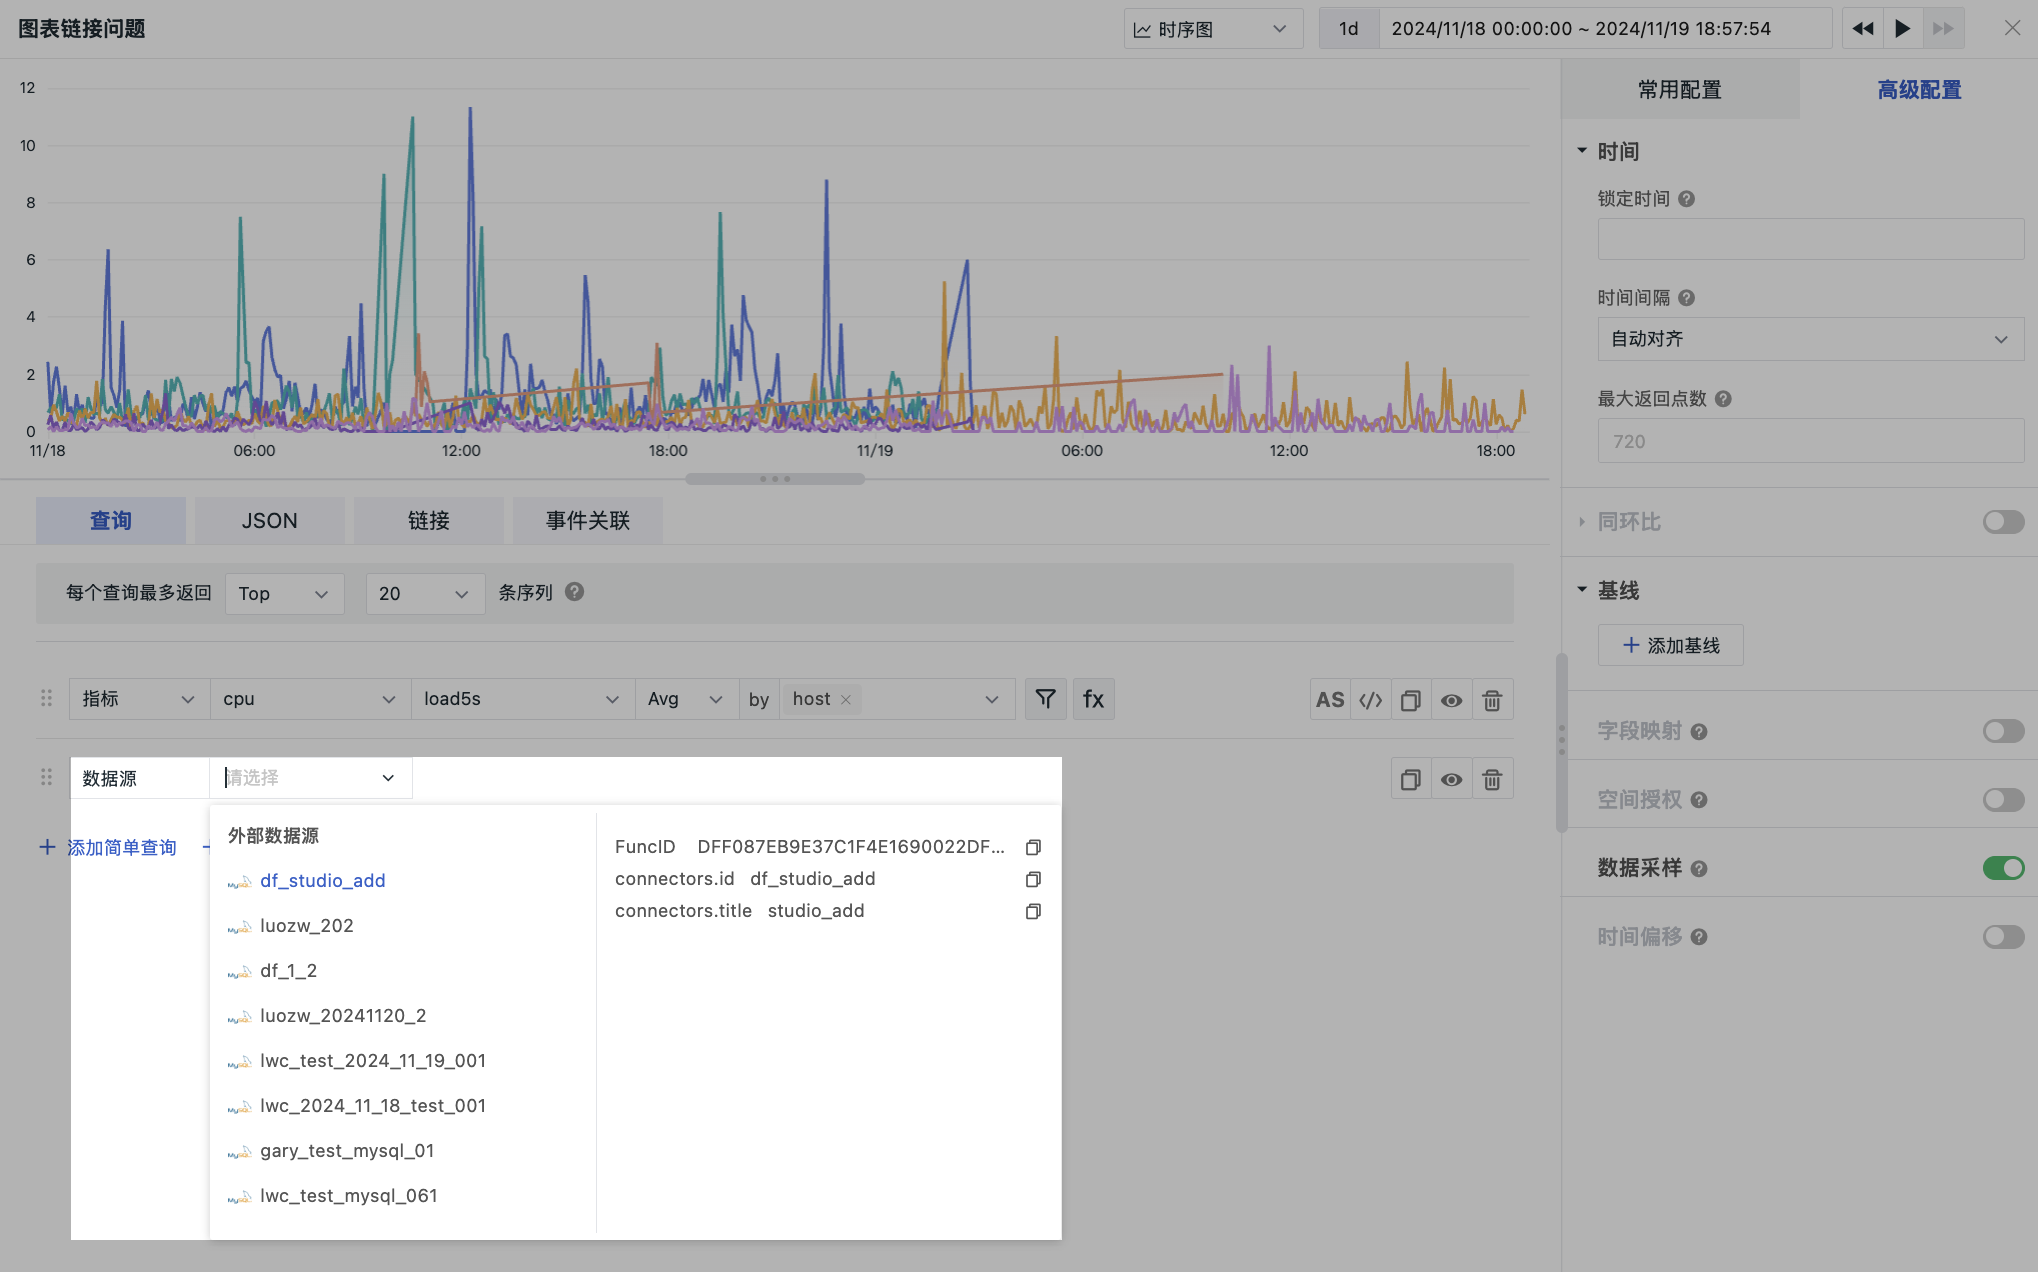
| 다양한 차트의 데이터 반환 | ||
|---|---|---|
| 꺾은선 그래프 | 파이 차트 | 테이블 차트 |