Guance VS ELK, EFK
ELK, EFK 및 Guance 개요
현대 소프트웨어 시스템의 복잡도가 점점 높아짐에 따라 일반적으로 로그는 서버에서 생성되어 여러 파일로 출력됩니다. 일반적으로 시스템 로그, 애플리케이션 로그, 보안 로그가 있으며 이러한 로그는 서로 다른 머신에 분산 저장됩니다. 시스템에 장애가 발생하면 엔지니어는 각 서버에 로그인하여 grep / sed / awk 등의 Linux 스크립트 도구를 사용해 로그에서 장애 원인을 찾아야 합니다. 로그 시스템이 없는 경우 먼저 요청을 처리한 서버를 찾아야 하며, 해당 서버에 여러 인스턴스가 배포되어 있다면 각 애플리케이션 인스턴스의 로그 디렉터리에서 로그 파일을 찾아야 합니다. 또한 각 애플리케이션 인스턴스에는 로그 롤링 정책(예: 매일 파일 하나 생성), 로그 압축 아카이브 정책 등이 설정되어 있습니다. 이러한 일련의 과정은 장애를 조사하고 적시에 장애 원인을 찾는 데 상당한 어려움을 줍니다.
클라우드에 배포하면 각 노드에 로그인하여 각 모듈의 로그를 확인하는 것은 사실상 불가능합니다. 효율이 낮을 뿐만 아니라 보안상의 이유로 엔지니어가 각 물리 노드에 직접 접근할 수 없는 경우도 있기 때문입니다. 또한 현재 대규모 소프트웨어 시스템은 대부분 클러스터 방식으로 배포되므로 각 서비스마다 완전히 동일한 여러 개의 POD가 실행되어 서비스를 제공하고 각 컨테이너는 자체 로그를 생성합니다. 생성된 로그만으로는 어느 POD에서 생성된 것인지 알 수 없어 분산 로그를 확인하기가 훨씬 더 어렵습니다.
따라서 이러한 로그를 중앙에서 관리하고 중앙 검색 기능을 제공할 수 있다면 진단 효율을 높일 수 있을 뿐만 아니라 시스템 상태를 전반적으로 파악하여 사후 대응에 몰리는 수동적인 상황을 피할 수 있습니다.
ELK
그렇다면 ELK란 무엇일까요? 'ELK'는 Elasticsearch, Logstash, Kibana라는 세 가지 오픈소스 프로젝트의 머리글자를 딴 약어입니다. Elasticsearch는 검색 및 분석 엔진입니다. Logstash는 서버 측 데이터 처리 파이프라인으로, 여러 소스에서 동시에 데이터를 수집하고 변환한 후 Elasticsearch와 같은 '저장소'로 데이터를 전송합니다. Kibana를 사용하면 Elasticsearch에서 그래프와 차트를 통해 데이터를 시각화할 수 있습니다.
Elasticsearch
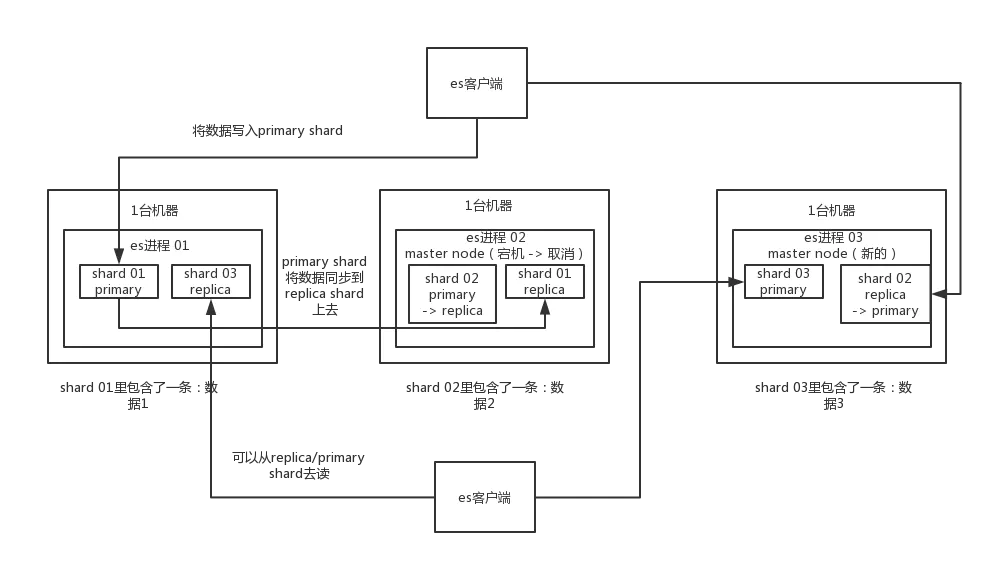
Elasticsearch는 JSON 기반의 분산 검색 및 분석 엔진입니다. RESTful 웹 서비스 인터페이스를 통해 액세스할 수 있으며 스키마가 없는 JSON(JavaScript Object Notation) 문서를 사용하여 데이터를 저장합니다. Java 프로그래밍 언어로 작성되어 Elasticsearch가 다양한 플랫폼에서 실행될 수 있습니다. 사용자는 매우 빠른 속도로 대용량 데이터를 검색할 수 있습니다.
주요 특징
- 분산형 실시간 파일 스토리지, 모든 필드가 인덱싱되어 검색 가능
- 분산형 실시간 분석 검색 엔진
- 수백 대의 서버로 확장 가능, PB 규모의 정형 또는 비정형 데이터 처리
Logstash
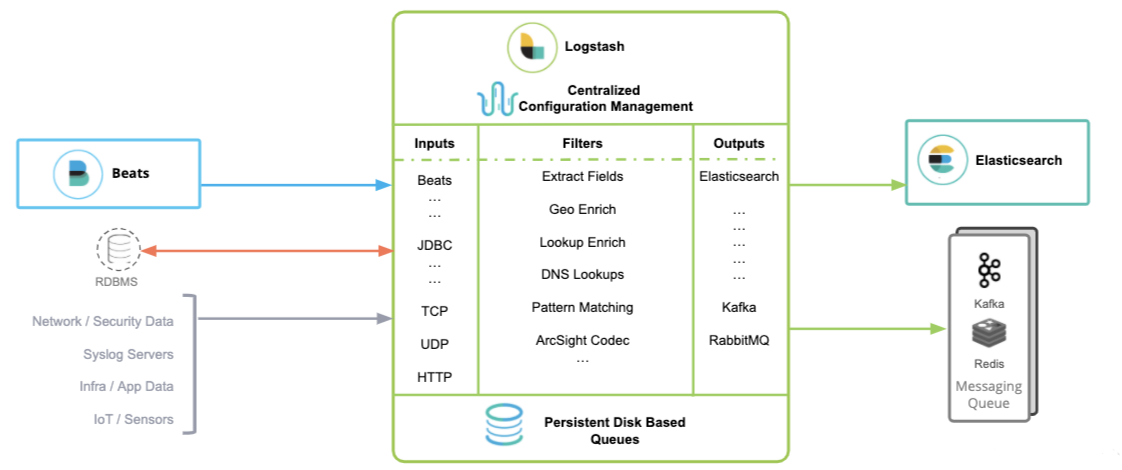
데이터 스트림을 위한 오픈소스 스트리밍 ETL 엔진으로, 몇 분 만에 데이터 스트림 파이프라인을 구축할 수 있습니다. 수평 확장성과 복원력, 적응형 버퍼링을 갖추고 있으며 200개 이상의 통합 및 프로세서 플러그인 생태계를 보유하고 있습니다. Elastic Stack을 사용하여 배포를 모니터링하고 관리합니다.
주요 특징
- 거의 모든 데이터에 액세스 가능
- 다양한 외부 애플리케이션과 연동 가능
- 탄력적 확장 지원
Logstash 구성
-
입력(inputs): inputs는 주로 데이터 수신 규칙을 제공합니다. 예를 들어 파일 내용 수집에 사용합니다.
-
필터(filters): filters는 주로 전송되는 데이터를 필터링합니다. 예를 들어 grok 규칙을 사용한 데이터 필터링입니다.
-
출력(outputs): outputs는 주로 수신한 데이터를 정의된 출력 패턴에 따라 출력합니다. 예를 들어 ElasticSearch로 출력합니다.
Kibana
Kibana는 Elastic Stack의 구성원 중 하나인 오픈소스 데이터 분석 및 시각화 플랫폼으로, Elasticsearch와 협력하도록 설계되었습니다. Kibana를 사용하여 Elasticsearch 인덱스의 데이터를 검색, 조회, 대화형으로 조작할 수 있습니다. 차트, 표, 지도를 활용하여 데이터를 다양한 방식으로 분석하고 표현할 수 있습니다.
Kibana는 빅데이터를 쉽고 이해하기 편하게 만듭니다. 브라우저 기반의 간단한 인터페이스로 Elasticsearch의 실시간 데이터 변화를 추적하는 동적 데이터 대시보드를 빠르게 생성하고 공유할 수 있습니다.
EFK
EFK는 하나의 소프트웨어가 아니라 일련의 솔루션입니다. EFK는 Elasticsearch, Fluentd, Kibana 또는 Elasticsearch, Filebeat, Kibana라는 세 가지 오픈소스 소프트웨어의 약어입니다. 이 중 Elasticsearch는 로그 분석 및 저장을 담당하고, Fluentd와 Filebeat는 로그 수집을 담당하며, Kibana는 UI 표시를 담당합니다. 이들 간의 긴밀한 협업을 통해 다양한 환경에서 효율적으로 활용할 수 있는 현재 주류 로그 분석 시스템 솔루션입니다.
Fluentd
Fluentd는 데이터 스트림 처리를 위해 설계된 오픈소스 데이터 수집기로, JSON을 데이터 형식으로 사용합니다. 플러그인 기반 아키텍처를 채택하여 높은 확장성과 고가용성을 갖추고 있으며, 고신뢰성 정보 전달도 구현했습니다. 사용 시 다양한 소스의 정보를 먼저 Fluentd로 보내면, Fluentd는 구성에 따라 다양한 플러그인을 통해 파일, SaaS Platform, 데이터베이스 등 여러 대상으로 정보를 전달하며, 다른 Fluentd로 전달할 수도 있습니다.
주요 특징
- 설치 간편
- 작은 공간 점유
- 반정형 데이터 로그 기록
- 유연한 플러그인 메커니즘
- 안정적인 버퍼링
- 로그 전달
Fluentd 구성
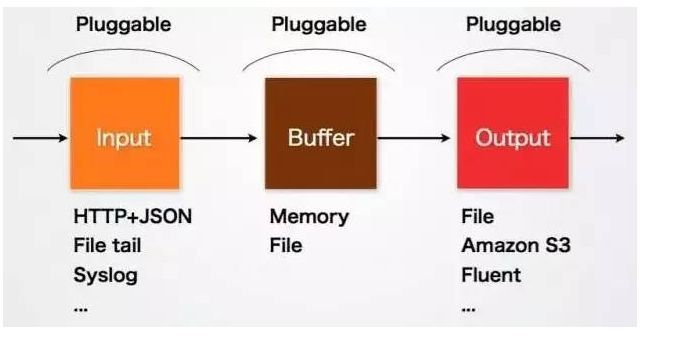
Fluentd의 Input/Buffer/Output은 Flume의 Source/Channel/Sink와 매우 유사합니다.
-
Input: Input은 데이터를 수신하거나 능동적으로 가져오는 역할을 담당합니다. syslog, HTTP, file tail 등을 지원합니다.
-
Buffer: Buffer는 데이터 수집의 성능과 안정성을 담당하며, 파일 또는 메모리 등 다양한 유형의 Buffer를 구성할 수 있습니다.
-
Output: Output은 파일, AWS S3 또는 다른 Fluentd 등 목적지로 데이터를 출력하는 역할을 담당합니다.
Filebeat
Filebeat는 Golang으로 구현된 경량 로그 수집기이며 Elasticsearch 스택의 일부입니다. 본질적으로 에이전트로, 각 노드에 설치하여 구성에 따라 해당 위치의 로그를 읽고 지정된 대상으로 전송합니다.
Filebeat는 안정성이 매우 높아 로그를 최소 한 번(At Least Once) 전송할 수 있습니다. 또한 로그 중단점 이어 읽기, 파일 이름 변경, 로그 잘림(Truncated) 등 로그 수집 과정의 다양한 문제까지 고려했습니다.
Filebeat는 ElasticSearch에 의존하지 않으며 단독으로 사용할 수 있습니다. Filebeat만으로 로그를 전송하고 수집할 수 있습니다. Filebeat에는 kafka, ElasticSearch, redis 등 일반적인 Output 컴포넌트가 내장되어 있으며, 디버깅을 위해 console과 file로 출력할 수도 있습니다. 기존 Output 컴포넌트를 활용하여 로그를 전송할 수 있으며, 물론 Output 컴포넌트를 직접 정의하여 Filebeat가 원하는 대상으로 로그를 전달하도록 할 수도 있습니다.
Filebeat는 실제로 elastic/beats 제품군 중 하나이며, Filebeat 외에도 HeartBeat, PacketBeat가 있습니다. 이러한 beat의 구현은 모두 libbeat 프레임워크를 기반으로 합니다.
Filebeat 구성
-
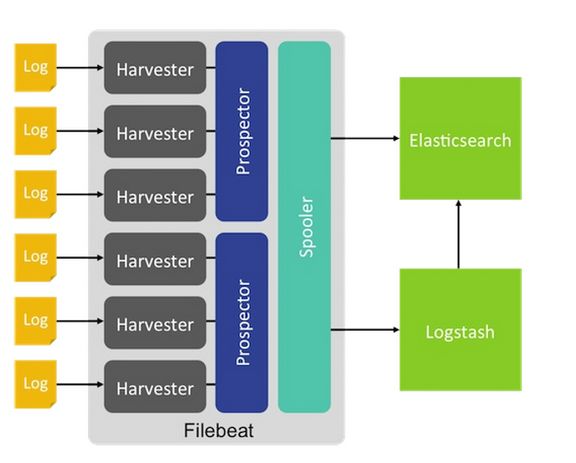
harvester 수집기: harvester 수집기의 주요 역할은 단일 파일의 내용을 읽는 것입니다. 각 파일을 읽고 내용을 output으로 전송합니다. 각 파일마다 하나의 harvester가 시작되며, harvester는 파일을 열고 닫는 역할을 담당합니다. 즉, 실행 중에는 파일 디스크립터가 열린 상태로 유지됩니다. 읽는 중에 파일이 삭제되거나 이름이 변경되어도 Filebeat는 계속해서 파일을 읽습니다.
-
prospector 찾기: prospector 찾기의 주요 역할은 harvester를 관리하고 읽어야 할 모든 파일 소스를 찾는 것입니다. 입력 유형이 로그인 경우 찾기는 경로와 일치하는 모든 파일을 찾고 각 파일마다 하나의 harvester를 시작합니다. 각 prospector는 자체 Go 고루틴에서 실행됩니다.
참고: Filebeat prospector는 로컬 파일만 읽을 수 있으며 원격 호스트에 연결하여 저장된 파일이나 로그를 읽는 기능은 없습니다. Filebeat의 적용 범위가 매우 제한적이므로 이 문서에서는 Filebeat에 대한 자세한 비교를 다루지 않습니다.
Guance
DataKit
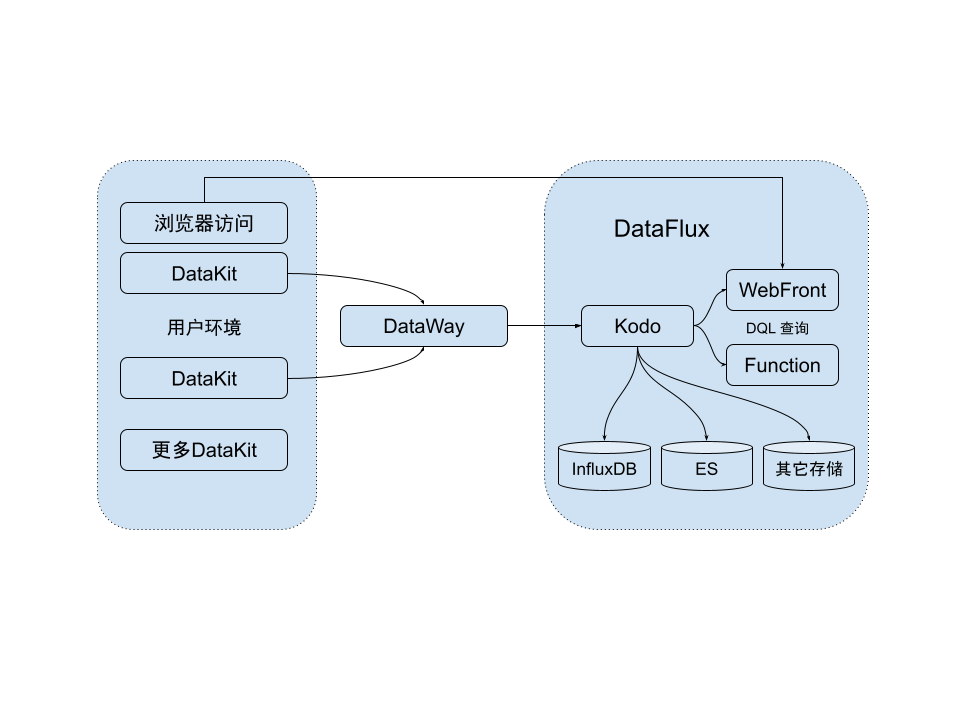
DataKit은 사용자 로컬 머신에서 실행되는 기본 데이터 수집 도구로, 주로 시스템에서 실행되는 다양한 메트릭, 로그 등의 데이터를 수집하여 Guance로 전송합니다. Guance에서 사용자는 다양한 메트릭, 로그 등의 데이터를 조회하고 분석할 수 있습니다. DataKit은 Guance에서 매우 중요한 데이터 수집 컴포넌트이며, Guance의 모든 데이터는 DataKit에서 비롯됩니다.
-
DataKit은 주로 주기적 수집 방식을 통해 다양한 메트릭을 수집한 후, 정기적·정량적으로 HTTP(s)를 통해 DataWay에 데이터를 전송합니다. 각 DataKit에는 서로 다른 사용자를 식별하기 위한 토큰이 구성됩니다.
-
DataWay는 데이터를 수신한 후 Guance로 전달하며, Guance로 전송되는 데이터에는 API 서명이 포함됩니다.
-
Guance는 유효한 데이터를 수신한 후 데이터 유형에 따라 각각 다른 스토리지에 기록합니다.
수집형 데이터 처리의 경우 일반적으로 일부 데이터 손실이 허용됩니다(데이터 자체가 간헐적으로 수집되므로 간헐 기간의 데이터는 일종의 데이터 손실로 간주할 수 있습니다). 현재 전체 데이터 전송 체인은 다음과 같은 손실 보호 조치를 제공합니다.
-
DataKit이 네트워크 문제로 DataWay 전송에 실패하면 DataKit은 최대 1,000개 포인트의 데이터를 캐시합니다. 캐시된 데이터가 이 용량을 초과하면 캐시가 정리됩니다.
-
DataWay가 어떤 이유로 Guance 전송에 실패하거나 트래픽이 많아 제때 Guance로 보내지 못하는 경우, DataWay는 이 데이터를 디스크에 영구 저장합니다. 이후 트래픽이 감소하거나 네트워크가 복구되면 이 데이터를 Guance로 전송합니다. 지연 전송된 데이터는 실시간성에 영향을 주지 않으며, 타임스탬프는 캐시된 데이터에 포함되어 있습니다.
DataWay에서는 디스크를 보호하기 위해 디스크 최대 사용량을 구성할 수 있어 해당 노드의 스토리지가 가득 차는 것을 방지합니다. 사용량을 초과하는 데이터는 DataWay에서 삭제됩니다. 다만 이 용량은 일반적으로 크게 설정됩니다.
DataKit 구성
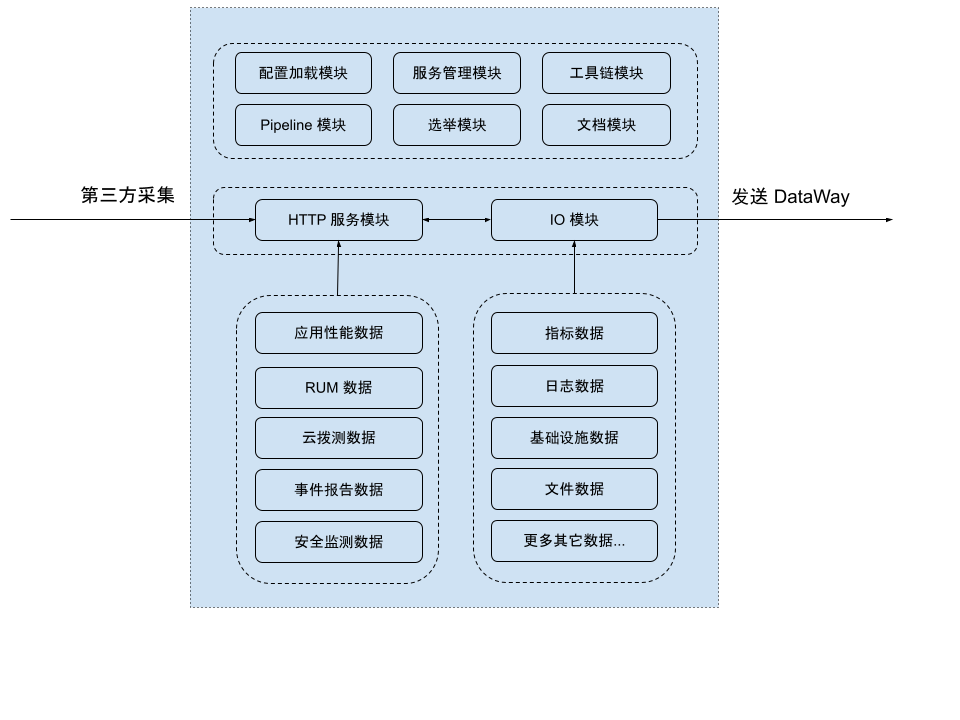
위에서 아래로 DataKit 내부는 크게 세 개의 레이어로 나뉩니다.
- 최상위 레이어: 프로그램 진입 모듈 및 일부 공용 모듈 포함
- 설정 로드 모듈: DataKit은 자체 메인 설정(즉
conf.d/datakit.conf) 외에도 각 수집기의 설정이 별도로 구성됩니다. 함께 두면 설정 파일이 매우 커져 편집이 어려울 수 있습니다. - 서비스 관리 모듈: 주로 전체 DataKit 서비스 관리를 담당합니다.
- 도구 체인 모듈: DataKit은 클라이언트 프로그램으로서 데이터 수집 외에도 문서 보기, 서비스 재시작, 업데이트 등 다양한 주변 기능을 제공하며, 이러한 기능은 도구 체인 모듈에서 구현됩니다.
- Pipeline 모듈: 로그 처리에서 Pipeline 스크립트(Grok 문법)를 통해 로그를 파싱하여 비정형 로그 데이터를 정형 데이터로 변환합니다. 기타 비로그 데이터에서도 해당 데이터 처리를 수행할 수 있습니다.
- 선출 모듈: 배포된 DataKit이 매우 많은 경우 사용자는 모든 DataKit의 구성을 동일하게 만든 다음 자동화된 일괄 배포를 통해 각 DataKit에 구성을 전달할 수 있습니다. 선출 모듈의 의미는 클러스터 내에서 특정 데이터(예: Kubernetes 클러스터 메트릭) 수집은 하나의 DataKit만 수행해야 한다는 것입니다(그렇지 않으면 데이터가 중복되고 수집 대상에 부하가 발생합니다). 클러스터의 모든 DataKit 구성이 동일한 경우 선출 모듈을 통해 언제든지 최대 하나의 DataKit만 수집을 수행하도록 할 수 있습니다.
- 문서 모듈: DataKit 문서는 설치 시 함께 제공됩니다. 사용자는 http://localhost:9529/man 페이지에서 문서 목록에 접근할 수 있으며 명령줄에서도 문서를 볼 수 있습니다.
- 전송 레이어: 거의 모든 데이터의 입력과 출력을 담당합니다.
- HTTP 서비스 모듈: DataKit은 Telegraf/Prometheus 등 타사 데이터 연동을 지원하며, 향후 더 많은 데이터 소스를 연동할 수 있습니다. 현재 이러한 데이터는 모두 HTTP를 통해 연동됩니다.
- IO 모듈: 각 데이터 수집 플러그인은 수집 완료 시마다 데이터를 IO 모듈로 전송합니다. IO 모듈은 통합된 데이터 구성, 처리 및 전송 인터페이스를 캡슐화하여 각 수집기 플러그인이 수집한 데이터를 연동하기 쉽게 합니다. 또한 IO 모듈은 일정한 주기(정기적, 정량적)로 HTTP(s)를 통해 DataWay에 데이터를 전송합니다.
- 수집 레이어: 다양한 데이터 수집을 담당합니다. 수집 유형에 따라 두 가지로 나뉩니다.
- 능동 수집형: 이 유형의 수집기는 구성된 고정 주기에 따라 수집합니다. 예: CPU, NIC 트래픽, 클라우드 신서틱 테스트 등
- 수동 수집형: 이 유형의 수집기는 일반적으로 외부 데이터 입력을 통해 수집을 구현합니다. 예: RUM, Tracing 등. 일반적으로 DataKit 외부에서 실행되며, DataKit이 제공하는 데이터 업로드 API를 통해 데이터를 일정 수준 표준화 처리한 후 Guance로 업로드합니다.
Guance 플랫폼
강력한 데이터 수집 능력을 기반으로 Guance는 인프라, 컨테이너, 미들웨어, 데이터베이스, 메시지 큐, 애플리케이션 링크, 프런트엔드 액세스, 시스템 보안, 네트워크 액세스 성능에 이르는 전 링크 관측 가능성을 구축했습니다. Guance 표준 제품을 기반으로 사용자가 DataKit 수집을 올바르게 구성하면 프로젝트의 완전한 관측 가능성을 빠르게 구축할 수 있습니다. 또한 Line Protocol과 Guance의 시나리오 구축 능력을 기반으로 사용자가 직접 관측에 필요한 메트릭을 정의하고 편리하게 통합하여 더 확장된 관측 가능성을 실현할 수 있습니다.
Guance는 관측 가능성을 위한 완전한 기술 제품으로서 기술적 진입 장벽이 많습니다. 다양한 오픈소스 솔루션과 비교하여 Guance는 처음부터 사용자의 제품 학습 비용을 효과적으로 낮추고 사용 편의성을 높이는 것을 강조합니다. 따라서 DataKit의 설치 배포부터 모든 구성 가능한 기능까지 Guance는 사용자의 구성 난이도를 낮추는 방향을 선택하여 대부분의 프로그래머와 운영 엔지니어의 습관에 부합하도록 했으며, 동시에 전체 UI의 사용 편의성과 전문성을 높여 사용자가 제품의 용도와 가치를 빠르게 이해할 수 있게 합니다.
실행 플랫폼 비교
Logstash의 원래 장점 중 하나는 JRuby로 작성되어 Windows에서 실행할 수 있다는 것입니다.
Fluentd는 최근에야 Windows를 지원하기 시작했습니다. Linux 플랫폼 중심의 이벤트 라이브러리에 더 이상 의존하지 않게 되면서 Fluentd는 이제 Windows를 지원합니다. 또한 in_windows_eventlog 플러그인을 사용하여 Windows 이벤트 로그를 추적할 수도 있습니다.
DataKit은 Guance 제품에서 공식 제공하는 데이터 수집기로, 다양한 데이터 소스 수집 스크립트가 내장되어 있으며 여러 데이터 연동을 지원합니다. Windows, Linux, Mac 운영 체제와 ARM, X86 등 다양한 시스템 유형을 지원하며 로그 수집에 있어 전 플랫폼 호환성을 제공합니다.
Logstash
Linux and Windows
Fluentd
Linux and Windows
DataKit
전체 플랫폼 지원, 클라이언트에서 시각적으로 구성을 관리할 수 있어 설치 배포 및 복잡한 구성의 학습 비용을 크게 절감
이벤트 라우팅 비교
이벤트 라우팅 구성에 있어 Fluentd의 방식은 선언적(declarative)인 반면 Logstash의 방식은 절차적(procedural)입니다. 따라서 절차적 프로그래밍 교육을 받은 개발자는 Logstash 구성이 더 배우기 쉽다고 느낄 수 있습니다. 또한 Fluentd의 태그 기반 라우팅은 복잡한 라우팅을 명확하게 표현할 수 있습니다. 반면 Guance는 완성된 제품 로직과 강력한 제품 컴포넌트를 기반으로 이벤트 알림, 데이터 탐색 등의 기능을 위해 다른 제품에 의존할 필요 없이 관측의 완전한 순환을 실현할 수 있습니다. 이를 통해 데이터 보안을 보장하면서도 복잡한 구성을 피해 탁월한 사용자 경험을 제공합니다.
Logstash 이벤트 라우팅
Logstash는 모든 데이터를 하나의 스트림으로 라우팅한 다음 if-then 문을 사용하여 원하는 대상으로 보냅니다. 다음은 프로덕션 환경의 오류 이벤트를 PagerDuty로 전송하는 예시입니다.
Fluentd 이벤트 라우팅
Fluentd는 태그에 의존하여 이벤트를 라우팅합니다. 모든 Fluentd 이벤트에는 어디로 라우팅할지 알려주는 태그가 있습니다. 프로덕션 환경에서 오류 이벤트를 PagerDuty로 전송하는 구성은 다음과 같습니다.
<source>
  @type forward
</source>

<filter app.**>
  @type record_transformer
  <record>
    hostname "#{Socket.gethostname}"
  </record>
</filter>

<match app.**>
  @type file
  # ...
</match>
DataKit 프록시
DataKit은 Guance의 강력한 제품 컴포넌트 중 하나로서 데이터를 직접 클라우드의 Guance 플랫폼으로 전송하여 관측 및 분석을 수행하므로, LogStash나 Fluentd처럼 이벤트 라우팅을 구성하여 데이터를 다른 도구로 전달해 분석, 캐시 등의 작업을 할 필요가 없습니다. 물론 DataKit은 사용자 데이터의 안전성을 보장하고, 인터넷에 접속할 수 없는 내부 네트워크 환경에 배포된 DataKit이 프록시 서버를 통해 인터넷에 접속해야 하는 상황을 해결하기 위해 프록시 구성을 제공합니다. DataKit의 프록시 구성은 프록시 옵션만 활성화하면 되는 매우 간단한 방식으로, 간단한 설정만으로 다양한 제품 기능을 경험할 수 있습니다.
플러그인 생태계 비교
Logstash, Fluentd, DataKit 모두 다양한 입력 시스템(파일, TCP/UDP 등)과 필터(필드별 분할 및 필터링)를 포함하는 풍부한 플러그인 생태계를 보유하고 있습니다.
Logstash 플러그인
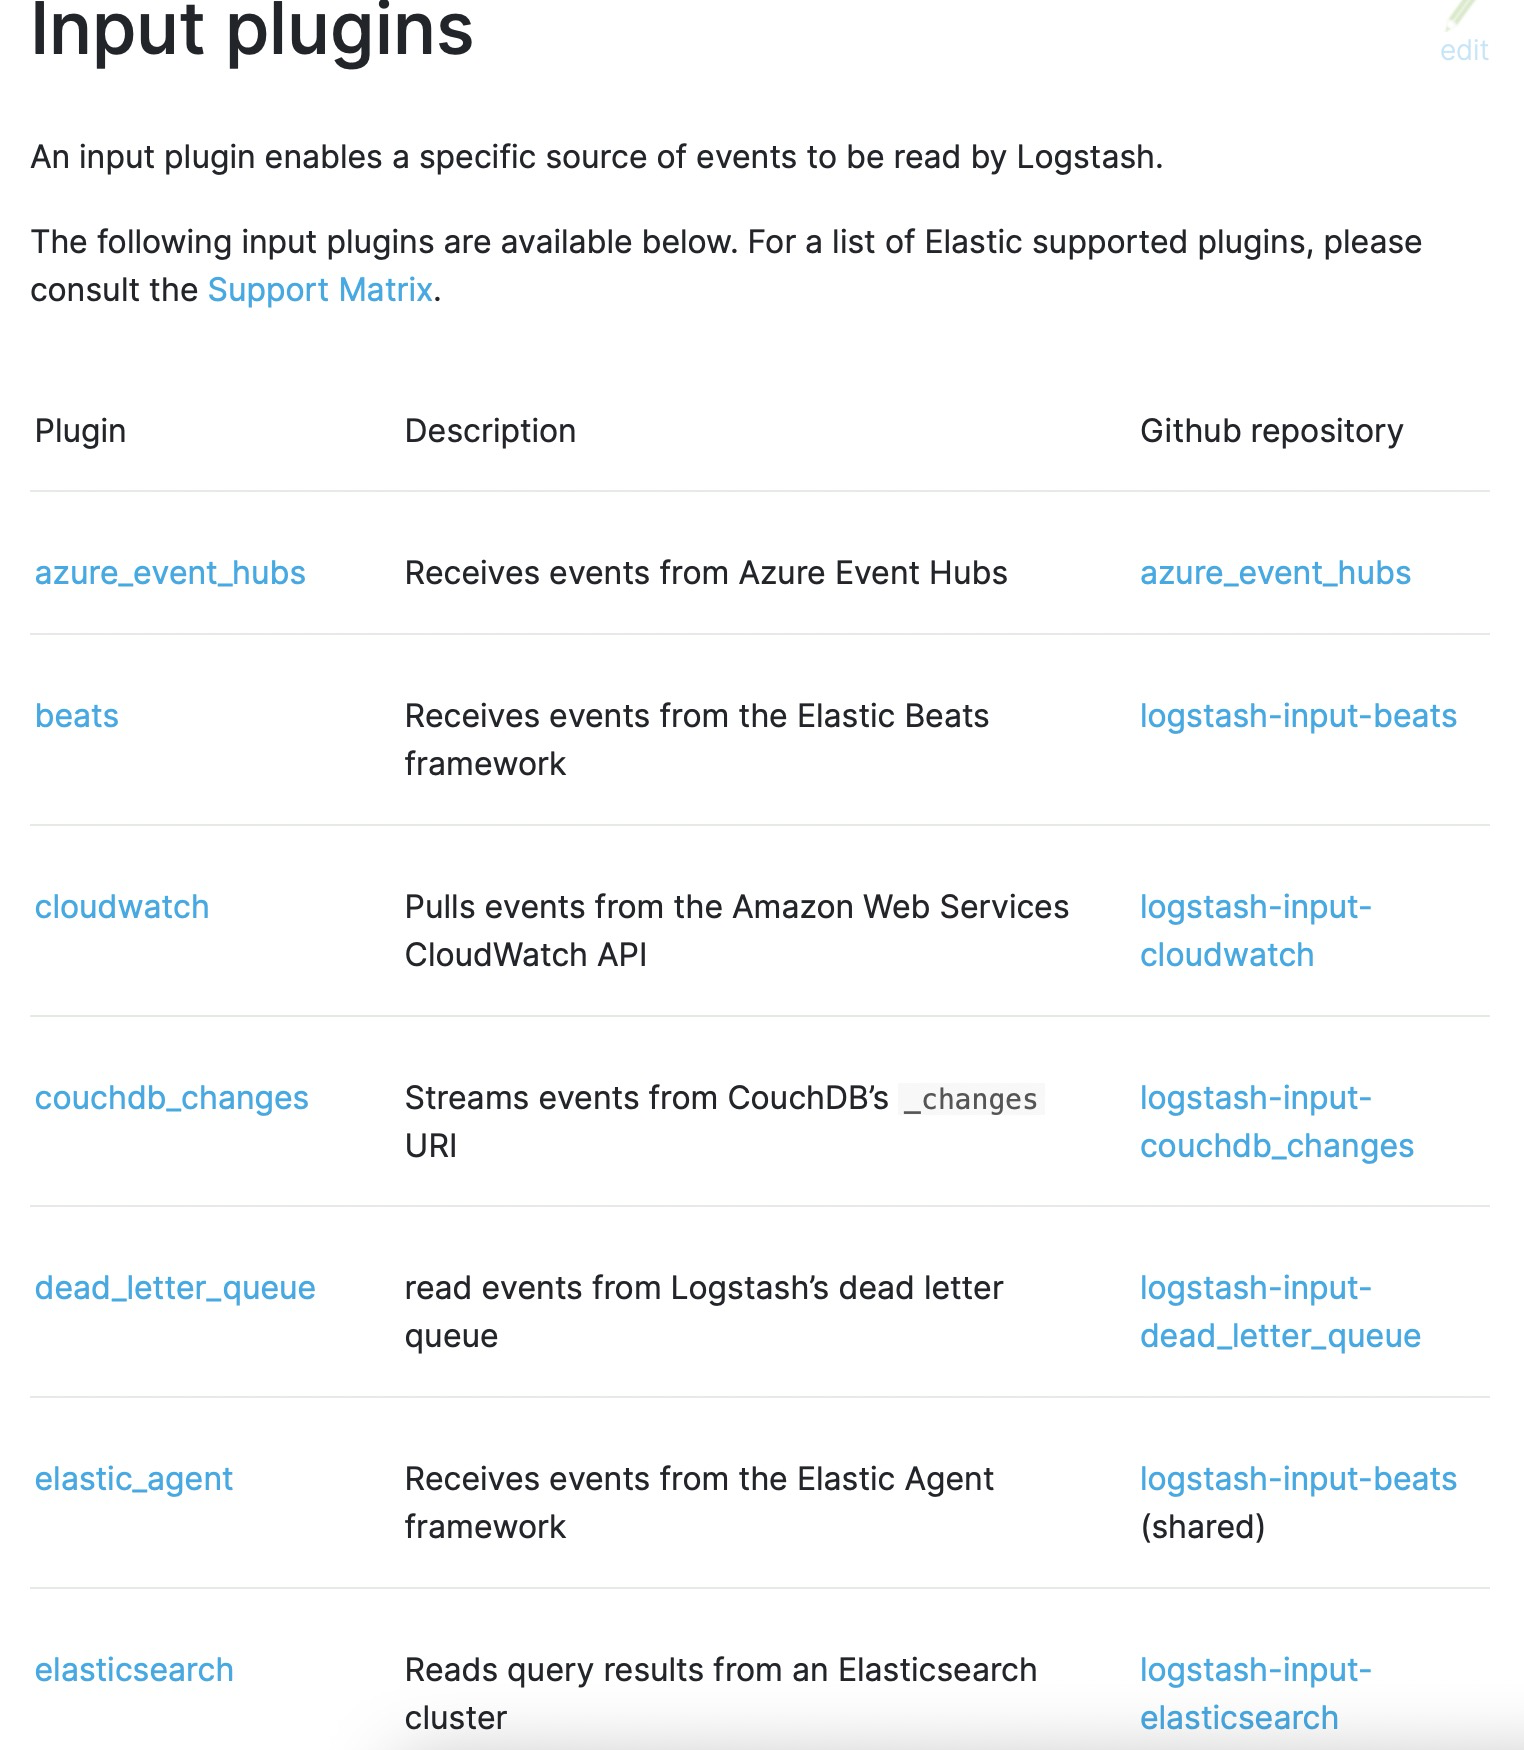
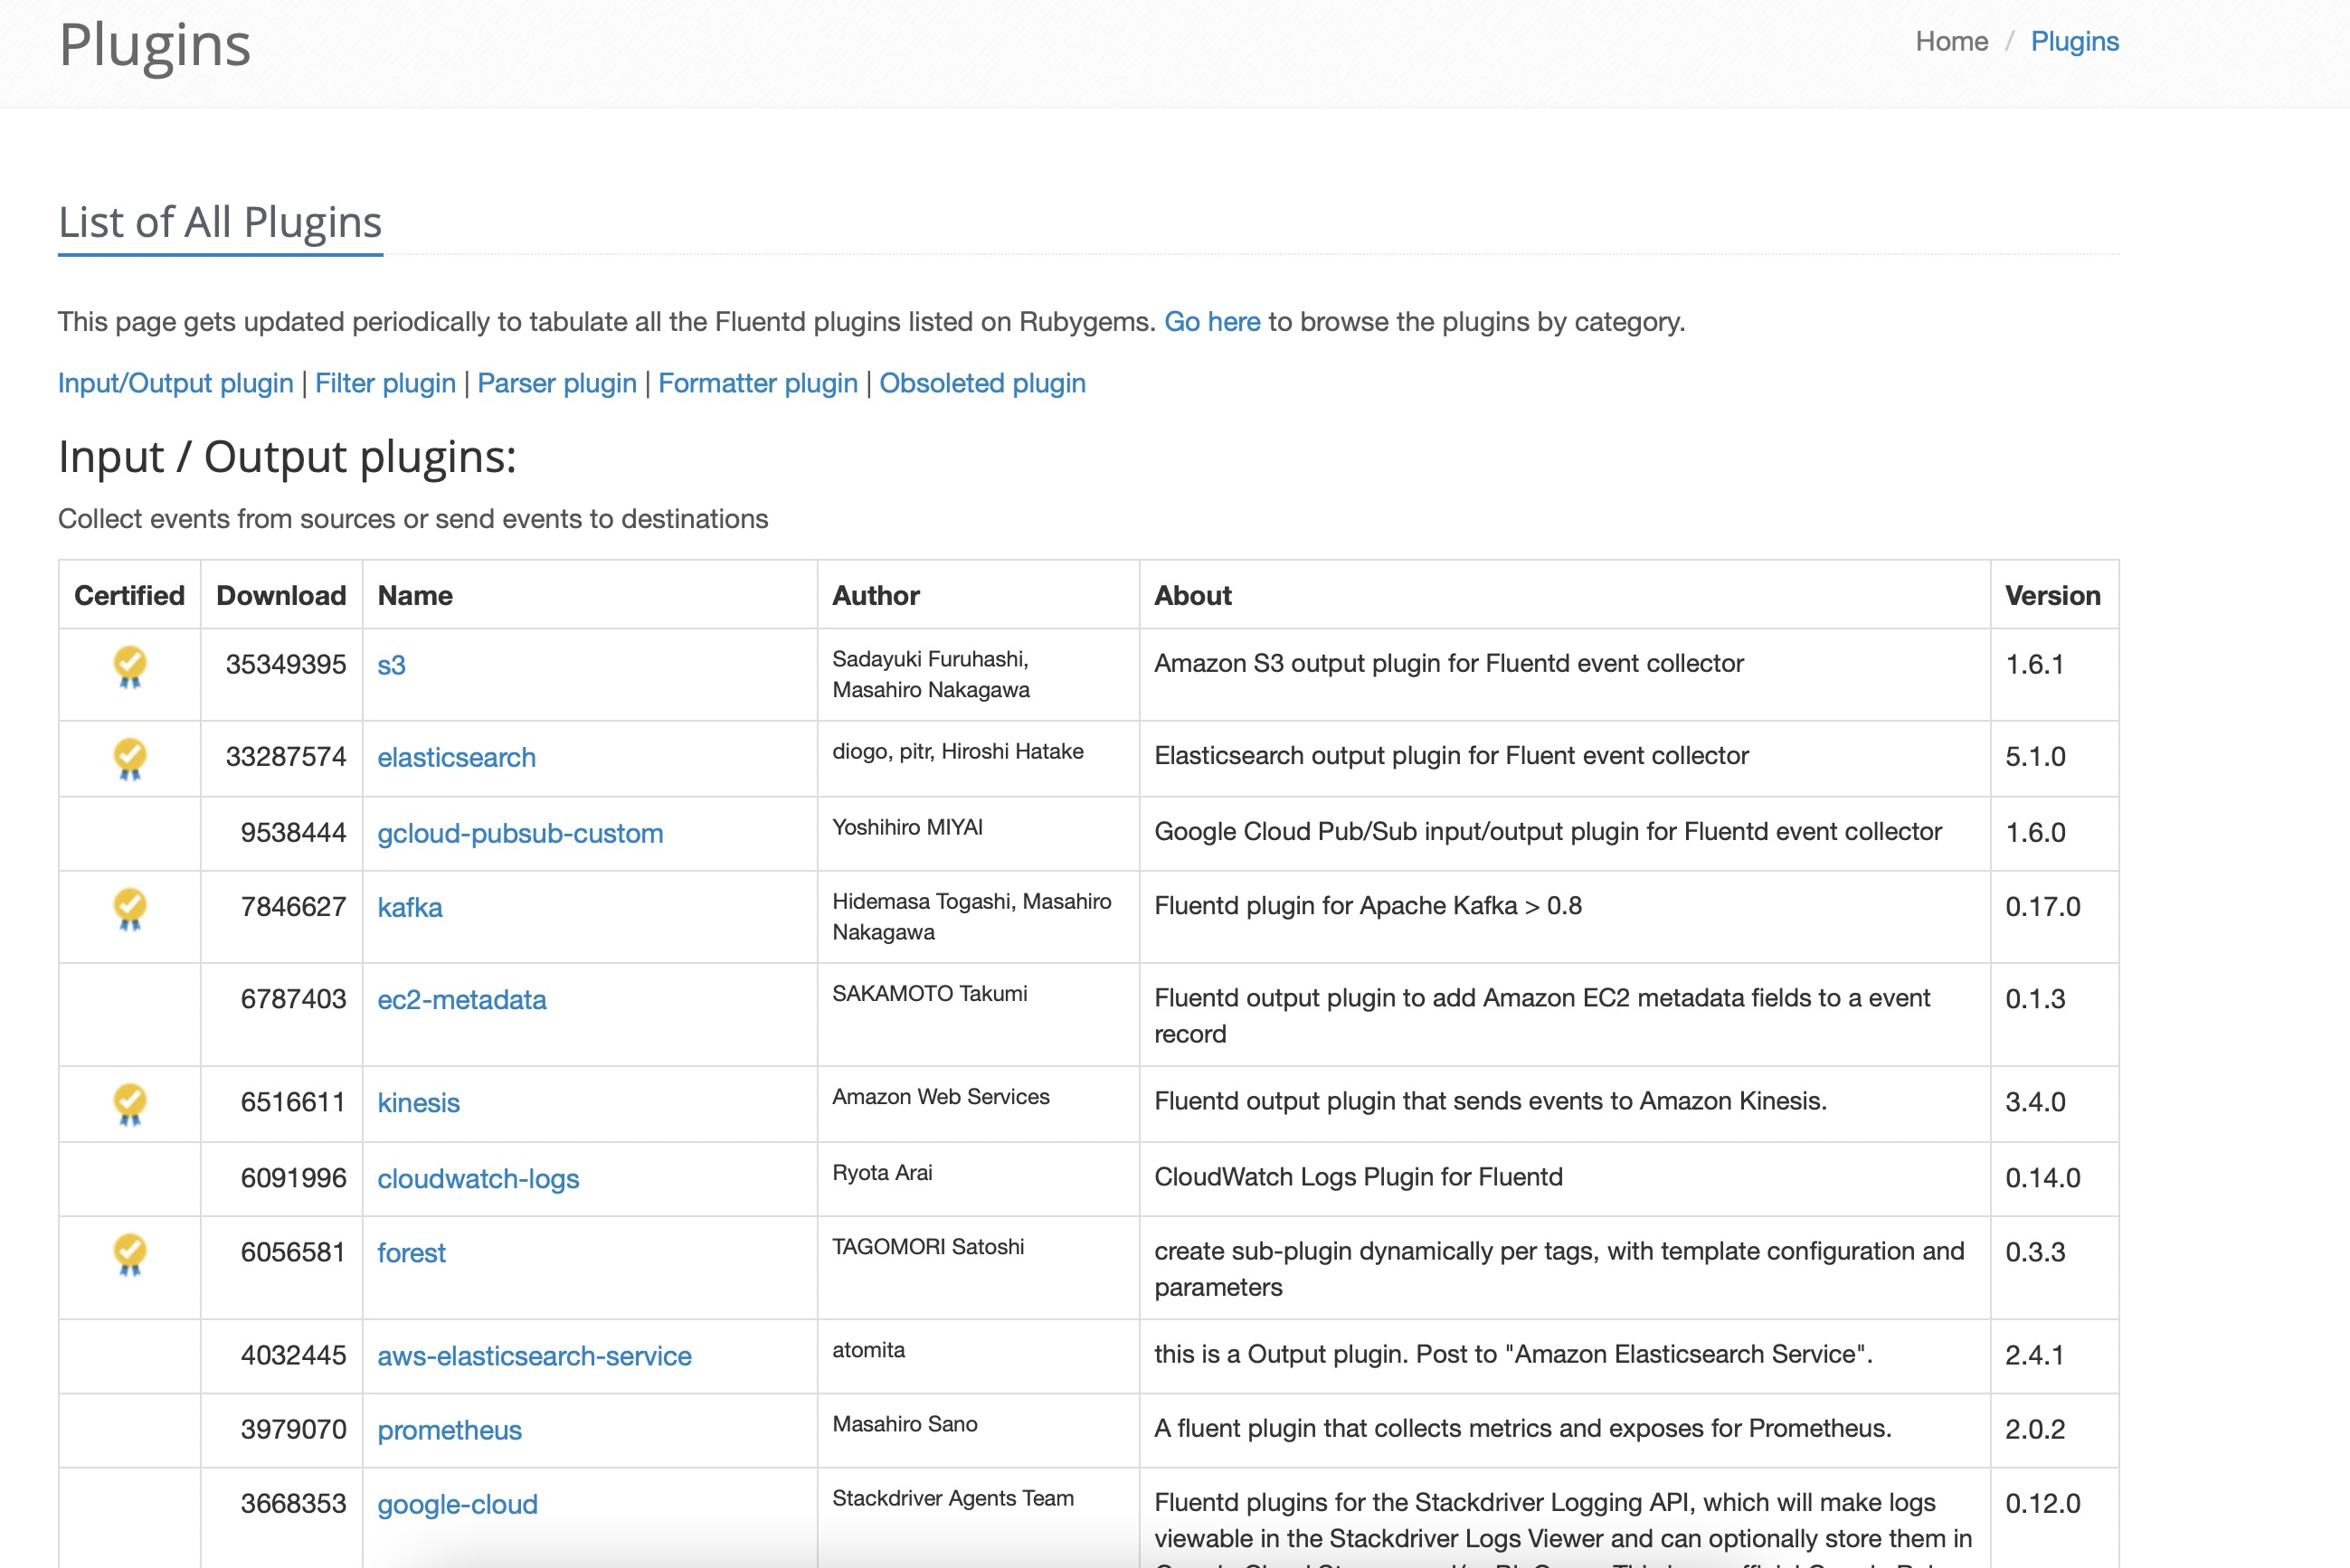
Logstash는 GitHub 저장소에서 모든 플러그인을 관리하며 inputs, filter, output 플러그인이 총 200개 이상입니다. 사용자들이 공동으로 유지보수하고 있으며 공식적인 유지보수 호스팅이 부족합니다.
Fluentd 플러그인
Fluentd에는 입력, 파서, 필터, 출력, 포맷터, 저장소, 서비스 디스커버리, 버퍼 등 8가지 유형의 플러그인이 포함되어 있으며 총 500개 이상의 플러그인이 있습니다. 그러나 공식적으로 호스팅되는 플러그인은 10개뿐이며, 나머지는 사용자들이 공동으로 유지보수하므로 공식 유지보수 호스팅과 기술 스택 지원이 부족합니다.
DataKit 플러그인
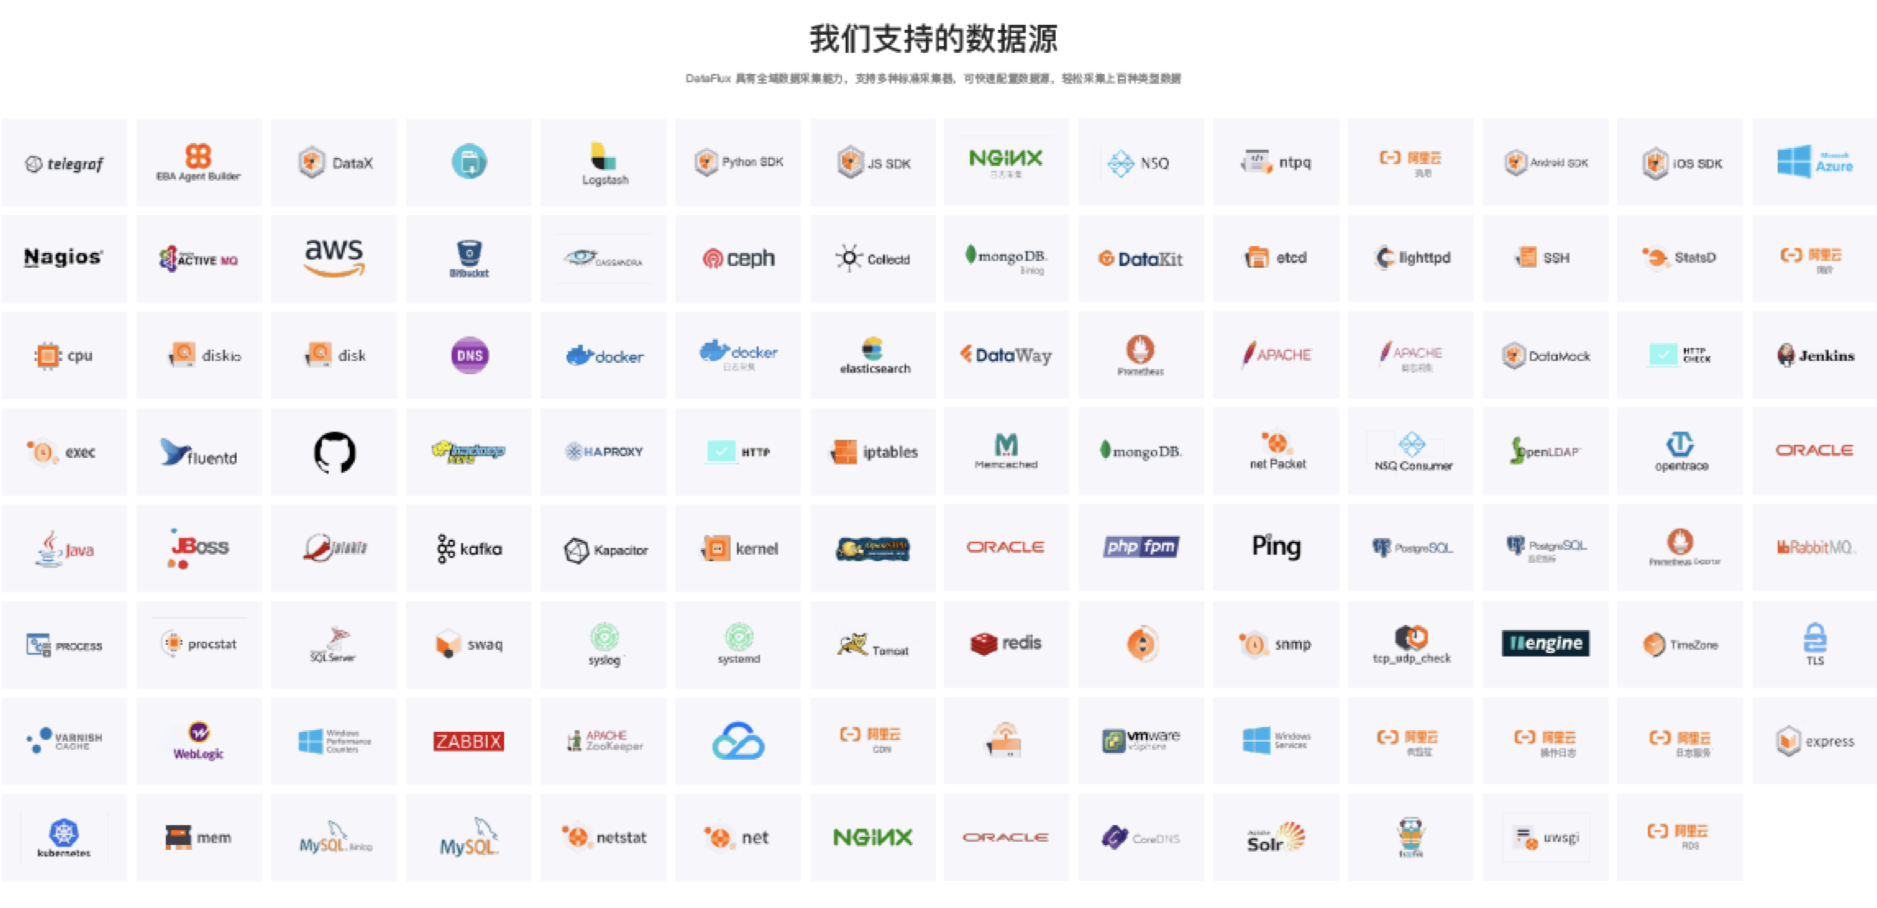
DataKit은 동적 grok 문법 쿼리 디버깅, 자체 개발 문법 DQL 기반의 빠른 데이터 쿼리, 실시간 inputs 수집 실행 관측, 엣지 컴퓨팅 능력, 시각화 클라이언트 방식의 구성 및 수집 소스 배포 등 강력한 내장 기능을 포함합니다. 또한 200개 이상의 공식 유지보수 데이터 소스 연동과 기술 스택 지원을 제공하며 Telegraf, Beats, Logstash, Fluentd 등 다양한 외부 데이터 연동과도 호환됩니다. 사용자에게 더욱 친숙한 것은 클라이언트에서 시각적으로 플러그인과 에이전트를 관리하고 데이터 수집 상황을 실시간으로 확인할 수 있다는 점입니다.
큐 비교
Logstash는 지속성이 있는 내부 메시지 큐가 부족합니다. 현재 Logstash에는 20개의 이벤트를 수용할 수 있는(고정 크기) 메모리 큐가 있으며, 재시작 시 영구 저장을 위해 Redis와 같은 외부 큐에 의존합니다. Fluentd에는 메모리 또는 디스크에 저장할 수 있는 구성 가능한 버퍼 시스템이 있지만, 안정성을 구성하는 것은 비교적 복잡할 수 있습니다. DataKit에는 내장 캐시 메커니즘이 있어 서버 구성에 따라 간단한 파라미터만 변경하면 데이터 캐시 효과를 얻을 수 있습니다.
Logstash 큐
Logstash는 내장 지속성 메시지 큐가 부족합니다. 내장 큐 모델이 매우 단순하므로 지속성을 보장하려면 Redis와 같은 외부 큐가 필요합니다.
Fluentd 큐
Logstash와 비교하여 Fluentd는 내장된 안정성을 제공하지만 구성이 비교적 복잡하여 사용자의 학습 비용이 상당히 높습니다.
DataKit 큐
DataKit에는 내장 캐시 메커니즘이 있습니다. DataKit이 배포된 서버가 네트워크 문제로 DataWay 전송에 실패하면 DataKit은 기본적으로 최대 1,000개 포인트의 데이터를 캐시하여 데이터 손실을 방지합니다. DataKit 구성 파일을 수정하여 최대 캐시 용량을 제어할 수도 있습니다. 구성이 간단하고 사용 진입 장벽이 낮아 학습 비용이 거의 0입니다.
로그 파싱 비교
로그 분석은 기업 내부에서 매우 기초적이고 핵심적인 기술로, 보안 팀뿐만 아니라 IT 개발 팀과 비즈니스 팀에서도 활용됩니다. 보안 측면에서 보안 팀이 로그 분석을 수행하는 주요 목적은 알려지지 않은 보안 이벤트를 발견하고, 알려진 보안 이벤트에 대한 출처 분석을 수행하는 것입니다. 또 다른 중요한 목적은 국가 차원의 규제 컴플라이언스 요구사항입니다. IT 개발 측면에서 기업 내부의 비보안 기술 팀이 로그 분석을 수행하는 목적도 주로 문제를 발견하고 알려진 문제를 분석하는 것이며, 주로 시스템 모니터링, APM(APM은 개발 팀이 관심을 두는 모든 모니터링 항목을 포함)에 집중됩니다. 비즈니스 측면에서 비즈니스 팀의 로그 분석 요구는 주로 리스크 관리, 운영 마케팅, 사용자 페르소나, 웹사이트 페르소나 등에 집중됩니다. 따라서 하드디스크에 저장된 로그는 그 자체로는 가치가 없으며, 로그 분석 기술을 통해 로그 정보의 가치를 실현할 수 있습니다. 로그 가치 구현 수준이 높을수록 회사의 기술 역량을 반영하기도 합니다.
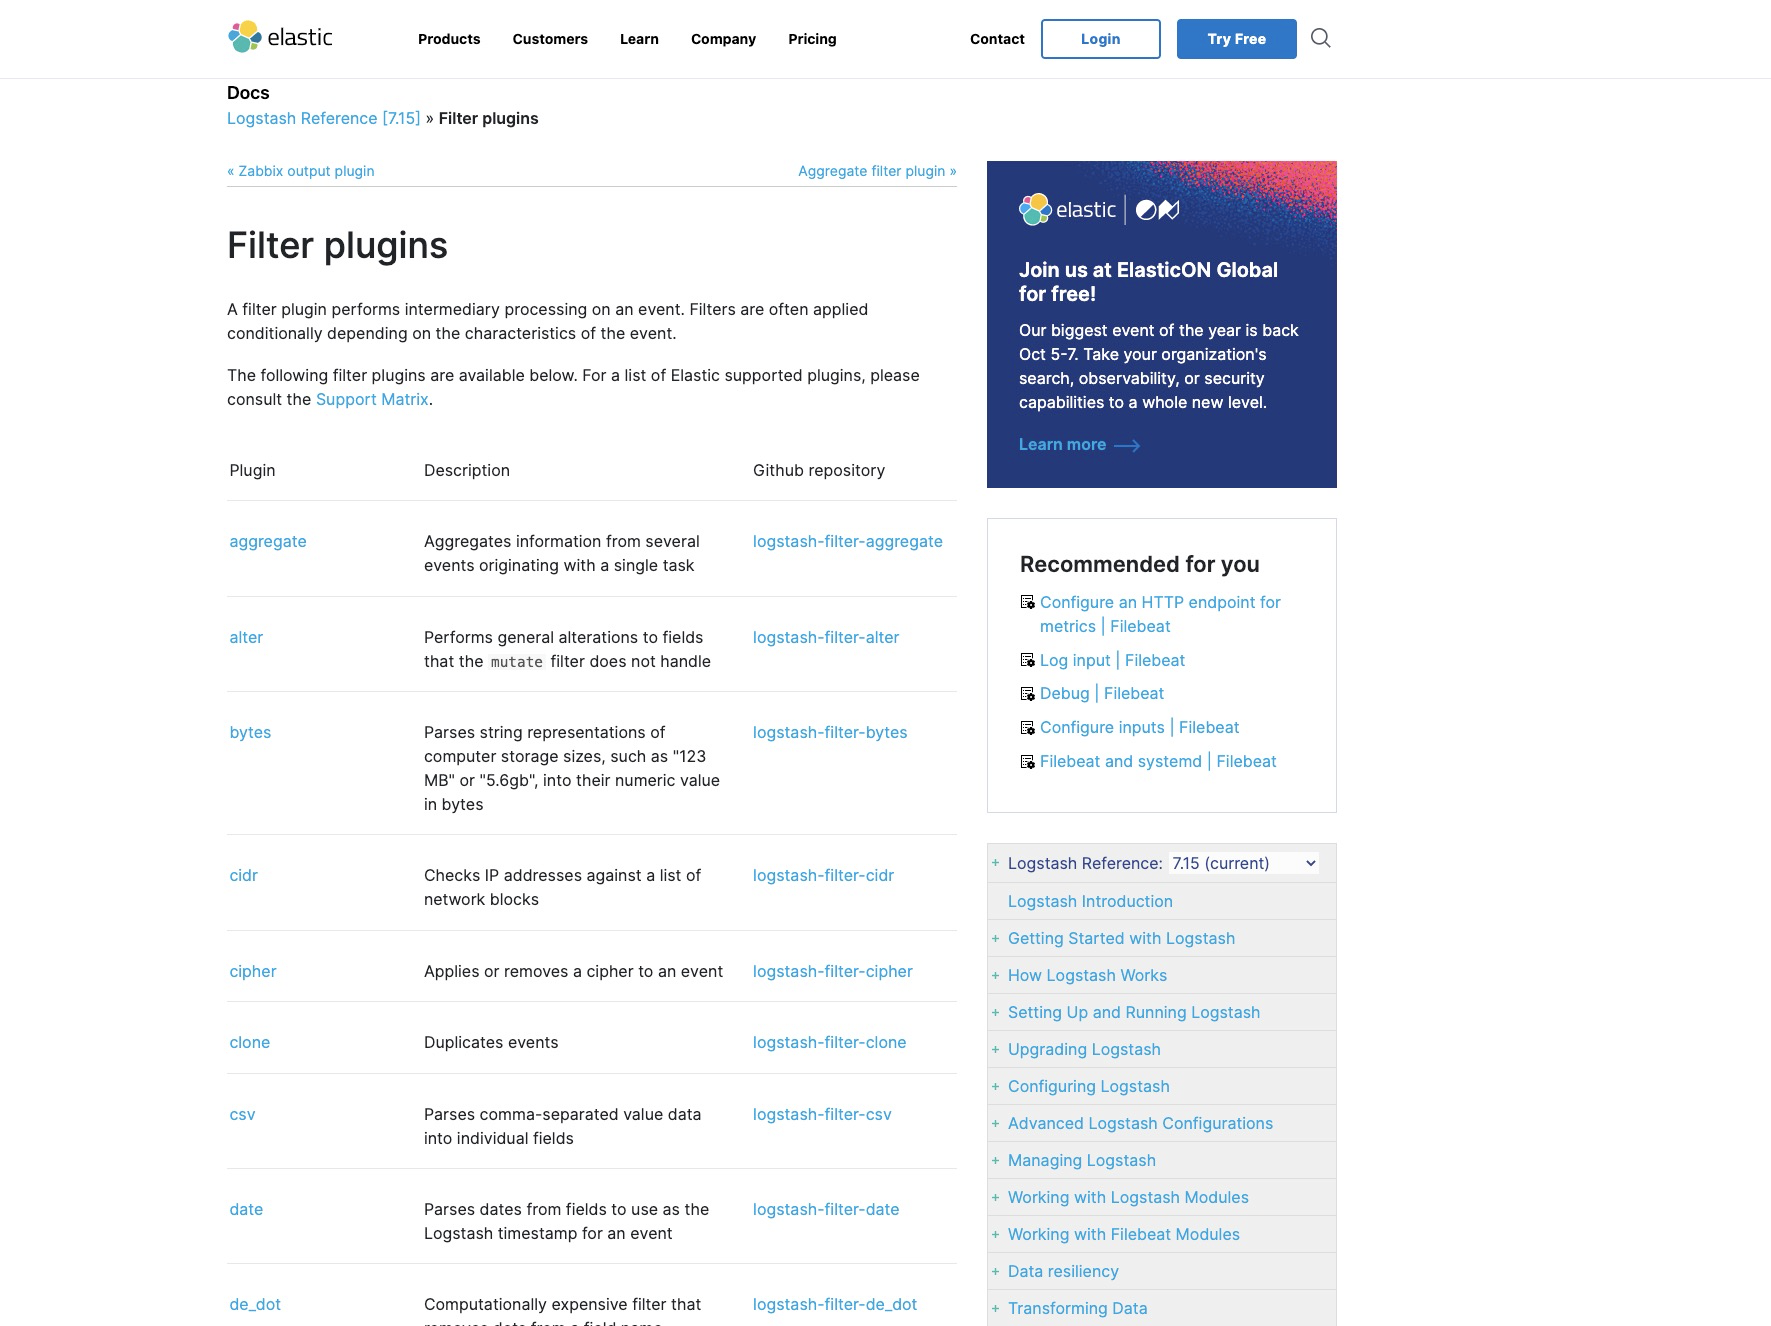
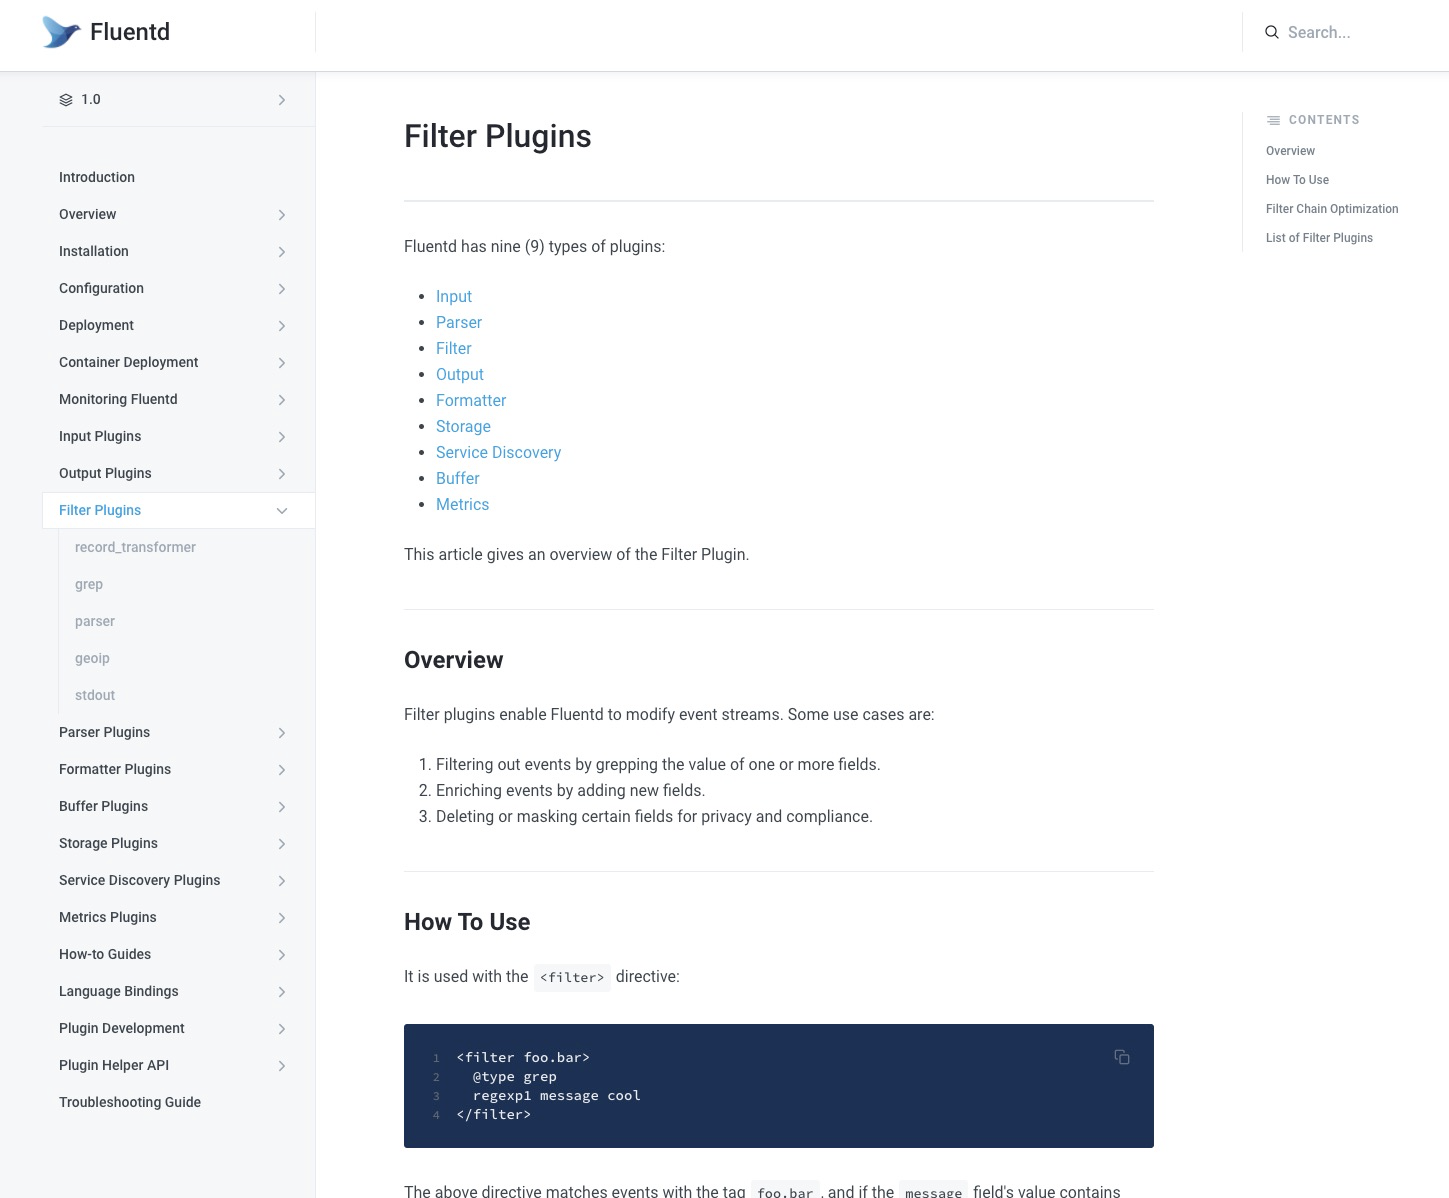
일반적으로 사용되는 Logstash에는 grok을 통한 임의 텍스트 파싱 및 구성, mutate를 통한 이벤트 필드 일반 변환, drop을 통한 이벤트 완전 삭제, clone을 통한 이벤트 복사본 생성, geoip를 통한 IP 주소의 지리적 위치 정보 추가 등의 일반적인 파서가 포함됩니다. Fluentd의 로그 파싱 일반 작업으로는 하나 이상의 필드 값을 검색하여 이벤트 필터링, 새 필드 추가로 이벤트 보강, 개인정보 보호 및 컴플라이언스를 위한 특정 필드 삭제 또는 마스킹 등이 있습니다. 그러나 관련 플러그인은 상대적으로 적어 record_transformer, filter_stdout, filter_grep, parser, filter_geoip의 5개뿐입니다. DataKit의 로그 파싱에는 비정형 텍스트 데이터를 파싱하거나 JSON과 같은 정형 텍스트에서 일부 정보를 추출하는 Pipeline, glob 규칙을 사용한 더 편리한 로그 파일 지정, 자동 발견 및 파일 필터링, grok 사용 진입 장벽을 낮추는 사용하기 쉬운 대화형 Grok 매칭 도구, 데이터 형식을 더 유연하게 만드는 다양한 스크립트 함수 등 더 많은 기능이 포함됩니다.
Logstash 로그 파싱
Grok은 현재 Logstash에서 비정형 로그 데이터를 정형화되고 쿼리 가능한 콘텐츠로 파싱하는 가장 좋은 방법입니다. 현재 Logstash에는 120가지 grok 파싱 템플릿이 내장되어 있지만, Logstash가 GitHub 저장소에서 관리하는 grok 파싱 템플릿은 사용자들이 공동으로 유지보수하므로 공식 기술 지원이 부족합니다. grok 템플릿 성능 튜닝을 포함한 많은 비즈니스 요구사항을 사용자가 직접 해결해야 합니다.
Fluentd 로그 파싱
Fluentd의 로그 파싱 방식은 Logstash와 유사하지만 구성 방식이 더 유연합니다. 그러나 grok 파싱 템플릿을 제공하지 않고 일부 구성 예시만 제공하므로, 사용자가 문서의 예시를 참고하여 파싱 기능을 직접 구성해야 합니다. 상대적으로 진입 장벽이 높으며, 구성 과정에서 발생하는 문제에 대한 기술 지원이 부족하여 사용자가 직접 검색하여 해결해야 하는 경우가 많습니다.
동일하게 구성된 서버 환경에서 Nginx의 access log를 예로 들면, 다음 한 줄의 로그는 365바이트이며 14개 필드로 구조화됩니다.
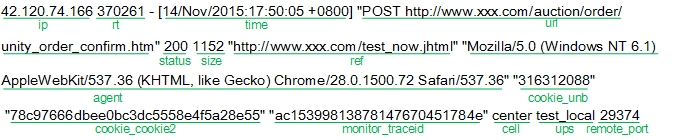
이어지는 테스트에서는 서로 다른 부하를 시뮬레이션하여 이 로그를 파일에 반복 기록합니다. 각 로그의 time 필드는 현재 시스템 시간을 사용하며 나머지 13개 필드는 동일합니다.
실제 시나리오와 비교하여 시뮬레이션 시나리오는 로그 파싱에 있어 차이가 없습니다. 한 가지 차이점은 높은 데이터 압축률이 네트워크 출력 트래픽을 줄인다는 것입니다.
Logstash
Logstash 7.1.0 버전, grok으로 로그를 파싱하고 kafka에 기록(내장 플러그인, gzip 압축 활성화).
로그 파싱 구성:
grok {
patterns_dir=> "/home/admin/workspace/survey/logstash/patterns"

match=>{ "message"=>"%{IPORHOST:ip} %{USERNAME:rt} -
\"%{WORD:method} %{DATA:url}\" %{NUMBER:status} %{NUMBER:size} \"%{DATA:ref}\" \"%{DATA:agent}\" \"%{DATA:cookie_unb}\" \"%{DATA:cookie_cookie2}\" \"%{DATA:monitor_traceid}\" %{WORD:cell} %{WORD:ups} %{BASE10NUM:remote_port}" }

remove_field=>[ "message"]
}
테스트 결과:
| 쓰기 TPS | 쓰기 트래픽(KB/s) | CPU 사용률(%) | 메모리 사용량(MB) |
|---|---|---|---|
| 500 | 178.89 | 25.3 | 432 |
| 1000 | 346.65 | 46.9 | 476 |
| 5000 | 1882.23 | 231.1 | 489 |
| 10000 | 3564.45 | 511.2 | 512 |
Fluentd
td-agent 4.1.0 버전, 정규식을 통해 로그를 파싱하고 kafka에 기록(타사 플러그인 fluent-plugin-kafka, gzip 압축 활성화).
로그 파싱 구성:
<source>
type tail
format /^(? <ip>\S+)\s(?<rt>\d+)\s-\s\[(?<time>[^\]]*)\]\s"(?<url>[^\"]+)"\s(?<status>\d+)\s(?<size>\d+)\s"(?<ref>[^\"]+)"\s"(?<agent>[^\"]+)"\s"(?<cookie_unb>\d+)"\s"(?<cookie_cookie2>\w+)"\s"(?
<monitor_traceid>\w+)"\s(?<cell>\w+)\s(?<ups>\w+)\s(?<remote_port>\d+).*$/
time_format %d/%b/%Y:%H:%M:%S %z
path /home/admin/workspace/temp/mock_log/access.log
pos_file /home/admin/workspace/temp/mock_log/nginx_access.pos
tag nginx.access
</source>
테스트 결과:
| 쓰기 TPS | 쓰기 트래픽(KB/s) | CPU 사용률(%) | 메모리 사용량(MB) |
|---|---|---|---|
| 500 | 174.272 | 13.8 | 58 |
| 1000 | 336.85 | 24.4 | 61 |
| 5000 | 1771.43 | 95.3 | 103 |
| 10000 | 3522.45 | 140.2 | 140 |
DataKit
DataKit 1.1.8-rc3, Pipeline을 통해 비정형 텍스트 데이터를 파싱합니다.
# access log
grok(_, "%{NOTSPACE:ip} %{NOTSPACE:rt} - "%{NOTSPACE:method} %{NOTSPACE:url}\" %{NOTSPACE:status} %{NOTSPACE:size} \"%{NOTSPACE:ref}\" \"%{NOTSPACE:agent}\" \"%{NOTSPACE:cookie_unb}\" \"%{NOTSPACE:cookie_cookie2}\" \"%{NOTSPACE:monitor_traceid}\" %{NOTSPACE:cell} %{NOTSPACE:ups} %{NOTSPACE:remote_port}")

cast(status_code, "int")
cast(bytes, "int")

default_time(time)
테스트 결과:
| 쓰기 TPS | 쓰기 트래픽(KB/s) | CPU 사용률(%) | 메모리 사용량(MB) |
|---|---|---|---|
| 500 | 178.24 | 8.5 | 41 |
| 1000 | 356.45 | 13.8 | 45 |
| 5000 | 1782.23 | 71.1 | 76 |
| 10000 | 3522.45 | 101.2 | 88 |
로그 수집 아키텍처 비교
ELK 구성 방안
방안 1
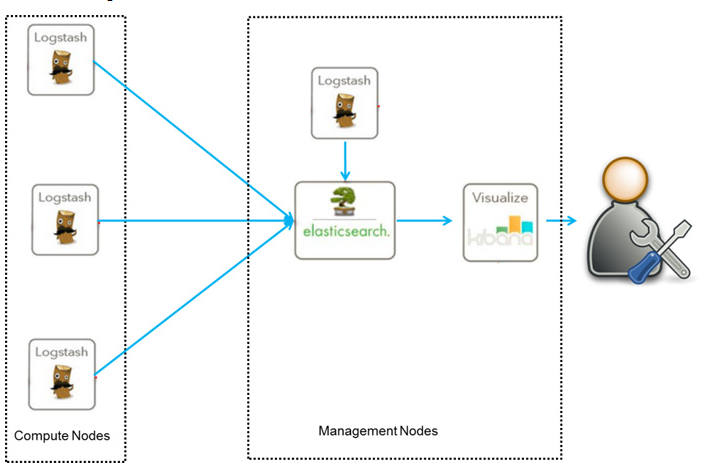
가장 간단한 ELK 아키텍처 방식입니다. 장점은 구축이 간단하고 익히기 쉽다는 점입니다. 단점은 Logstash의 리소스 소모가 크고 실행 시 CPU와 메모리 사용량이 높다는 점입니다. 또한 메시지 큐 캐시가 없어 데이터 손실 위험이 있습니다. 사용자가 Logstash, ElasticSearch, Kibana를 충분히 능숙하게 다룰 수 있어야 다양한 복잡한 비즈니스 문제를 해결할 수 있으며, LogStash 클러스터와 ElasticSearch 클러스터의 유지보수 담당자도 클러스터 성능 최적화와 리소스 관리에 충분히 능숙해야 비즈니스가 정상적으로 운영될 수 있습니다.
이 아키텍처는 Logstash를 각 노드에 배포하여 관련 로그와 데이터를 수집하고, 분석 및 필터링을 거친 후 원격 서버의 Elasticsearch로 전송하여 저장합니다. Elasticsearch는 데이터를 샤드 형태로 압축 저장하고 사용자가 조회하고 조작할 수 있는 다양한 API를 제공합니다. 사용자는 Kibana Web을 구성하여 더 직관적으로 로그를 조회하고 데이터를 기반으로 보고서를 생성할 수도 있습니다.
방안 2
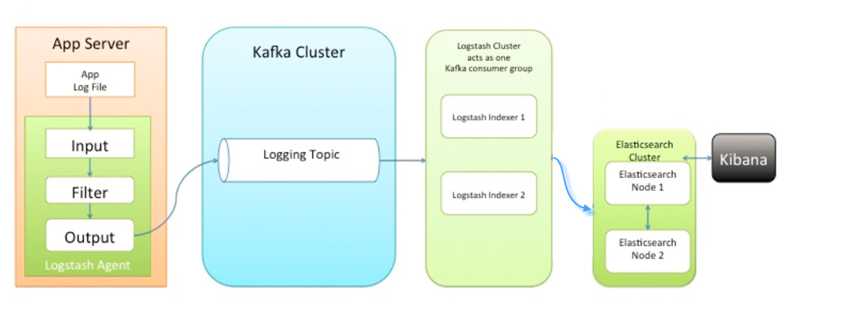
비교적 성숙한 ELK 아키텍처입니다. 장점은 Kafka를 도입하여 원격 Logstash 클러스터가 장애로 중단되더라도 데이터가 먼저 저장되어 데이터 손실을 방지한다는 점입니다. 단점은 구축이 복잡하고 기술 스택이 복잡하여 빠르게 익히기 어렵다는 점이며, Logstash의 리소스 소모가 크고 실행 시 CPU와 메모리 사용량이 높다는 점입니다. 또한 Kafka 클러스터를 추가로 유지보수해야 하며, 대규모 환경에서는 Zookeeper 클러스터를 추가로 유지보수해야 할 수도 있습니다. 사용자가 Logstash, ElasticSearch, Kafka, Kibana를 충분히 능숙하게 다룰 수 있어야 다양한 복잡한 비즈니스 문제를 해결할 수 있으며, LogStash 클러스터, Kafka 클러스터, ElasticSearch 클러스터의 유지보수 담당자도 클러스터 성능 최적화와 리소스 관리에 충분히 능숙해야 비즈니스가 정상적으로 운영될 수 있습니다.
이 아키텍처는 메시지 큐 메커니즘을 도입했습니다. 각 노드에 있는 Logstash Agent가 먼저 데이터/로그를 Kafka(또는 Redis)로 전달하고, 큐의 메시지나 데이터는 간접적으로 Logstash로 전달됩니다. Logstash가 필터링과 분석을 거친 후 데이터를 Elasticsearch로 전달하여 저장합니다. 마지막으로 Kibana가 로그와 데이터를 사용자에게 표시합니다. Kafka(또는 Redis)를 도입했기 때문에 원격 Logstash 서버가 장애로 중단되더라도 데이터가 먼저 저장되어 데이터 손실을 방지합니다.
EFK 구성 방안
방안 1
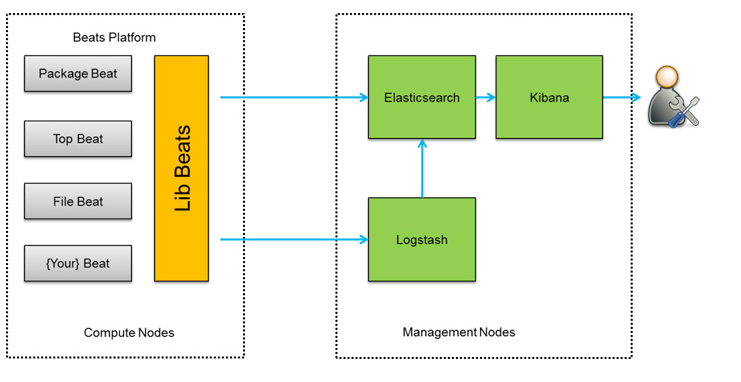
더 유연한 EFK 아키텍처입니다. 장점은 더 유연하고 Logstash에 비해 리소스 소모가 적으며 확장성이 더 뛰어나다는 점입니다. 단점은 로그를 LogStash 클러스터로 전송하여 집중 처리하려면 대규모 LogStash 클러스터의 컴퓨팅 성능 지원이 필요하다는 점이며, 사용자가 Logstash, ElasticSearch, Kibana를 충분히 능숙하게 다룰 수 있어야 다양한 복잡한 비즈니스 문제를 해결할 수 있고, LogStash 클러스터와 ElasticSearch 클러스터의 유지보수 담당자도 클러스터 성능 최적화와 리소스 관리에 충분히 능숙해야 비즈니스가 정상적으로 운영될 수 있다는 점입니다.
이 아키텍처는 수집 측 Logstash를 Filebeat로 교체하며, 대규모 클러스터 시스템의 운영 로그 데이터 모니터링과 조회를 지원하기 위해 Logstash 및 Elasticsearch 클러스터를 구성할 수 있습니다.
방안 2
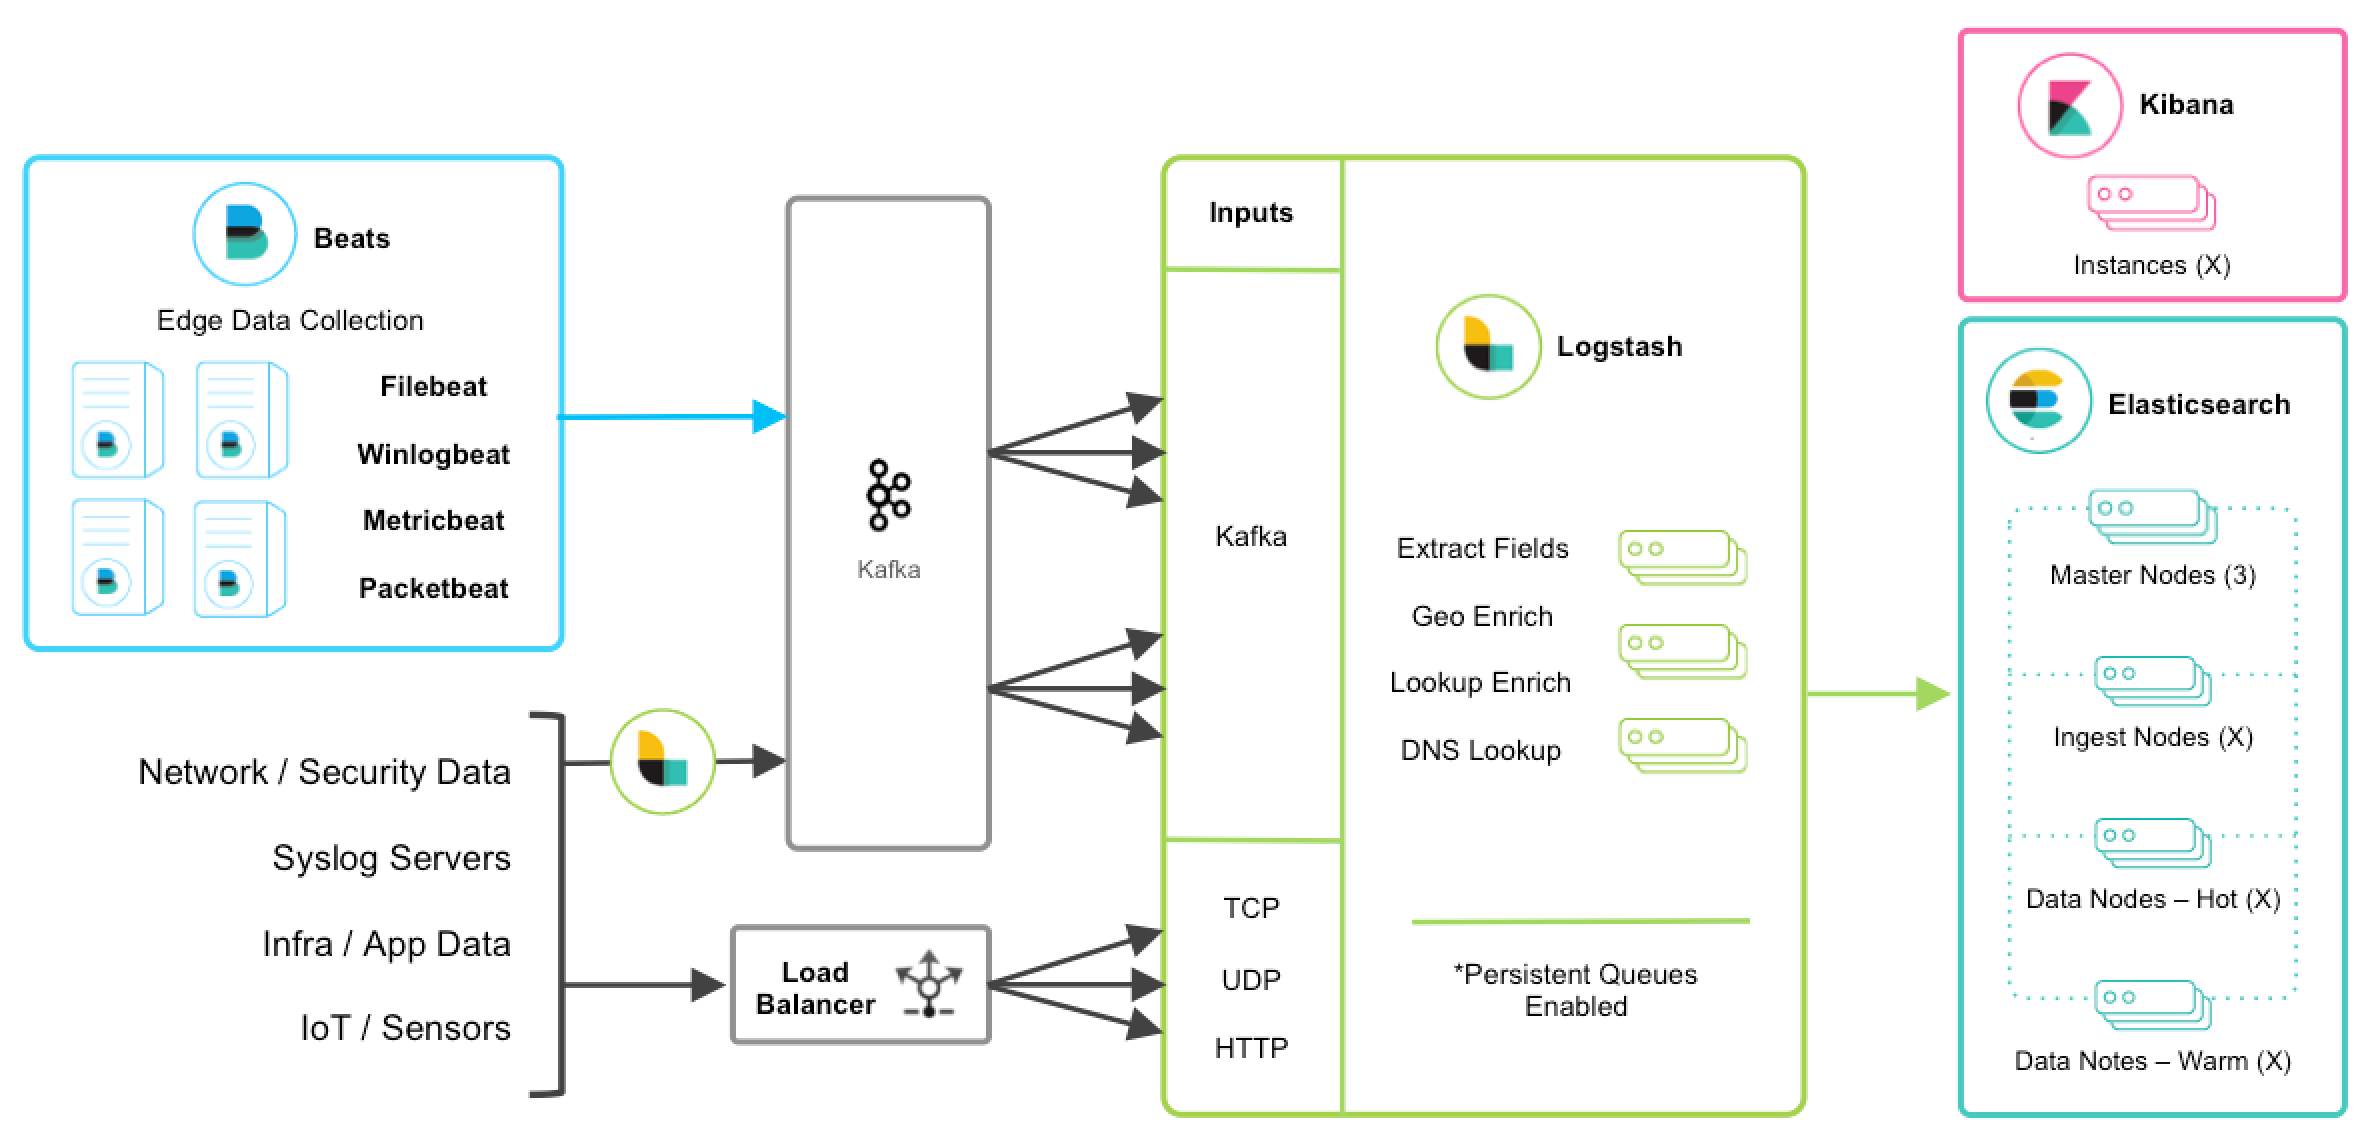
ELK를 기반으로 Filebeat를 로그 수집 측으로 사용합니다. 장점은 ELK 아키텍처처럼 Logstash를 로그 수집 측으로 사용할 경우 Logstash가 Java 환경을 기반으로 하므로 모든 서버에 JAVA 환경을 설치해야 하지만, 사용하는 Filebeat는 어떤 의존성도 필요하지 않아 설치 후 구성 파일을 수정하고 서비스를 시작하면 된다는 점입니다. 단점은 기술 스택이 복잡하여 빠르게 익히기 어렵고, Logstash의 리소스 소모가 크며 실행 시 CPU와 메모리 사용량이 높다는 점입니다. 또한 Kafka 클러스터를 추가로 유지보수해야 하며, 대규모 환경에서는 Zookeeper 클러스터를 추가로 유지보수해야 할 수도 있습니다. 사용자가 Filebeat, Logstash, ElasticSearch, Kafka, Kibana를 충분히 능숙하게 다룰 수 있어야 다양한 복잡한 비즈니스 문제를 해결할 수 있으며, LogStash 클러스터, Kafka 클러스터, ElasticSearch 클러스터의 유지보수 담당자도 클러스터 성능 최적화와 리소스 관리에 충분히 능숙해야 비즈니스가 정상적으로 운영될 수 있습니다.
이 아키텍처에서 수집 측이 로그 파일을 수집하면 Filebeat의 input에 fields를 정의하고 log_topic 필드를 정의하여 지정된 경로의 로그 파일을 하나의 유형으로 분류해야 합니다. Output에서는 Kafka로 출력하도록 지정합니다. Kafka는 메시지 큐로서 Filebeat 클라이언트가 수집한 모든 로그를 수신하고 로그 유형(예: nginx, php, system)에 따라 분류하여 전달합니다. Kafka에서는 input에서 정의한 로그 유형에 따라 서로 다른 topic을 생성합니다. Logstash는 Kafka 메시지 큐의 메시지를 수신하고 Kafka의 서로 다른 topic에 따라 로그를 분류하여 Elasticsearch에 기록합니다. Kibana는 Elasticsearch의 인덱스를 매칭하여 로그 콘텐츠를 분석, 검색, 차트로 표시할 수 있습니다(물론 차트는 직접 설계해야 합니다).
방안 3
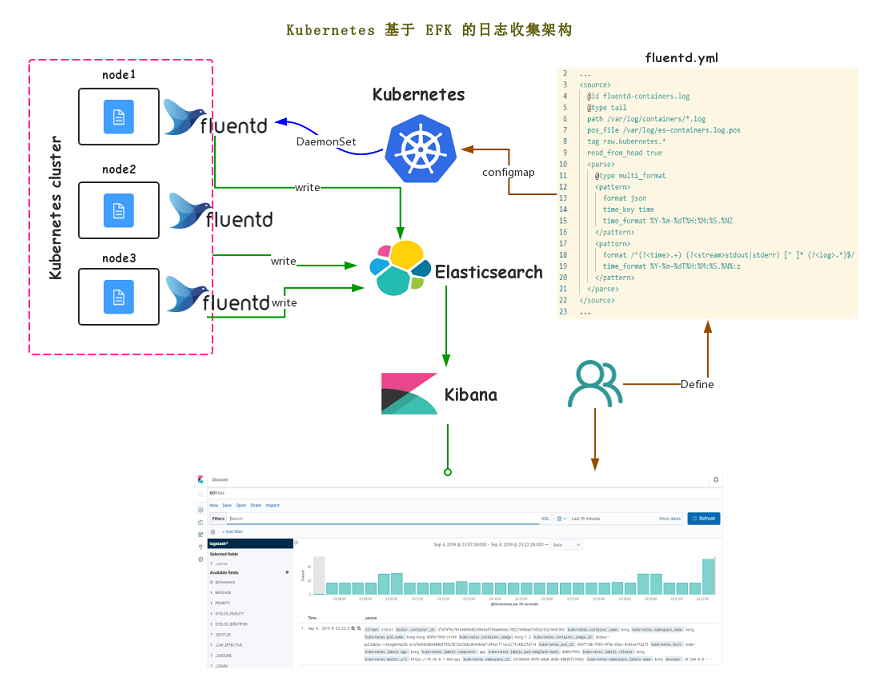
Fluentd를 로그 수집 측으로 사용합니다. 장점은 Fluentd의 리소스 점유가 LogStash 클러스터보다 훨씬 적어 아키텍처를 더 간단하고 유연하게 만들 수 있다는 점입니다. 단점은 Fluentd 구성이 상대적으로 복잡하고 사용 진입 장벽이 높아 빠르게 익히기 어려우며, 구성 파일이 상대적으로 복잡하여 수정하기 번거롭다는 점입니다. 사용자가 Fluentd, ElasticSearch, Kibana를 충분히 능숙하게 다룰 수 있어야 다양한 복잡한 비즈니스 문제를 해결할 수 있으며, ElasticSearch 클러스터의 유지보수 담당자도 클러스터 성능 최적화와 리소스 관리에 충분히 능숙해야 비즈니스가 정상적으로 운영될 수 있습니다.
이 아키텍처는 Fluentd를 통해 프로그램의 로그를 수집하고, Elasticsearch 클러스터에 로그를 저장한 후, 마지막으로 Kibana에서 Elasticsearch를 연결하여 로그 조회를 구현합니다.
Guance 아키텍처
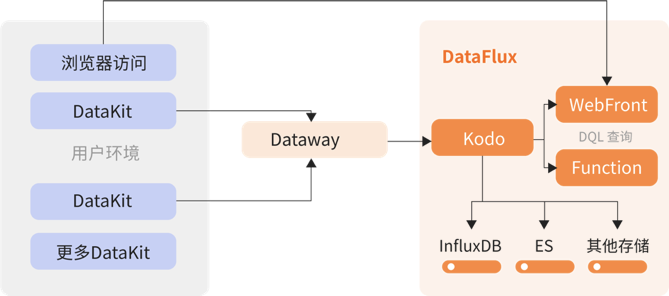
DataKit을 기본 데이터 수집 도구로 사용하여 주로 시스템에서 실행되는 다양한 메트릭, 로그 등의 데이터를 수집하고, DataWay를 통해 Guance로 전송합니다. Guance에서 사용자는 다양한 메트릭, 로그 등의 데이터를 조회하고 분석할 수 있습니다. DataKit은 Guance에서 매우 중요한 데이터 수집 컴포넌트이며, Guance의 모든 데이터는 DataKit에서 비롯됩니다.
DataKit의 배포 구성은 매우 간단하고 명확하며, 시각화된 클라이언트를 통해 사용자가 DataKit을 관리할 수 있습니다. DataKit은 로그 데이터뿐만 아니라 APM 데이터, 인프라, 컨테이너, 미들웨어, 네트워크 성능 등을 포함한 다양한 데이터를 수집할 수 있습니다. DataKit은 LogStash나 Fluentd처럼 ElasticSearch, Kafka 등의 컴포넌트에 의존하여 기능을 보완할 필요가 없습니다. Guance에서는 이러한 문제를 전혀 고려할 필요 없이 사용자는 비즈니스 최적화에만 집중할 수 있습니다. DataKit은 사용자가 방대한 기술 스택을 익히고 높은 학습 비용을 지불할 필요 없이, 간단한 구성만으로 Guance과 함께 다양한 복잡한 비즈니스 문제를 해결할 수 있습니다. ELK와 EFK는 전체 운영 유지보수 비용이 매우 크며 ElasticSearch 클러스터만으로도 많은 비용이 발생합니다. 비용 절감을 위해 콜드/핫 데이터까지 고려해야 한다면 더욱 골치 아픈 일이 됩니다. Guance을 사용하면 이러한 문제를 고려할 필요 없이 비즈니스에만 집중하면 됩니다.
하드웨어 비용 비교
가격은 누구나 매우 관심을 가지는 요소입니다. 클라우드 서비스를 기준으로 ELK, EFK, Guance 간의 비용을 비교해 보겠습니다.
ELK 비용
Elastic의 기본 컴포넌트는 모두 오픈소스이므로 주요 비용은 하드웨어에서 발생합니다. 서로 다른 아키텍처 구성으로 10대 서버의 로그를 수집하고, 서버당 하루 1GB의 로그가 발생하는 기준으로 비용을 산정합니다.
LogStash 클러스터 + Kafka 클러스터 + ElasticSearch 클러스터 + Kibana
- LogStash 클러스터
| 과금 항목 | 값 | 단가 | 비용(위안) |
|---|---|---|---|
| 서버 | 1대(2코어 4GB) | 월간 구독 요금: 216.7위안/월 | 216.7 |
| 스토리지 | 50GB | ESSD: 0.5위안/GB | 25 |
| 합계 | 241.7 |
- Kafka 클러스터
| 과금 항목 | 값 | 단가 | 비용(위안) |
|---|---|---|---|
| 서버 | 3대(4코어 16GB) | 월간 구독 요금: 788위안/월 | 2364 |
| 스토리지 | 200GB | ESSD: 0.5위안/GB | 300 |
| 합계 | 2664 |
- ElasticSearch 클러스터
| 과금 항목 | 값 | 단가 | 비용(위안) |
|---|---|---|---|
| 서버 | 3대(2코어 8GB) | 월간 구독 요금: 383위안/월 | 1149 |
| 스토리지 | 500GB | ESSD: 0.5위안/GB | 750 |
| 합계 | 1899 |
- Kibana 노드
| 과금 항목 | 값 | 단가 | 비용(위안) |
|---|---|---|---|
| 서버 | 1대(1코어 2GB) | 월간 구독 요금: 104위안/월 | 104 |
| 스토리지 | 50GB | ESSD: 0.5위안/GB | 25 |
| 합계 | 129 |
비즈니스 규모가 크지 않은 스토리지와 서버 구성을 기준으로 LogStash + Kafka + ElasticSearch + Kibana의 한 달 총 비용은 5175.4위안입니다.
간단한 아키텍처로 Kafka 클러스터를 사용하지 않는 경우 LogStash + ElasticSearch + Kibana의 한 달 총 비용은 2511.4위안입니다.
EFK 비용
Elastic의 기본 컴포넌트는 모두 오픈소스이므로 주요 비용은 하드웨어에서 발생합니다. 서로 다른 아키텍처 구성으로 10대 서버의 로그를 수집하고, 서버당 하루 1GB의 로그가 발생하는 기준으로 비용을 산정합니다.
Fluentd + ElasticSearch 클러스터 + Kibana
- Fluentd
Fluentd는 별도로 클러스터로 배포할 필요가 없으므로 Fluentd 비용은 고려하지 않고 ElasticSearch + Kibana만 계산합니다.
- ElasticSearch 클러스터
| 과금 항목 | 값 | 단가 | 비용(위안) |
|---|---|---|---|
| 서버 | 3대(2코어 8GB) | 월간 구독 요금: 383위안/월 | 1149 |
| 스토리지 | 500GB | ESSD: 0.5위안/GB | 750 |
| 합계 | 1899 |
- Kibana 노드
| 과금 항목 | 값 | 단가 | 비용(위안) |
|---|---|---|---|
| 서버 | 1대(1코어 2GB) | 월간 구독 요금: 104위안/월 | 104 |
| 스토리지 | 50GB | ESSD: 0.5위안/GB | 25 |
| 합계 | 129 |
동일한 비즈니스 규모로 스토리지와 서버 구성을 계산하면 Fluentd + ElasticSearch + Kibana의 한 달 총 비용은 2028위안입니다.
Guance 비용
Guance는 제품 자체에 대한 요금은 부과하지 않으며 스토리지 사용량, DataKit 수집기 수, 로그 데이터 수, 백업 로그 데이터 수, 일일 작업 예약 횟수, 단일 DataKit 시계열, 실제 사용자 모니터링(RUM) 일일 세션 수, 애플리케이션 성능 모니터링(APM) trace 수를 기준으로 요금을 산정합니다. 동일하게 10대 서버의 로그를 수집하고 서버당 하루 1GB의 로그가 발생하는 기준으로 비용을 계산합니다.
| 과금 항목/버전 | 무료 플랜 | 애자일 플랜 |
|---|---|---|
| DataKit 수 | 무제한 | 5위안/일 |
| 시계열 | 총 시계열 < 500 | 단일 DataKit 시계열 < 500, DataKit 비용 = DataKit 수 × 기본 단가 단일 DataKit 시계열 > 500, DataKit 수는 다음 계산 공식으로 산정: - DataKit 수 = 현재 워크스페이스 시계열 총수 / 500(최종 결과값은 올림) - DataKit 비용 = DataKit 수 × 기본 단가 |
| 로그 데이터 수 | 200만 건 | 0.5위안/일(100만 건당) |
| 백업 로그 데이터 수 | 없음 | 0.2위안/일(100만 건당) |
| Trace 수 | 1만 건 | 1위안/일(100만 건당) |
| Session 수 / PV 수 | Session 100개 | 1위안/일(Session 100개 또는 PV 1,000개 기준) 참고: 위 두 항목 중 실제 발생 비용이 더 낮은 항목을 최종 비용으로 산정 |
| 클라우드 신서틱 테스트 API 작업 횟수 | 5회 | 1위안/일(1,000회당) 참고: 통계에 자체 호스팅 노드에서 발생한 API 테스트 데이터는 포함되지 않음 |
| 클라우드 신서틱 테스트 Browser 작업 횟수 | 15위안/일(1,000회당) 참고: 통계에 자체 호스팅 노드에서 발생한 Browser 테스트 데이터는 포함되지 않음 |
|
| 작업 예약 횟수 | 5,000회 | 1위안/일(10,000회당) |
| SMS 전송 횟수 | 없음 | 0.1위안/일(건당) |
10대 서버에 DataKit을 설치하고, 서버당 하루 1GB의 로그를 수집하며, 로그 1건을 4KB로 계산합니다.
| 과금 항목 | 값 | 단가 | 비용(위안) |
|---|---|---|---|
| 서버 | DataKit 10개 | 월간 구독 요금: 150위안/월 | 1500 |
| 스토리지 | 하루 1GB | 0.5위안/일(100만 건당) | 325 |
| 합계 | 1825 |
동일한 비즈니스 규모로 계산하면 Guance의 한 달 총 비용은 1825위안입니다.
운영 및 유지보수 비용 비교
운영 및 유지보수 비용에 대해 이야기하자면, 클러스터의 안정성을 보장하기 위해 관련 운영 작업이 필수적이라는 것은 모두 알고 있습니다. 그럼 서로 다른 방안 간의 비용 차이를 분석해 보겠습니다.
ELK 운영 및 유지보수 비용
Elastic의 기본 컴포넌트가 모두 오픈소스이므로 직접 클러스터를 구축하여 운영 및 유지보수 관리를 해야 합니다. 복잡한 아키텍처의 ELK에는 LogStash 클러스터 + Kafka 클러스터 + ElasticSearch 클러스터 + Kibana 노드가 포함될 수 있습니다. 먼저 사용자의 비즈니스 로그가 많고 계산 로직이 복잡한 경우 LogStash 클러스터, Kafka 클러스터, ElasticSearch 클러스터의 규모와 구성 요구사항이 매우 높아집니다. 또한 다양한 규모의 클러스터는 운영 인력의 역량 요구도 매우 높으며, 대규모 클러스터에서는 다양한 문제가 발생할 수 있고 리소스 활용률을 극대화하기 위한 성능 튜닝 경험도 충분히 필요합니다. 마지막으로 운영 인력의 기술 스택 역량은 필수적입니다.
EFK 운영 및 유지보수 비용
ELK와 마찬가지로 EFK도 오픈소스 컴포넌트를 기반으로 하므로 사용자가 직접 클러스터를 구축하여 관리해야 합니다. ELK보다 나은 점은 EFK가 Fluentd를 수집기로 사용하여 데이터를 수집할 때 LogStash 클러스터를 생략할 수 있고 리소스 점유도 더 적다는 것입니다. 그러나 여전히 비즈니스 규모에 따라 ElasticSearch 클러스터 규모를 동적으로 확장해야 하며, 대규모 클러스터에서 운영 인력의 역량 요구가 높고 최적화가 어렵다는 문제도 동일합니다. 또한 Fluentd 구성은 LogStash보다 더 어려워 운영 인력의 경험에 의존해야 합니다. 스크립트 최적화가 제대로 이루어지지 않으면 로그 파싱 시 서버에서 실행 중인 기존 비즈니스에 영향을 줄 수 있으므로, 온라인 비즈니스의 안정적인 운영을 보장하려면 운영 인력에 대한 요구사항이 더 높아질 수 있습니다.
Guance 운영 및 유지보수 비용
Guance는 SaaS 기반 관측 가능성 플랫폼입니다. 사용자는 데이터를 수집하려는 서버에 DataKit 하나만 배포하고 시각화 관리 기능을 활성화하면 원격 시각화 방식으로 수집 측의 구성 관리를 완료할 수 있습니다. Guance 플랫폼은 최적의 로그 파싱 템플릿을 제공하여 서버 부하를 최소화하면서 성능 활용을 극대화할 수 있도록 돕고, 간단한 구성만으로 비즈니스 로그를 파싱할 수 있게 하여 사용자가 비즈니스 최적화와 확장에 더 집중할 수 있게 합니다. 더 이상 수집 측과 로그 파싱 클러스터 최적화에 시간을 쏟을 필요가 없습니다. 또한 Guance는 인프라, 컨테이너, 미들웨어, 데이터베이스, 메시지 큐, 애플리케이션 링크, 프런트엔드 액세스, 시스템 보안, 네트워크 액세스 성능에 이르는 전 링크에 걸친 완전한 관측 기능을 제공하며, 비즈니스 요구에 따라 자체 관측 시나리오를 구현할 수 있습니다. 미성숙한 오픈소스 제품을 연구하거나 개조하는 데 더 이상 시간을 쏟지 않아도 되어, 진정한 0 운영 비용으로 비즈니스 개발에 집중할 수 있습니다.
학습 비용 비교
로그 분석 시스템을 구축하거나 사용하는 데 있어 학습 비용은 빼놓을 수 없는 요소입니다. 잘 활용하려면 먼저 잘 배워야 하니까요. 그럼 서로 다른 방안의 직접적인 사용 난이도를 살펴보겠습니다.
ELK 학습 비용
Elastic의 컴포넌트가 모두 오픈소스이므로 직접 클러스터를 구축해야 합니다. 먼저 ELK 체계를 사용하여 로그를 분석하고 처리할 때 ELK 환경 준비와 ELK 컴포넌트 구성 사용에 대한 학습이 필수적입니다. 예를 들어 Elasticsearch에 대한 이해를 먼저 쌓고, Elasticsearch 기초를 익히며, Elasticsearch 인덱스 작업을 마스터하고, Elasticsearch 클러스터를 잘 계획할 수 있어야 하며, 오픈소스 버전의 LogStash, ElasticSearch에 대한 성능 구성 최적화 등도 필요합니다.
EFK 학습 비용
ELK와 마찬가지로 EFK도 이러한 내용을 학습해야 합니다. 게다가 Fluentd는 LogStash보다 구성이 더 유연하여 학습 비용이 더 높습니다. 성능 최적화는 더욱 사용 경험에 의존하게 됩니다. LogStash가 120개 이상의 grok 템플릿을 제공하는 것과 달리 Fluentd는 사용자가 문서를 참고하여 더 많은 학습을 해야 실제로 활용할 수 있습니다.
Guance 학습 비용
Guance의 경우 사용자 환경에는 DataKit만 배포하여 데이터를 수집하면 됩니다. 사용자가 필요한 데이터 수집 구성에 대해서는 공식적으로 구성 참조와 사용 가이드를 제공합니다(현재 200개 이상의 기술 스택 지원). 사용자가 로그 분석, 비즈니스 관측 또는 분산 추적 등을 수행하려면 Guance 플랫폼의 해당 모듈 사용법을 일부 학습하고 DataKit의 수집 항목을 활성화하기만 하면 비즈니스 추적 등의 요구사항을 충족할 수 있습니다. 오픈소스 클러스터를 구축하여 로그 분석 등의 요구사항을 구현하고 다양한 기술을 학습해야 하는 수고를 피할 수 있어, 사용자가 오픈소스 클러스터 운영을 보장하기 위해 많은 시간을 기술 학습에 쓰는 대신 비즈니스 문제 처리에 더 많은 에너지를 쏟을 수 있습니다.
사용 경험 비교
제품 사용 경험 비교도 매우 중요합니다. 동일한 기능을 구현할 때 사용자에게 어떤 다른 체험을 주는지 살펴보겠습니다.
ELK 사용 경험
ELK를 사용하여 로그 분석을 수행하려면 먼저 LogStash, Kafka, ElasticSearch 클러스터와 Kibana 표시 노드를 구축해야 합니다. 다음으로 특정 컴포넌트의 데이터 수집과 파싱을 구현하려면 기존 120여 개의 파싱 템플릿 중 사용할 수 있는 것이 있는지 먼저 확인해야 하며, 없으면 일련의 테스트를 거쳐야 데이터 수집과 파싱을 구현할 수 있습니다. 수집 시 성능 소모가 너무 크거나 파싱 처리가 너무 느린 것을 발견하면 디버깅이 또 번거로운 과정이 됩니다. 또한 로그 증가량이 너무 많으면 ElasticSearch 조회 인덱스 최적화와 클러스터의 빈번한 확장 문제에 직면하게 됩니다. 마지막으로 특정 비즈니스를 표시하려면 Kibana의 KQL을 학습하여 데이터를 조회하고 표시해야 하며, 데이터에 대한 실시간 추적 및 알림이 필요하면 다른 오픈소스 컴포넌트에 의존해야 할 수도 있습니다. 사용 과정에서 요구사항 제기부터 해결까지 80% 이상의 시간이 오픈소스 컴포넌트의 다양한 문제를 해결하는 데 사용되며, 결국 실제 비즈니스 분석 및 최적화에 사용되는 시간은 일부에 불과합니다.
EFK 사용 경험
EFK를 사용한 로그 분석도 ElasticSearch 클러스터와 Kibana 표시 노드 구축을 피할 수 없습니다. Fluentd의 더 유연한 구성 때문에 사용자는 데이터 수집과 파싱을 성공적으로 완료하기 위해 더 많은 시간을 구성과 디버깅에 할애해야 할 수 있습니다. ElasticSearch 클러스터를 사용해도 ElasticSearch 인덱스 최적화와 클러스터 확장을 피할 수 없으며, 마지막으로 Kibana를 학습하여 데이터를 조회하고 표시해야 합니다. 마찬가지로 사용 과정에서 요구사항 제기부터 해결까지 80% 이상의 시간이 오픈소스 컴포넌트의 다양한 문제를 해결하는 데 사용되며, 결국 실제 비즈니스 분석 및 최적화에 사용되는 시간은 일부에 불과합니다.
Guance 사용 경험
Guance으로 로그 분석 등의 요구사항을 구현하는 것은 매우 사용자 친화적입니다. 먼저 Guance의 데이터 수집 측 DataKit은 설치 구성이 매우 간단하여 단 한 줄의 명령으로 설치 구성을 완료할 수 있습니다. 다음으로 사용자의 컴포넌트 로그 또는 데이터 수집 요구에 대해 Guance는 200개 이상의 주요 기술 스택을 지원하며, 인프라, 컨테이너, 미들웨어, 데이터베이스, 메시지 큐, 애플리케이션 링크, 프런트엔드 액세스, 시스템 보안, 네트워크 액세스 성능 등 전방위적인 지원을 제공합니다. 또한 체계적인 문서 시스템을 갖추고 있어 사용자의 모든 사용 요구를 문서를 통해 해결할 수 있으며, 수집기 DataKit에 대해 시각화 클라이언트 방식을 제공하여 사용자의 사용 어려움을 줄여줍니다. 동시에 Guance 플랫폼은 많은 공식 시나리오 뷰를 제공하여 사용자가 자체 비즈니스의 상태를 더 잘 관측할 수 있도록 돕습니다.
Guance는 인프라, 컨테이너, 미들웨어, 데이터베이스, 메시지 큐, 애플리케이션 링크, 프런트엔드 액세스, 시스템 보안, 네트워크 액세스 성능에 이르는 전 링크 관측 가능성을 구축했습니다. Guance의 표준 제품을 기반으로 사용자가 DataKit을 올바르게 구성하면 프로젝트의 완전한 관측 가능성을 빠르게 구축할 수 있습니다. 또한 Line Protocol과 Guance의 시나리오 구축 능력을 기반으로 사용자가 직접 관측에 필요한 메트릭을 정의하고 편리하게 통합하여 더 확장된 관측 가능성을 실현할 수 있습니다.
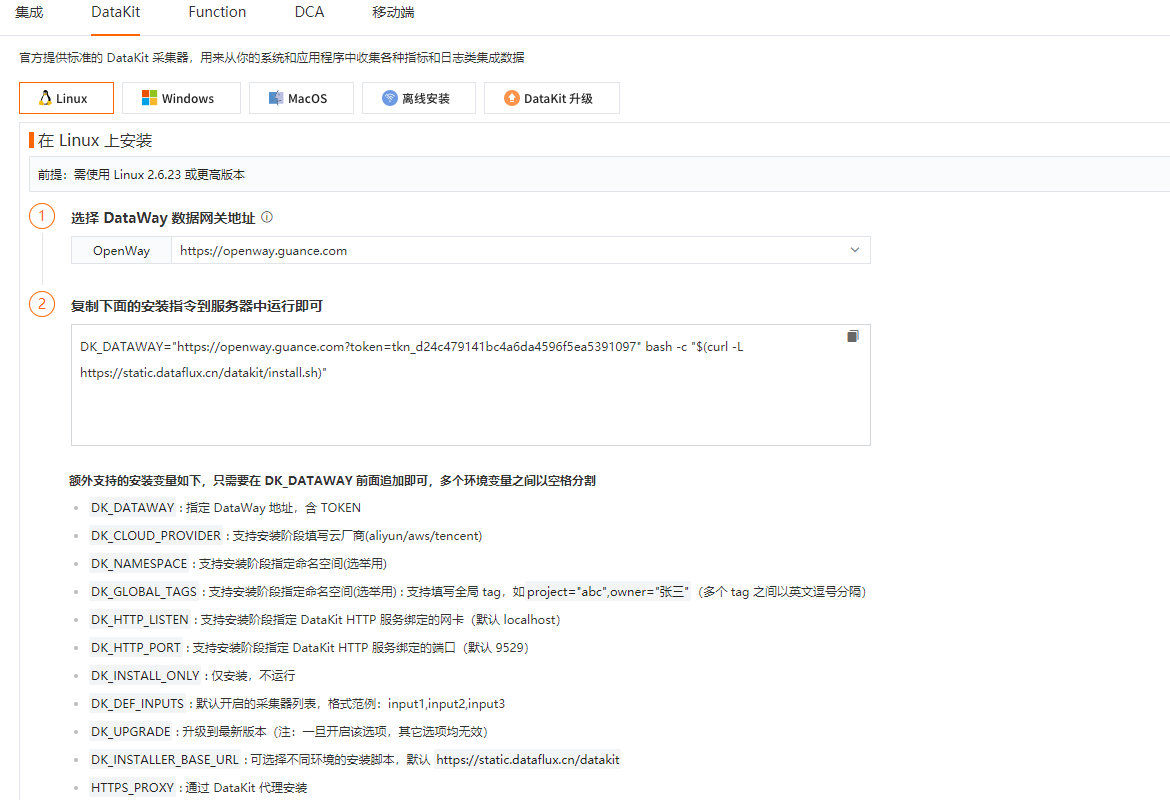
간편한 DataKit 설치
단 한 줄의 명령으로 DataKit 설치를 완료할 수 있습니다.
편리한 수집 항목 관리
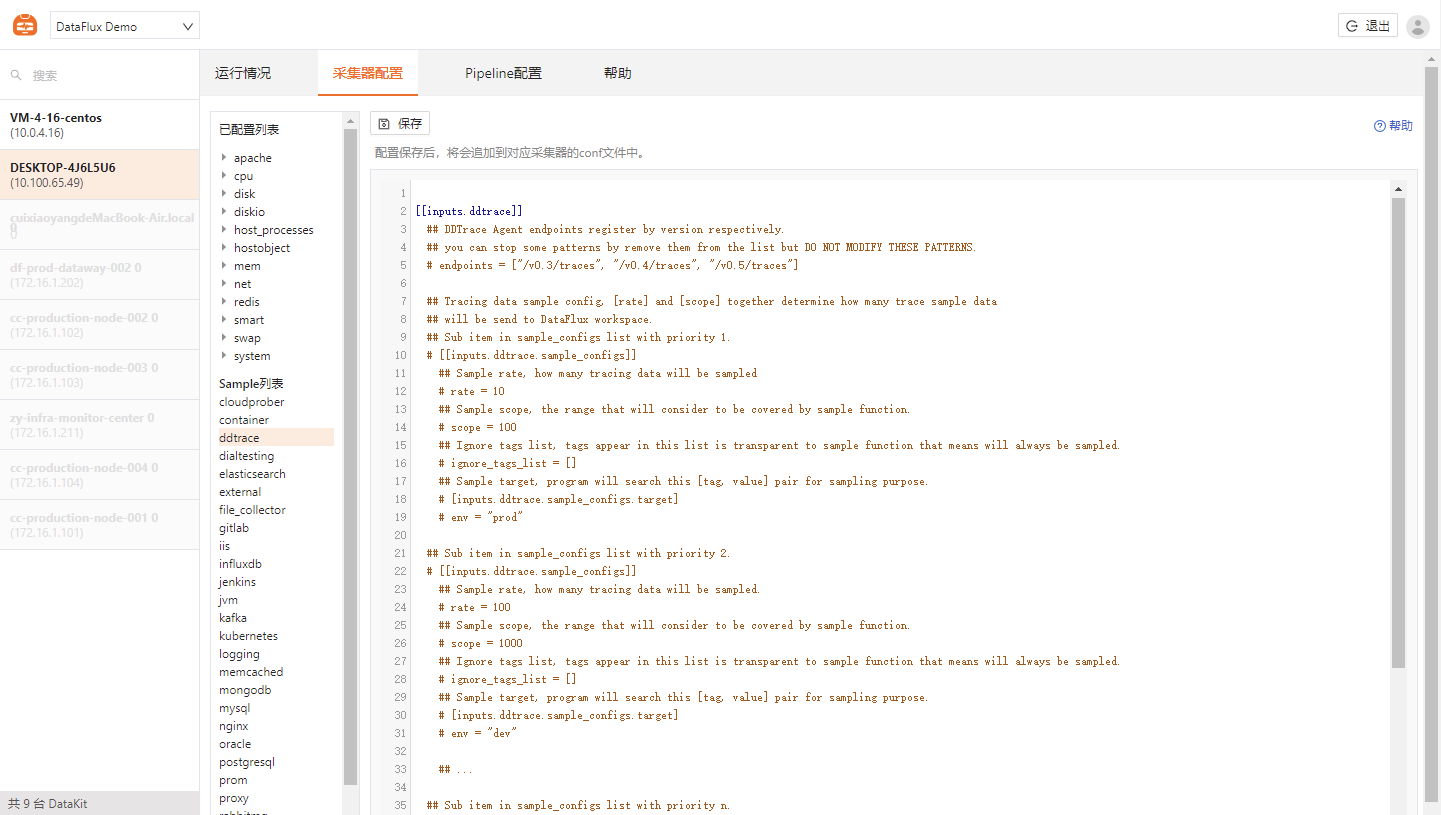
DataKit 클라이언트 액세스를 활성화하면 DataKit 클라이언트에서 수집 항목을 수정할 수 있습니다. 또한 많은 템플릿이 내장되어 있어 사용자가 수집하려는 내용에 따라 해당 구성을 활성화하기만 하면 데이터 수집을 완료할 수 있습니다.
풍부한 공식 컴포넌트 지원
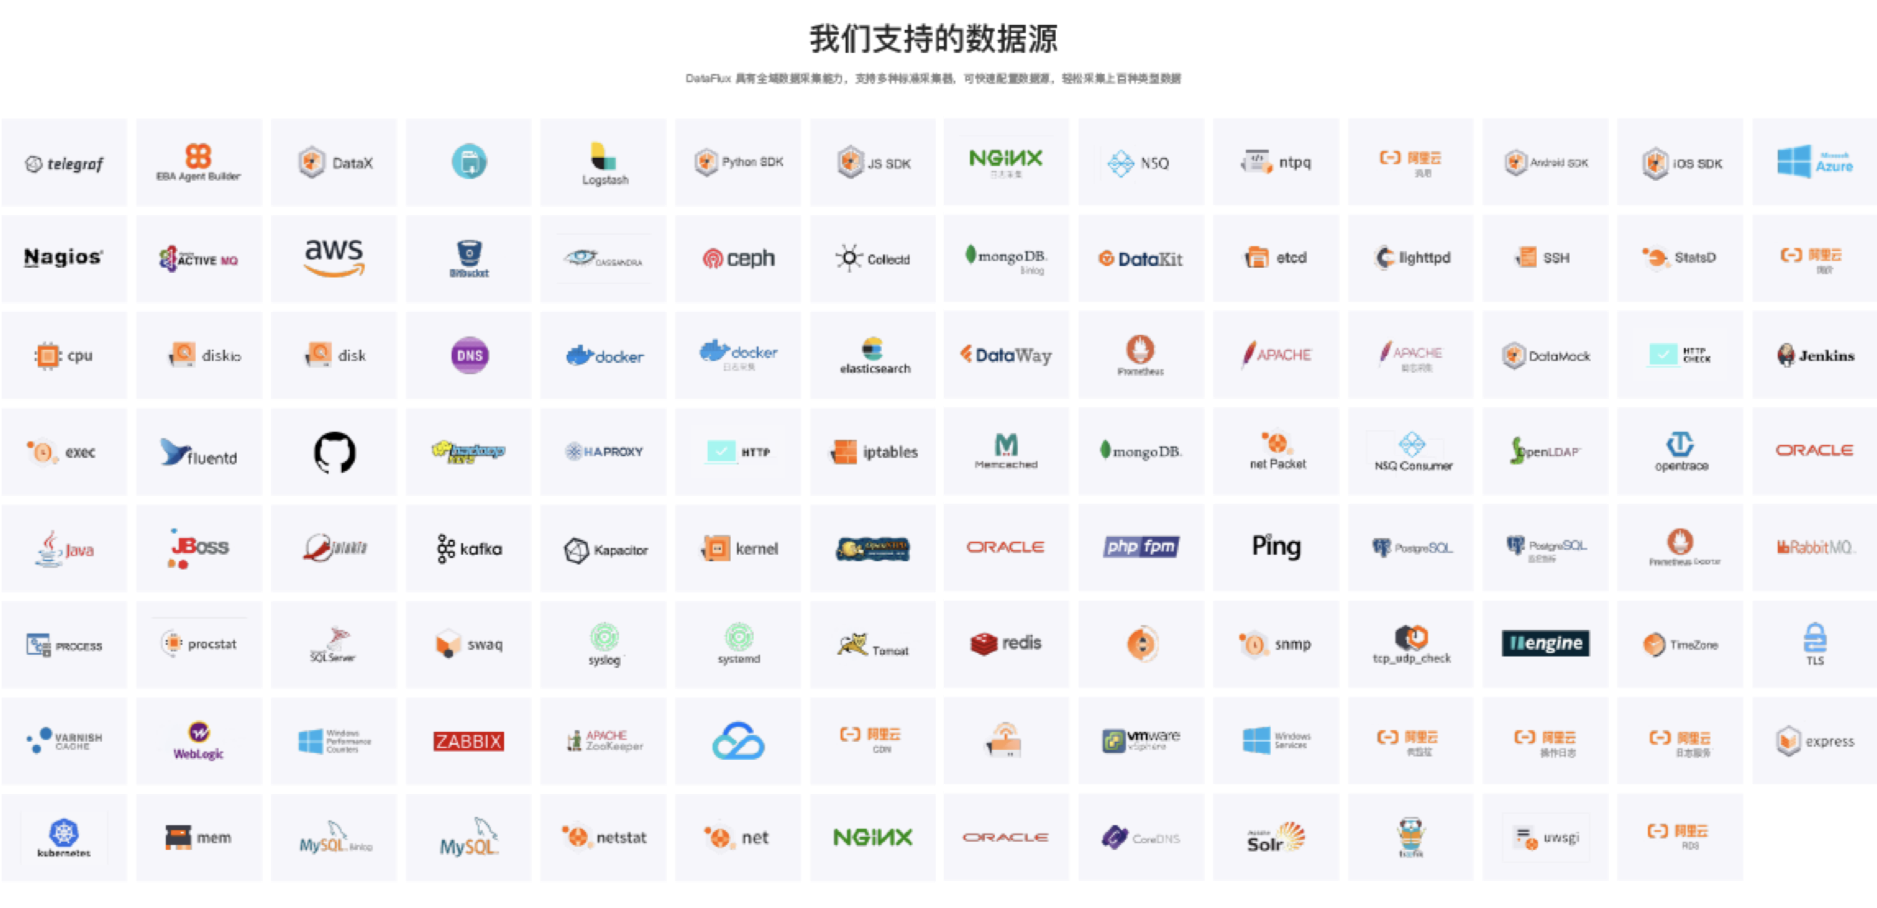
DataKit에는 동적 grok 문법 쿼리 디버깅, 자체 개발 문법 DQL 기반의 빠른 데이터 쿼리, 실시간 inputs 수집 실행 관측, 엣지 컴퓨팅 능력, 시각화 클라이언트 방식의 구성 및 수집 소스 배포 등 강력한 내장 기능이 포함되어 있습니다. 또한 200개 이상의 공식 유지보수 데이터 소스 연동과 기술 스택 지원을 제공하며 Telegraf, Beats, Logstash, Fluentd 등 다양한 외부 데이터 연동과도 호환됩니다.
더 강력한 제품 역량
Guance는 인프라, 컨테이너, 미들웨어, 데이터베이스, 메시지 큐, 애플리케이션 링크, 프런트엔드 액세스, 로그, 시스템 보안, 네트워크 액세스 성능에 이르는 전 링크 관측 가능성을 구축했습니다. Guance의 표준 제품을 기반으로 사용자가 DataKit을 올바르게 구성하면 프로젝트의 완전한 관측 가능성을 빠르게 구축할 수 있습니다. 또한 다양한 기술 스택의 이상 탐지 라이브러리 등의 기능을 지원하여 사용자가 복잡한 비즈니스 문제에 대해 더 많은 선택지를 가질 수 있습니다.