Guance VS ELK、EFK
ELK、EFK と Guance の概要
現代のソフトウェアシステムは複雑化が進んでおり、通常、ログはサーバーで生成されてさまざまなファイルに出力されます。一般的にはシステムログ、アプリケーションログ、セキュリティログがあります。これらのログはさまざまなマシンに分散して保存されています。システムに障害が発生した場合、エンジニアは各サーバーにログインし、grep / sed / awk などの Linux スクリプトツールを使ってログから障害の原因を探す必要があります。ログシステムがない場合、まずリクエストを処理したサーバーを特定する必要があり、そのサーバーに複数のインスタンスがデプロイされている場合は、各アプリケーションインスタンスのログディレクトリに移動してログファイルを探す必要があります。また、各アプリケーションインスタンスにはログローテーションポリシー(例:1日で1ファイル生成)やログの圧縮・アーカイブポリシーなども設定されています。この一連のプロセスにより、障害の調査や原因の早期特定に大きな手間がかかります。
クラウドにデプロイした場合、各ノードにログインして各モジュールの log を確認することはほぼ不可能になります。効率が低いだけでなく、セキュリティ上の理由から、エンジニアが各物理ノードに直接アクセスできない場合もあるためです。さらに、現在の大規模ソフトウェアシステムは基本的にクラスター方式でデプロイされており、各サービスについて複数の同一 POD が起動されて外部にサービスを提供し、各コンテナが独自の log を生成します。生成された log だけを見ても、どの POD が生成したのかはわかりません。分散ログの確認はさらに困難になります。
そのため、これらのログを一元管理し、集中的な検索機能を提供できれば、診断効率の向上だけでなく、システムの状況を包括的に把握でき、事後対応に追われる受け身の状態を避けることができます。
ELK
では、ELK とは一体何でしょうか。「ELK」は3つのオープンソースプロジェクトの頭文字をとったもので、Elasticsearch、Logstash、Kibana の3つのプロジェクトを指します。Elasticsearch は検索・分析エンジンです。Logstash はサーバーサイドのデータ処理パイプラインで、複数のソースから同時にデータを収集して変換し、Elasticsearch などの「データストア」にデータを送信します。Kibana は、ユーザーが Elasticsearch 内のデータをグラフやチャートで可視化できるようにします。
Elasticsearch
Elasticsearch は JSON ベースの分散型検索・分析エンジンです。RESTful Web サービスインターフェースからアクセスでき、スキーマレスの JSON(JavaScript Object Notation)ドキュメントを使用してデータを保存します。Java プログラミング言語で実装されているため、Elasticsearch はさまざまなプラットフォームで動作します。ユーザーは非常に高速に大容量のデータを検索できます。
主な特徴
- 各フィールドがインデックス化され検索可能な、分散型のリアルタイムファイルストレージ
- 分散型のリアルタイム分析検索エンジン
- 数百台のサーバーに拡張でき、PB 級の構造化・非構造化データを処理可能
Logstash
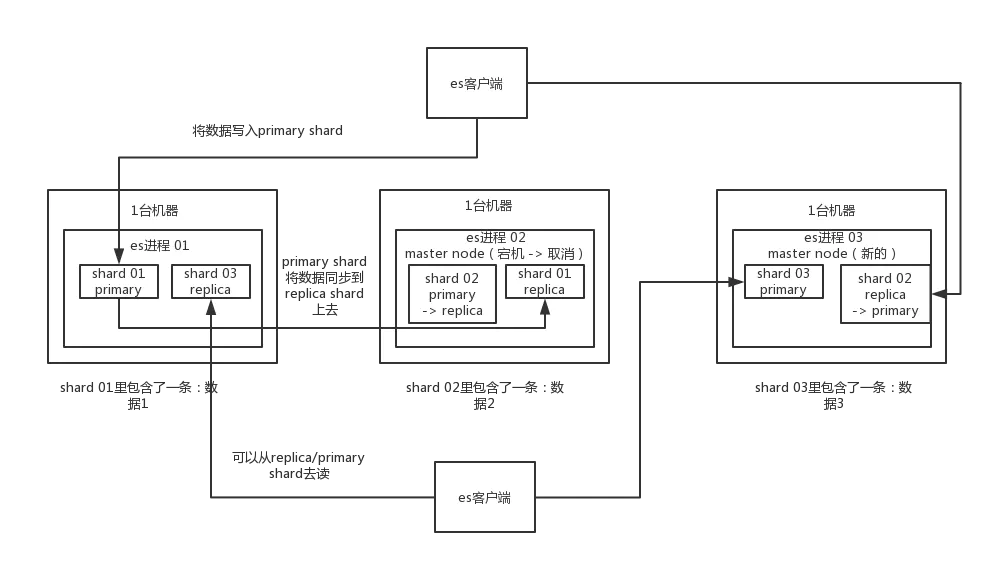
Logstash はデータストリーム用のオープンソースのストリーミング ETL エンジンであり、数分でデータストリームパイプラインを構築できます。水平スケーラビリティと耐障害性を備え、アダプティブバッファリングに対応しています。また、200 を超えるインテグレーションとプロセッサからなるプラグインエコシステムを備え、Elastic Stack を使用してデプロイメントの監視と管理を行います。
主な特徴
- ほぼすべてのデータにアクセス可能
- さまざまな外部アプリケーションと連携可能
- 弾力的な拡張をサポート
Logstash の構成
- *入力(inputs): *inputs は主にデータ受信のルールを提供します。例えば、ファイル内容の収集などに使用します。
- フィルター(filters): filters は主に転送されるデータをフィルタリングします。例えば、grok ルールを使用したデータフィルタリングなどです。
- 出力(outputs): outputs は主に受信したデータを定義済みの出力パターンに従って出力します。例えば、Elasticsearch への出力などです。
Kibana
Kibana はオープンソースのデータ分析・可視化プラットフォームであり、Elastic Stack のメンバーの1つとして Elasticsearch と連携するように設計されています。Kibana を使用すると、Elasticsearch インデックス内のデータの検索、表示、対話的操作が可能です。グラフ、テーブル、マップを利用して、データを多角的に分析・表現できます。
Kibana はビッグデータをわかりやすくします。シンプルなブラウザベースのインターフェースにより、Elasticsearch のリアルタイムなデータ変化を追跡する動的ダッシュボードをすばやく作成して共有できます。
EFK
EFK はソフトウェアではなく、ソリューション一式です。EFK は3つのオープンソースソフトウェアの頭文字をとったもので、Elasticsearch、Fluentd、Kibana、または Elasticsearch、Filebeat、Kibana を指します。Elasticsearch はログの分析と保存を担当し、Fluentd と Filebeat はログ収集を担当し、Kibana は UI での表示を担当します。これらが相互に連携してシームレスに機能し、多くの場面で効率的に活用されており、現在主流のログ分析システムソリューションの1つです。
Fluentd
Fluentd はデータストリームの処理に特化して設計されたオープンソースのデータコレクターで、データ形式として JSON を使用します。プラグイン方式のアーキテクチャを採用しており、高い拡張性と可用性を備え、信頼性の高い情報転送も実現しています。使用方法としては、さまざまなソースからの情報をまず Fluentd に送信し、次に Fluentd が設定に従ってさまざまなプラグインを通じて情報をファイル、SaaS プラットフォーム、データベース、さらには別の Fluentd に転送します。
主な特徴
- インストールが簡単
- 占有スペースが小さい
- 半構造化データのログ記録
- 柔軟なプラグインメカニズム
- 信頼性の高いバッファリング
- ログ転送
Fluentd の構成
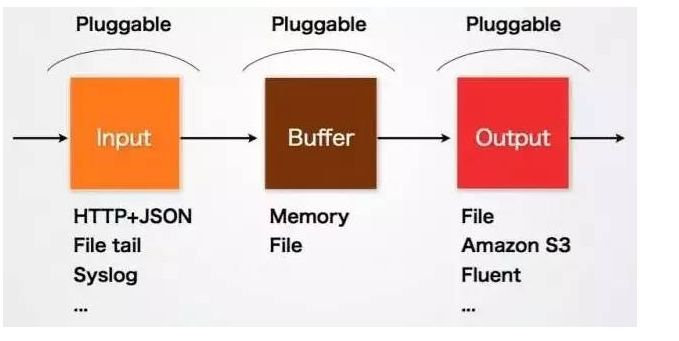
Fluentd の Input/Buffer/Output は、Flume の Source/Channel/Sink と非常によく似ています。
- Input: Input はデータの受信または能動的なデータ取得を担当します。syslog、http、ファイルの tail などをサポートします。
- Buffer: Buffer はデータ取得のパフォーマンスと信頼性を担い、ファイルやメモリなどのさまざまなタイプの Buffer を設定できます。
- Output: Output はファイル、AWS S3、その他の Fluentd などの宛先にデータを出力します。
Filebeat
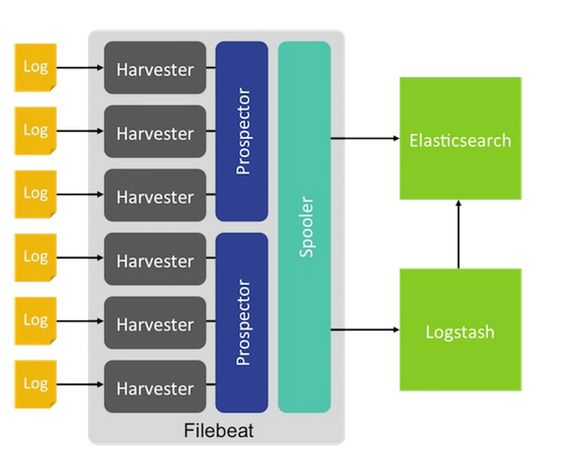
Filebeat は Golang で実装された軽量なログコレクターで、Elasticsearch stack の一員です。本質的にはエージェントであり、各ノードにインストールして、設定に従って対応する場所のログを読み取り、適切な宛先に送信できます。
Filebeat は信頼性が高く、ログの At least once(少なくとも1回)送信を保証します。また、ログのブレークポイントからの継続読み取り、ファイル名の変更、ログの切り詰め(Truncated)など、ログ収集におけるさまざまな問題にも対応しています。
Filebeat は Elasticsearch に依存しておらず、単独で使用できます。Filebeat を単独で使用してログの送信と収集を行うことも可能です。Filebeat には kafka、Elasticsearch、redis などの一般的な Output コンポーネントが組み込まれており、デバッグ目的で console や file に出力することもできます。既存の Output コンポーネントを利用してログを送信できます。もちろん、Output コンポーネントをカスタマイズして、Filebeat にログを任意の場所へ転送させることもできます。
filebeat は実際には elastic/beats の一員であり、filebeat のほかに HeartBeat、PacketBeat もあります。これらの beat の実装はすべて libbeat フレームワークに基づいています。
Filebeat の構成
- harvester(ハーベスター): harvester の主な役割は、単一のファイルの内容を読み取ることです。各ファイルを読み取り、その内容を出力に送信します。ファイルごとに1つの harvester が起動され、harvester はファイルのオープンとクローズを担当するため、実行中はファイル記述子が開いたままになります。読み取り中にファイルが削除または名前変更された場合、Filebeat はそのファイルの読み取りを継続します。
- prospector(プロスペクター): prospector の主な役割は、harvester を管理し、読み取るすべてのファイルのソースを特定することです。入力タイプがログの場合、prospector はパスに一致するすべてのファイルを検索し、ファイルごとに harvester を起動します。各 prospector はそれぞれ独自の Go コルーチンで実行されます。
注:Filebeat の prospector はローカルファイルのみを読み取ることができ、リモートホストに接続して保存されたファイルやログを読み取る機能はありません。Filebeat の適用範囲は非常に限られているため、この記事では Filebeat の詳細な比較は行いません。
Guance
DataKit
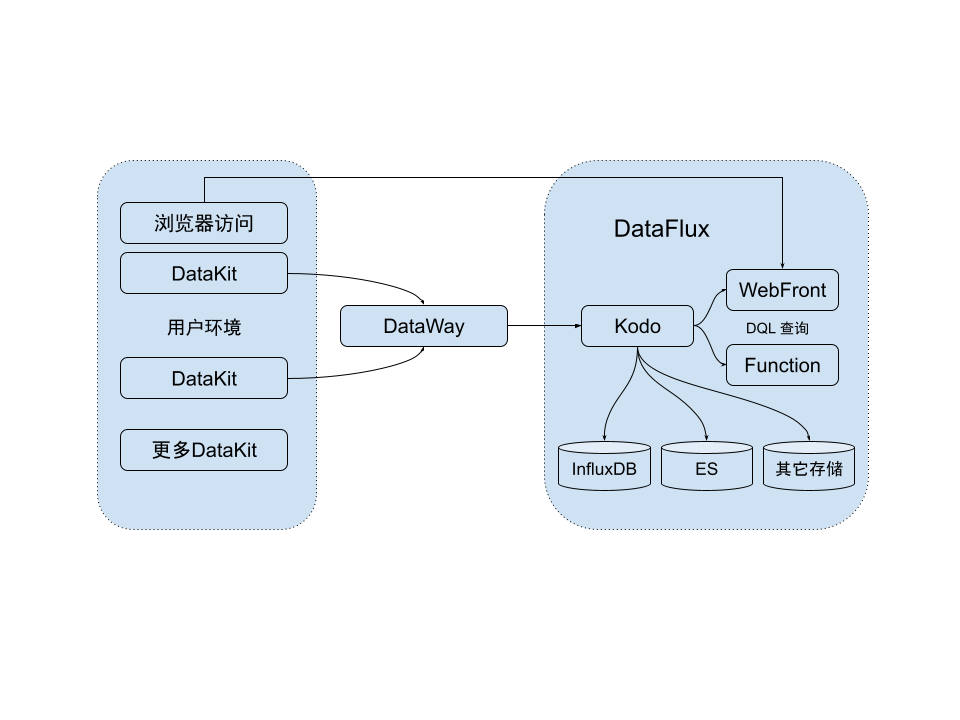
DataKit はユーザーのローカルマシン上で動作する基礎的なデータ収集ツールで、主にシステムの稼働中に生成されるさまざまなメトリクスやログなどのデータを収集し、Guance に集約します。Guance では、ユーザーは自分のさまざまなメトリクスやログなどのデータを表示・分析できます。DataKit は Guance において極めて重要なデータ収集コンポーネントであり、Guance 内のすべてのデータは DataKit に由来します。
- DataKit は主に定期収集の方式でさまざまなメトリクスを収集し、定時・定量で HTTP(s) を介して DataWay にデータを送信します。各 DataKit にはそれぞれ対応する token が設定され、異なるユーザーを識別するために使用されます。
- DataWay はデータを受信すると、Guance に転送します。Guance に送信されるデータには API 署名が含まれます。
- Guance は正当なデータを受信すると、データタイプに応じて異なるストレージにそれぞれ書き込みます。
収集系のデータについては、通常、一部のデータ損失は許容されます(データ自体が間欠的に収集されるため、間欠期間中のデータは一種のデータ損失と見なせます)。現在、データ転送経路全体では以下のように損失保護が実装されています:
- DataKit は何らかのネットワーク上の理由で DataWay への送信に失敗した場合、最大1,000ポイントのデータをキャッシュします。キャッシュされたデータがこの量を超えると、キャッシュはクリアされます。
- DataWay は何らかの理由で Guance への送信に失敗した場合、またはトラフィック量が多いために Guance への送信が間に合わない場合、これらのデータをディスクに永続化します。その後、トラフィックが低下するかネットワークが回復した時点で、これらのデータを Guance に送信します。遅延送信されたデータは即時性に影響を与えません。タイムスタンプはキャッシュされたデータに付与されているためです。
DataWay では、ディスクを保護するために、ディスクの最大使用量も設定可能です。これにより、ノードのストレージが溢れるのを防ぎます。使用量を超えたデータについては、DataWay もデータを破棄します。ただし、この容量は通常大きめに設定されています。
DataKit の構成
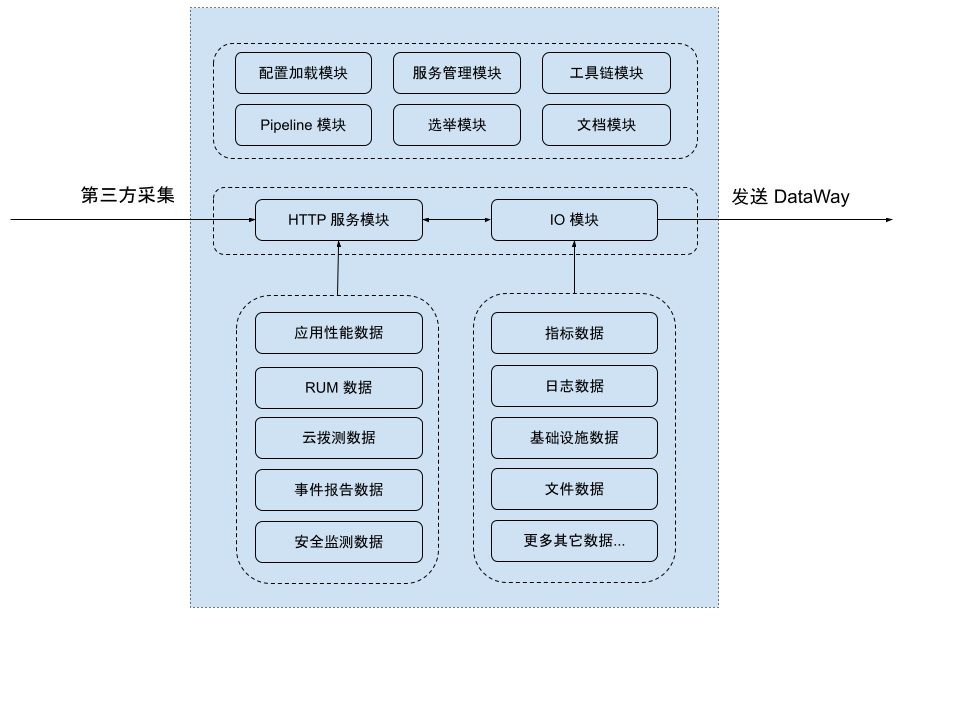
DataKit の内部は上から下に向かって、主に3つのレイヤーに分かれています:
- 最上位レイヤー:プログラムエントリモジュールといくつかの共通モジュールを含む
- 設定ロードモジュール:DataKit は独自のメイン設定(すなわち
conf.d/datakit.conf)のほかに、各収集プラグインの設定が個別に分かれています。1つにまとめると設定ファイルが非常に大きくなり、編集しにくくなるためです。 - サービス管理モジュール:主に DataKit サービス全体の管理を担当します。
- ツールチェーンモジュール:DataKit はクライアントプログラムとして、データ収集以外にもドキュメントの参照、サービスの再起動、更新など、さまざまな周辺機能を提供しており、これらはすべてツールチェーンモジュールで実装されています。
- Pipeline モジュール:ログ処理では、Pipeline スクリプト(Grok 構文)を使用してログをパースし、非構造化ログデータを構造化データに変換します。その他の非ログ系データでも、対応するデータ処理が可能です。
- 選挙モジュール:デプロイする DataKit が非常に多い場合、ユーザーはすべての DataKit の設定を同じにし、自動化された一括デプロイで各 DataKit に設定を配布できます。選挙モジュールの意義は、クラスター内で一部のデータ収集(例:Kubernetes クラスターメトリクス)を1つの DataKit だけが実行することにあります(そうしないとデータが重複し、収集対象に負荷がかかります)。クラスター内のすべての DataKit の設定が同じ場合でも、選挙モジュールにより、任意の時点で最大1つの DataKit だけが収集を実行できるようになります。
- ドキュメントモジュール:DataKit のドキュメントはインストール時に同梱されます。ユーザーは http://localhost:9529/man ページにアクセスしてドキュメント一覧を参照できます。コマンドラインでもドキュメントを閲覧できます。
- 設定ロードモジュール:DataKit は独自のメイン設定(すなわち
- 転送レイヤー:ほぼすべてのデータの入出力を担当します。
- HTTP サービスモジュール:DataKit は Telegraf/Prometheus などのサードパーティデータの取り込みをサポートしており、今後さらに多くのデータソースを取り込めるようになります。現在、これらのデータはすべて HTTP 経由で取り込まれます。
- IO モジュール:各データ収集プラグインは、収集が完了するたびにデータを IO モジュールに送信します。IO モジュールは、統一されたデータ構築・処理・送信インターフェースをカプセル化しており、各収集プラグインが収集したデータの取り込みを容易にします。また、IO モジュールは一定のリズム(定期・定量)で HTTP(s) を介して DataWay にデータを送信します。
- 収集レイヤー:さまざまなデータの収集を担当します。収集タイプに応じて以下の2種類に分けられます:
- アクティブ収集型:このタイプの収集プラグインは、設定された固定頻度で収集を実行します。例:CPU、NIC トラフィック、Synthetic テストなど。
- パッシブ収集型:このタイプの収集プラグインは、通常、外部データ入力によって収集を実現します。例:RUM、Tracing など。これらは一般に DataKit の外部で動作し、DataKit が公開するデータアップロード API を通じて、データを一定の標準化処理してから Guance にアップロードします。
Guance プラットフォーム
強力なデータ収集能力に基づき、「Guance」は、インフラストラクチャー、コンテナ、ミドルウェア、データベース、メッセージキュー、アプリケーショントレーシング、フロントエンドアクセス、システムセキュリティ、ネットワークアクセスパフォーマンスにわたるエンドツーエンドのオブザーバビリティを構築しています。Guance の標準製品に基づき、ユーザーが DataKit の収集を正しく設定すれば、自社プロジェクトの完全なオブザーバビリティを迅速に構築できます。また、ラインプロトコル(Line Protocol)と Guance のシナリオ構築機能に基づき、ユーザーは観測したいメトリクスをカスタマイズして簡単に統合し、さらなるオブザーバビリティを実現できます。
「Guance」はオブザーバビリティを目的とした完全な技術製品として、そもそも非常に多くの技術的なハードルを抱えています。オープンソースの各種ソリューションと比較して、Guance は当初から、ユーザーが製品を学ぶ際の学習コストを効果的に下げ、使いやすさを高めることを強く重視しています。そのため、DataKit のインストール・デプロイから設定可能なすべての機能に至るまで、Guance はユーザーの設定難易度を下げ、多くのプログラマーや運用エンジニアの習慣に合うようにしています。同時に UI 全体の使いやすさと専門性を高め、ユーザーが製品の用途とそれがもたらす価値をすぐに理解できるようにしています。
実行プラットフォームの比較
Logstash の当初の利点の1つは、JRuby で記述されているため Windows で実行できることです。Fluentd は最近まで Windows をサポートしていませんでしたが、Linux プラットフォーム中心のイベントライブラリに依存しなくなったため、現在は Windows をサポートしています。また、in_windows_eventlog プラグインを入力として使用すると、Windows イベントログを追跡できます。DataKit は Guance 製品が公式に提供するデータコレクターで、多数のデータソース収集スクリプトを内蔵し、複数のデータ取り込みをサポートしています。また、Windows、Linux、Mac オペレーティングシステム、ARM、X86 などの複数のシステムタイプをサポートし、ログ収集においては全プラットフォーム互換を実現しています。
Logstash
Linux と Windows
Fluentd
Linux と Windows
DataKit
全プラットフォームをサポートし、クライアントで視覚的に設定を管理できるため、インストール・デプロイと複雑な設定の学習コストを大幅に削減できます。
イベントルーティングの比較
イベントルーティングの設定に関しては、Fluentd の方法はより宣言的であるのに対し、Logstash の方法は手続き的です。そのため、手続き型プログラミングのトレーニングを受けた開発者にとっては、Logstash の設定の方が入門しやすいと感じられるかもしれません。また、Fluentd のタグベースのルーティングは、複雑なルーティングを明確に表現できます。一方、Guance は、完成された製品ロジックと強力な製品コンポーネントに基づき、他の製品に依存せずにイベントアラートやデータ閲覧などの機能を実現でき、真の観測クローズドループを実現します。データの安全性を確保しつつ、複雑な設定を回避して優れたユーザー体験を提供します。
Logstash のイベントルーティング
Logstash はすべてのデータを1つのストリームにルーティングし、if-then ステートメントを使用して目的の宛先に送信します。以下は、本番環境のエラーイベントを PagerDuty に送信する例です:
Fluentd のイベントルーティング
Fluentd はタグに依存してイベントをルーティングします。各 Fluentd イベントには、Fluentd にどこへルーティングするかを指示するタグが付いています。本番環境でエラーイベントを PagerDuty に送信する場合の設定は次のとおりです:
<source>
  @type forward
</source>

<filter app.**>
  @type record_transformer
  <record>
    hostname "#{Socket.gethostname}"
  </record>
</filter>

<match app.**>
  @type file
  # ...
</match>
DataKit プロキシ
DataKit は、Guance の強力な製品コンポーネントの一環として、データを直接クラウド上の Guance プラットフォームに送信して観測・分析を行います。LogStash や Fluentd のように、データを他のツールに転送して分析・キャッシュなどを実行するためのイベントルーティングを用意する必要はありません。もちろん、DataKit はユーザーデータの安全性を確保しつつ、インターネットにアクセスできない内部ネットワーク環境にデプロイされている場合にプロキシサーバーを介してインターネットにアクセスする必要がある問題も解決します。DataKit のプロキシ設定は非常に簡単で、プロキシオプションを有効にするだけで、簡単な設定で豊富な製品機能を利用できます。
プラグインエコシステムの比較
Logstash、Fluentd、DataKit は、いずれも多数の入力システム(ファイルや TCP/UDP など)やフィルター(フィールドごとの分割・フィルタリング)をカバーする豊富なプラグインエコシステムを備えています。
Logstash プラグイン
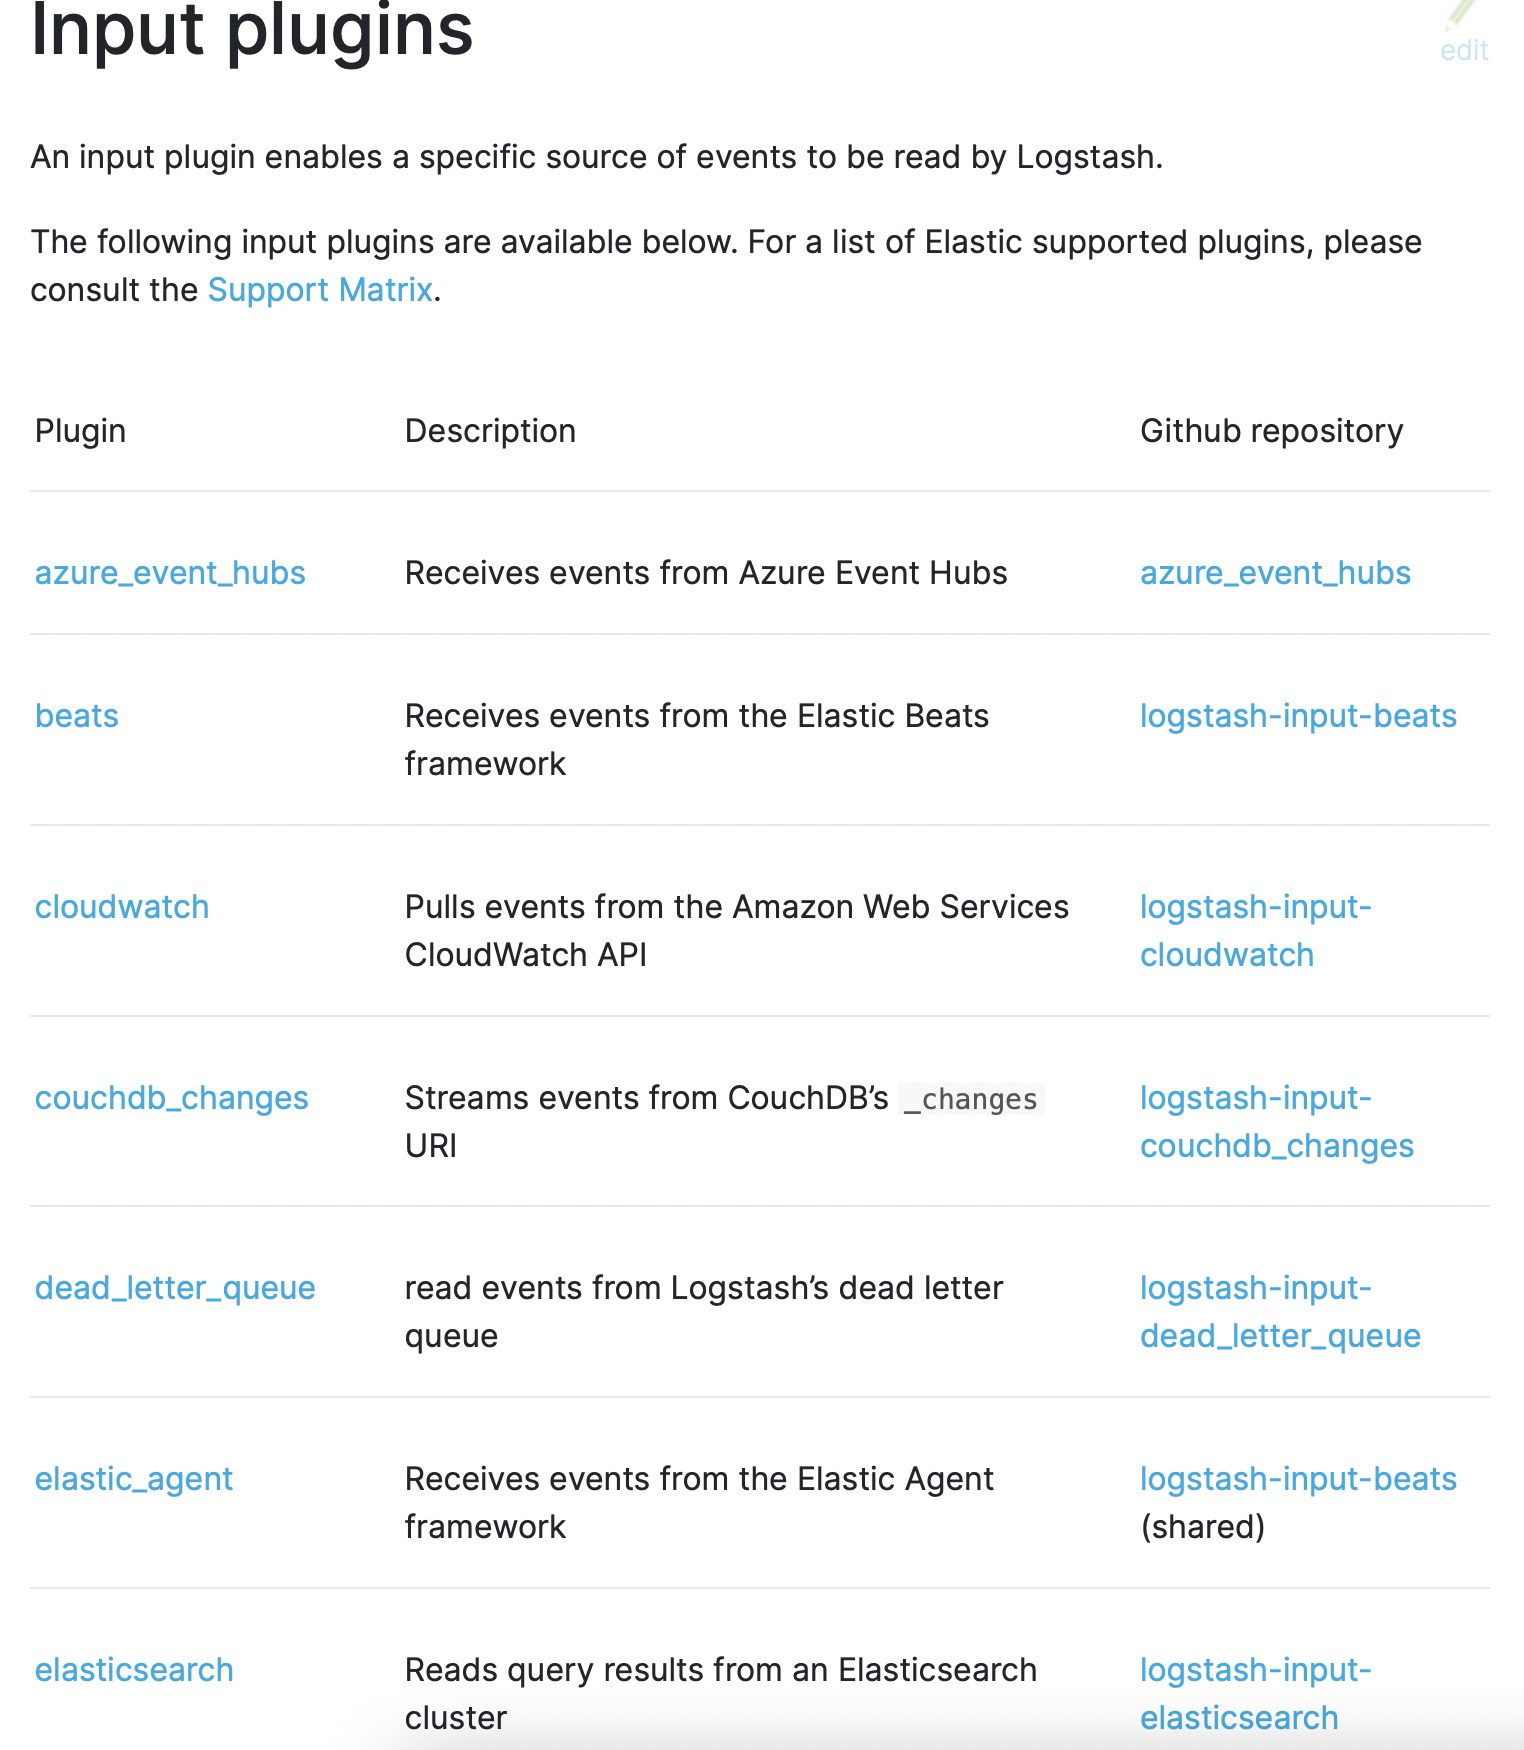
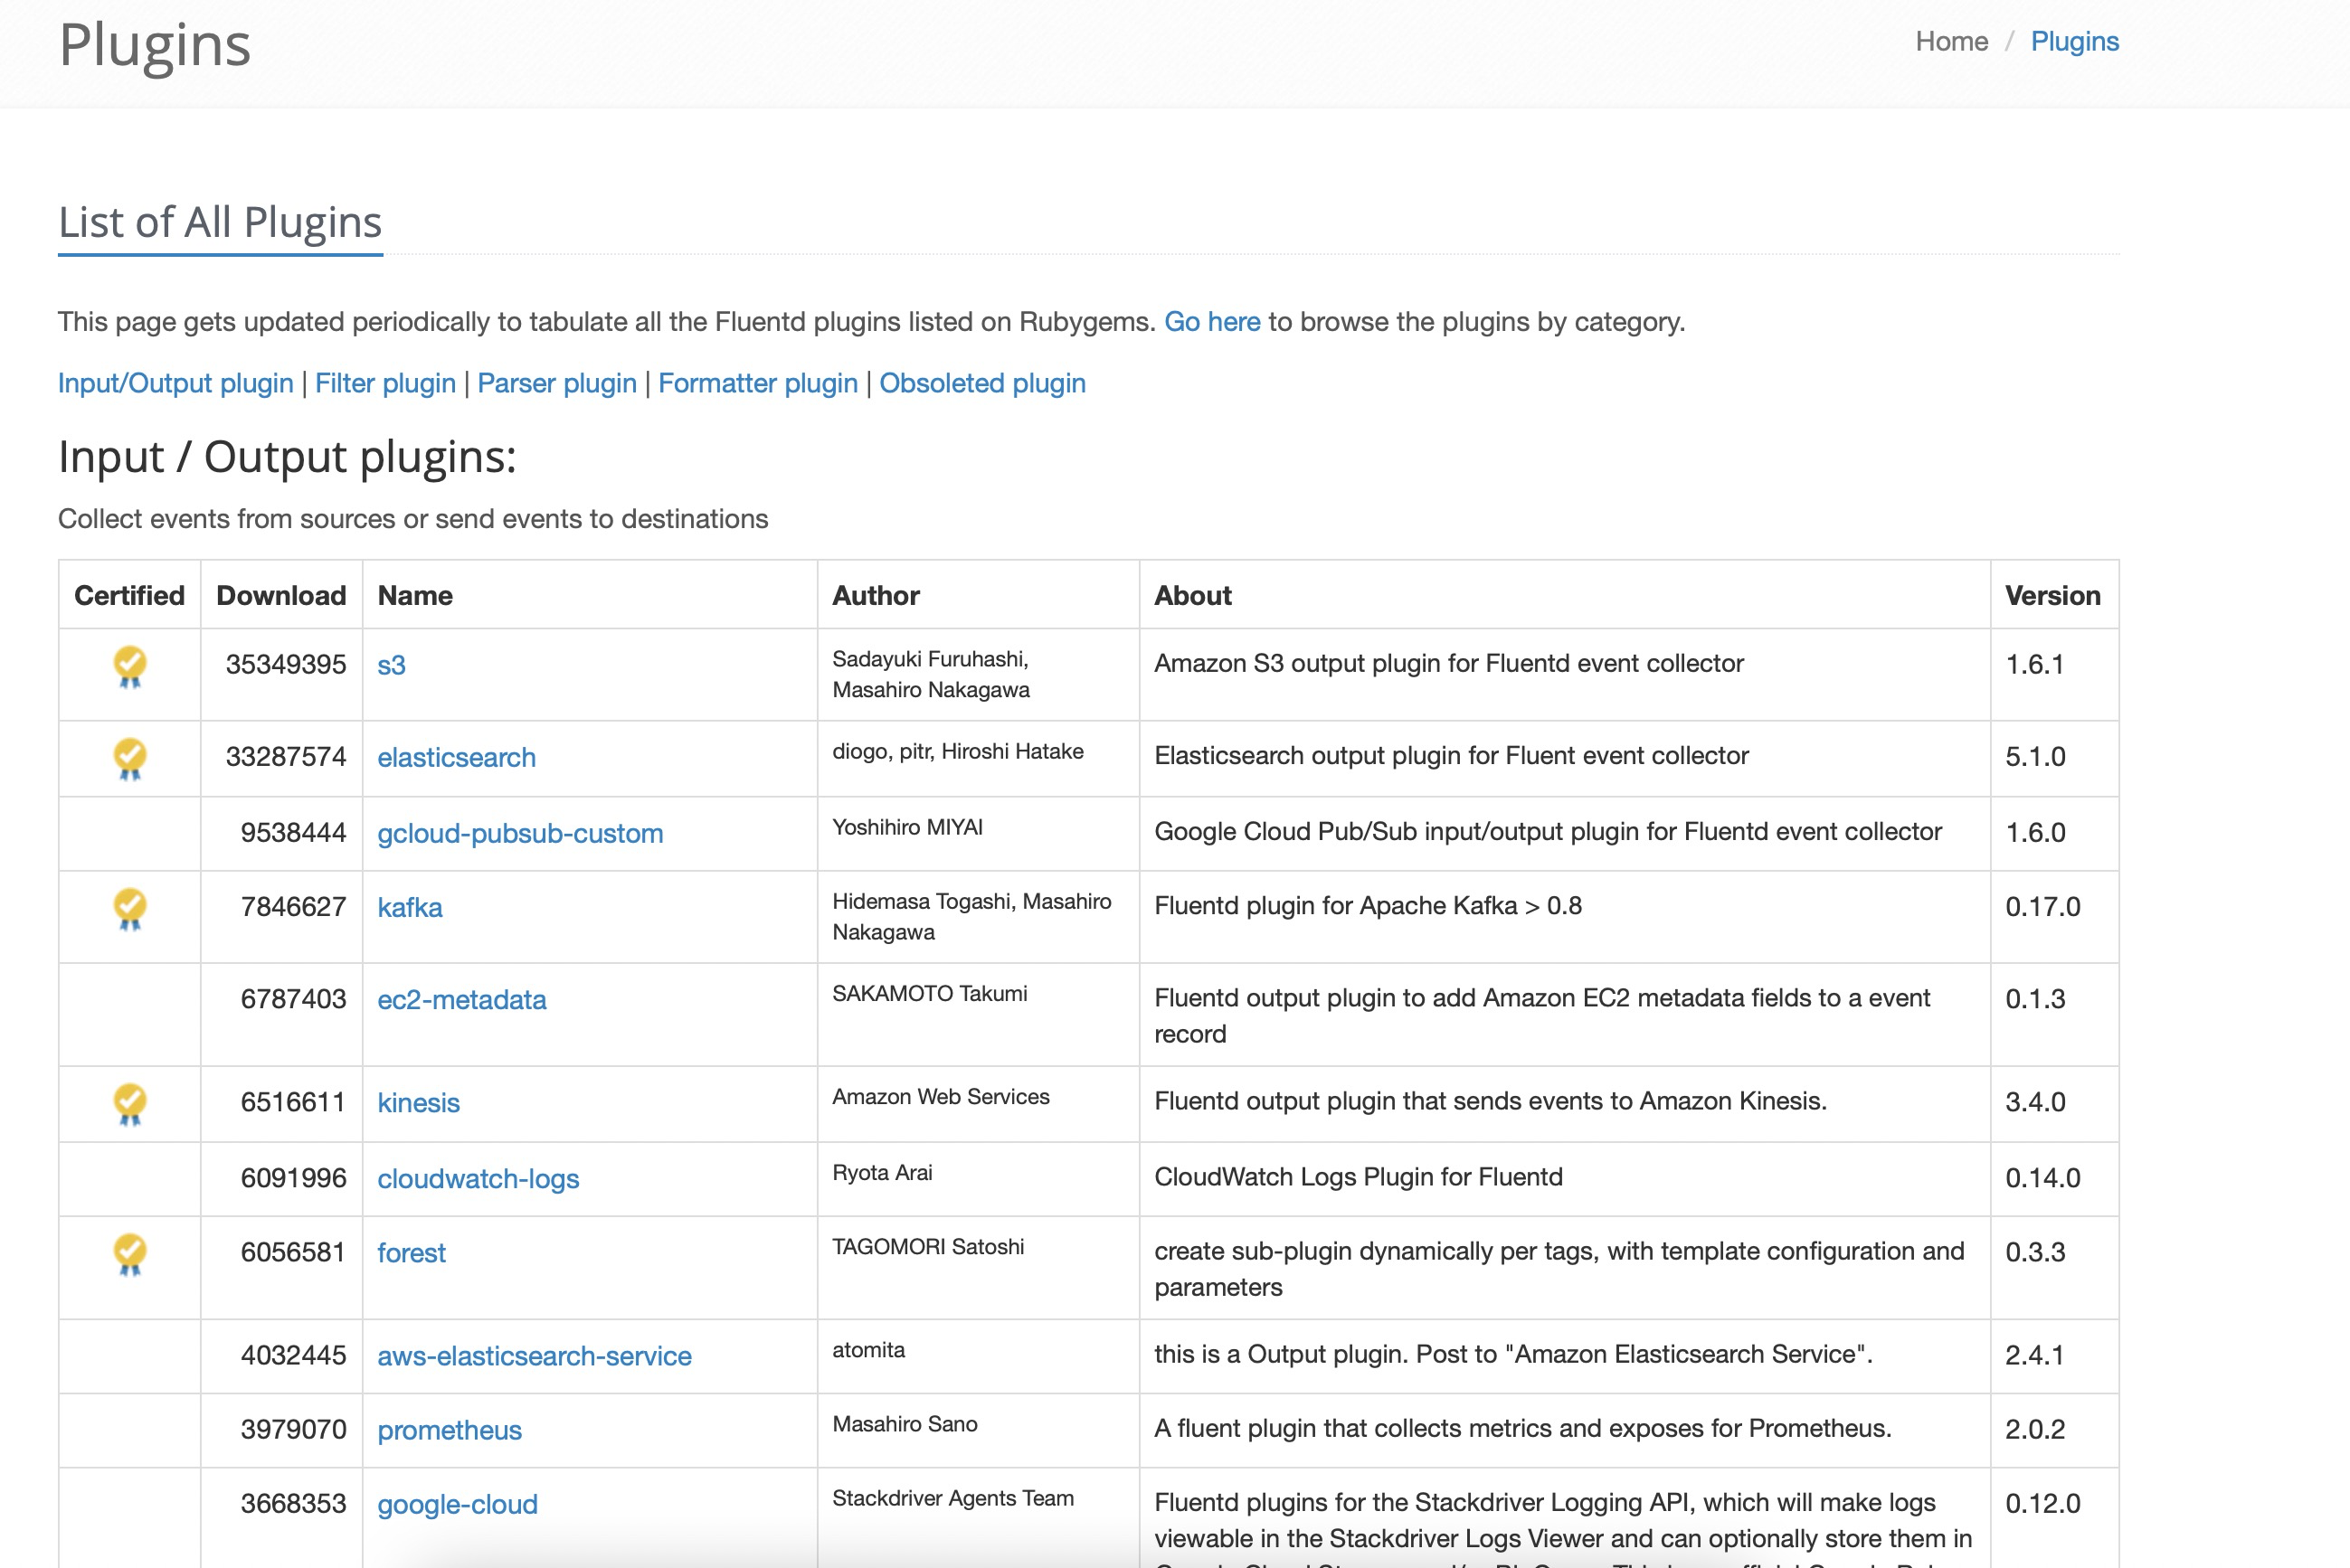
Logstash は GitHub リポジトリで全プラグインを管理しています。inputs、filter、output プラグインは合計 200 以上ありますが、ユーザーが共同でメンテナンスしており、公式のメンテナンス・ホスティングが不足しています。
Fluentd プラグイン
Fluentd には、入力、パーサー、フィルター、出力、フォーマッター、ストレージ、サービスディスカバリー、バッファーの 8 種類のプラグインがあり、合計 500 以上のプラグインが含まれています。ただし、公式がホストしているのはそのうちの 10 個のみで、残りはユーザーが共同でメンテナンスしており、公式のメンテナンス・ホスティングやテクノロジースタックのサポートが不足しています。
DataKit プラグイン
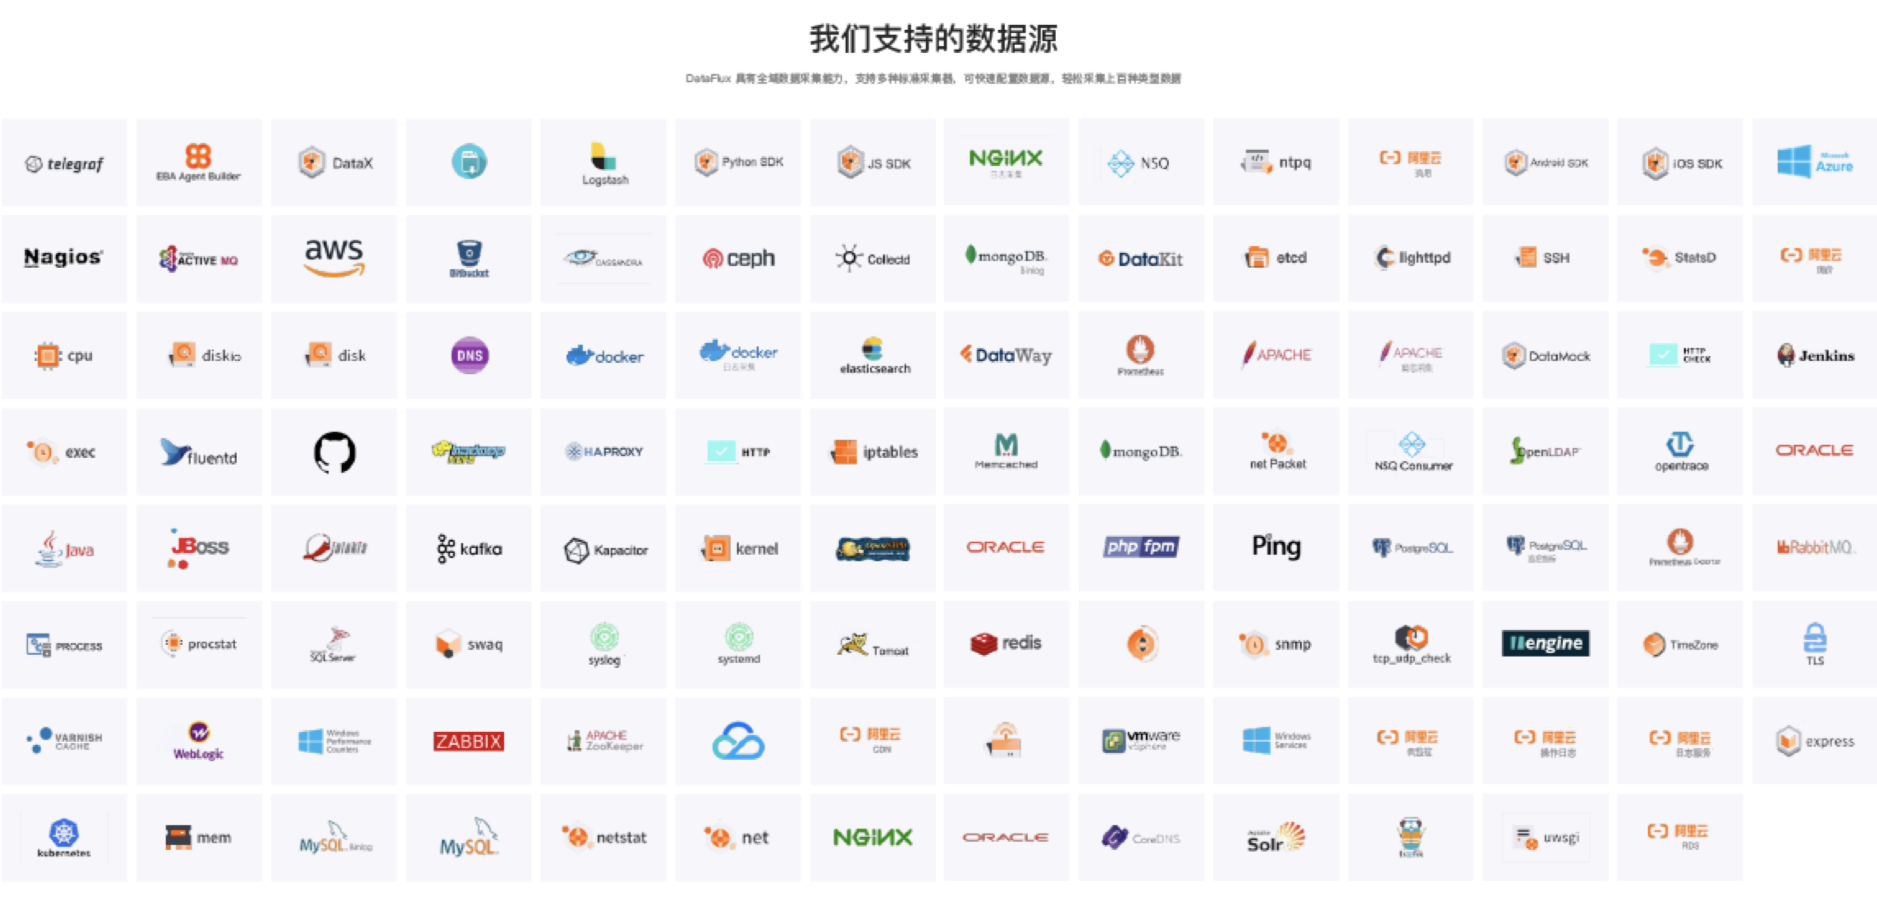
DataKit には、動的な grok 構文のクエリ・デバッグ、独自構文 DQL に基づく高速データクエリ、リアルタイムの inputs 収集実行の観測、エッジコンピューティング機能、ビジュアルなクライアント方式での設定・デプロイ・収集ソース管理など、強力な組み込み機能が含まれています。また、200 以上の公式メンテナンス済みデータソースの取り込みとテクノロジースタックのサポートに加え、Telegraf、Beats、Logstash、Fluentd などのさまざまな外部データ取り込みとも互換性があります。さらにユーザーにとってより使いやすい点として、クライアントで視覚的にプラグインとエージェントを管理でき、データ収集状況をリアルタイムで確認できます。
キューの比較
Logstash には永続的な内部メッセージキューがありません。現在、Logstash には 20 個のイベント(固定サイズ)を保持できるメモリキューがあり、再起動時の永続化ストレージとして Redis などの外部キューに依存しています。Fluentd には設定可能なバッファリングシステムがあり、メモリ上またはディスク上に置くことができますが、その信頼性の設定は比較的複雑です。DataKit には組み込みのキャッシュメカニズムがあり、サーバー設定に応じて簡単なパラメータを変更するだけでデータキャッシュの効果を得られます。
Logstash のキュー
Logstash には永続性のあるメッセージキューが組み込まれていないため、組み込みのキューモデルは非常にシンプルで、永続性を確保するには Redis などの外部キューが必要です。
Fluentd キュー
Logstash と比較して、Fluentd は信頼性が組み込まれていますが、設定が比較的複雑で、ユーザーの学習コストが高くなります。
DataKit のキュー
DataKit には組み込みのキャッシュメカニズムがあります。DataKit をデプロイしたサーバーが何らかのネットワーク上の理由で DataWay への送信に失敗した場合、DataKit はデフォルトで最大1,000ポイントのデータをキャッシュしてデータ損失を防ぎます。また、DataKit の設定ファイルを変更して最大キャッシュ量を制御することもできます。設定は簡単で使用ハードルが低く、学習コストはほぼゼロです。
ログ解析の比較
ログ分析は企業内部における基礎的な中核技術であり、セキュリティチームだけでなく、IT 開発チームやビジネスチームでも活用されています。セキュリティの観点では、セキュリティチームがログを抽出して分析する主な目的は、未知のセキュリティイベントの発見と、既知のセキュリティイベントのトレーサビリティ分析です。もう1つの重要な目的は、国レベルの監督・コンプライアンス要件です。IT 開発の観点では、企業内部の非セキュリティ技術チームがログ分析を行う主な目的も、未知の問題の発見と既知の問題の分析であり、その内容は主にシステム監視、APM(APM には開発チームが注目するすべての監視項目が含まれます)に集中しています。ビジネスの観点では、ビジネスチームのログ分析のニーズは、リスク管理、運営・プロモーション、ユーザープロファイリング、サイトプロファイリングなどに集中しています。つまり、ログはハードディスクに保存されているだけでは価値がなく、ログ分析技術によってログ情報の価値を実現できます。ログの価値が高く発揮されるほど、会社の技術力の高さを間接的に反映することにもなります。
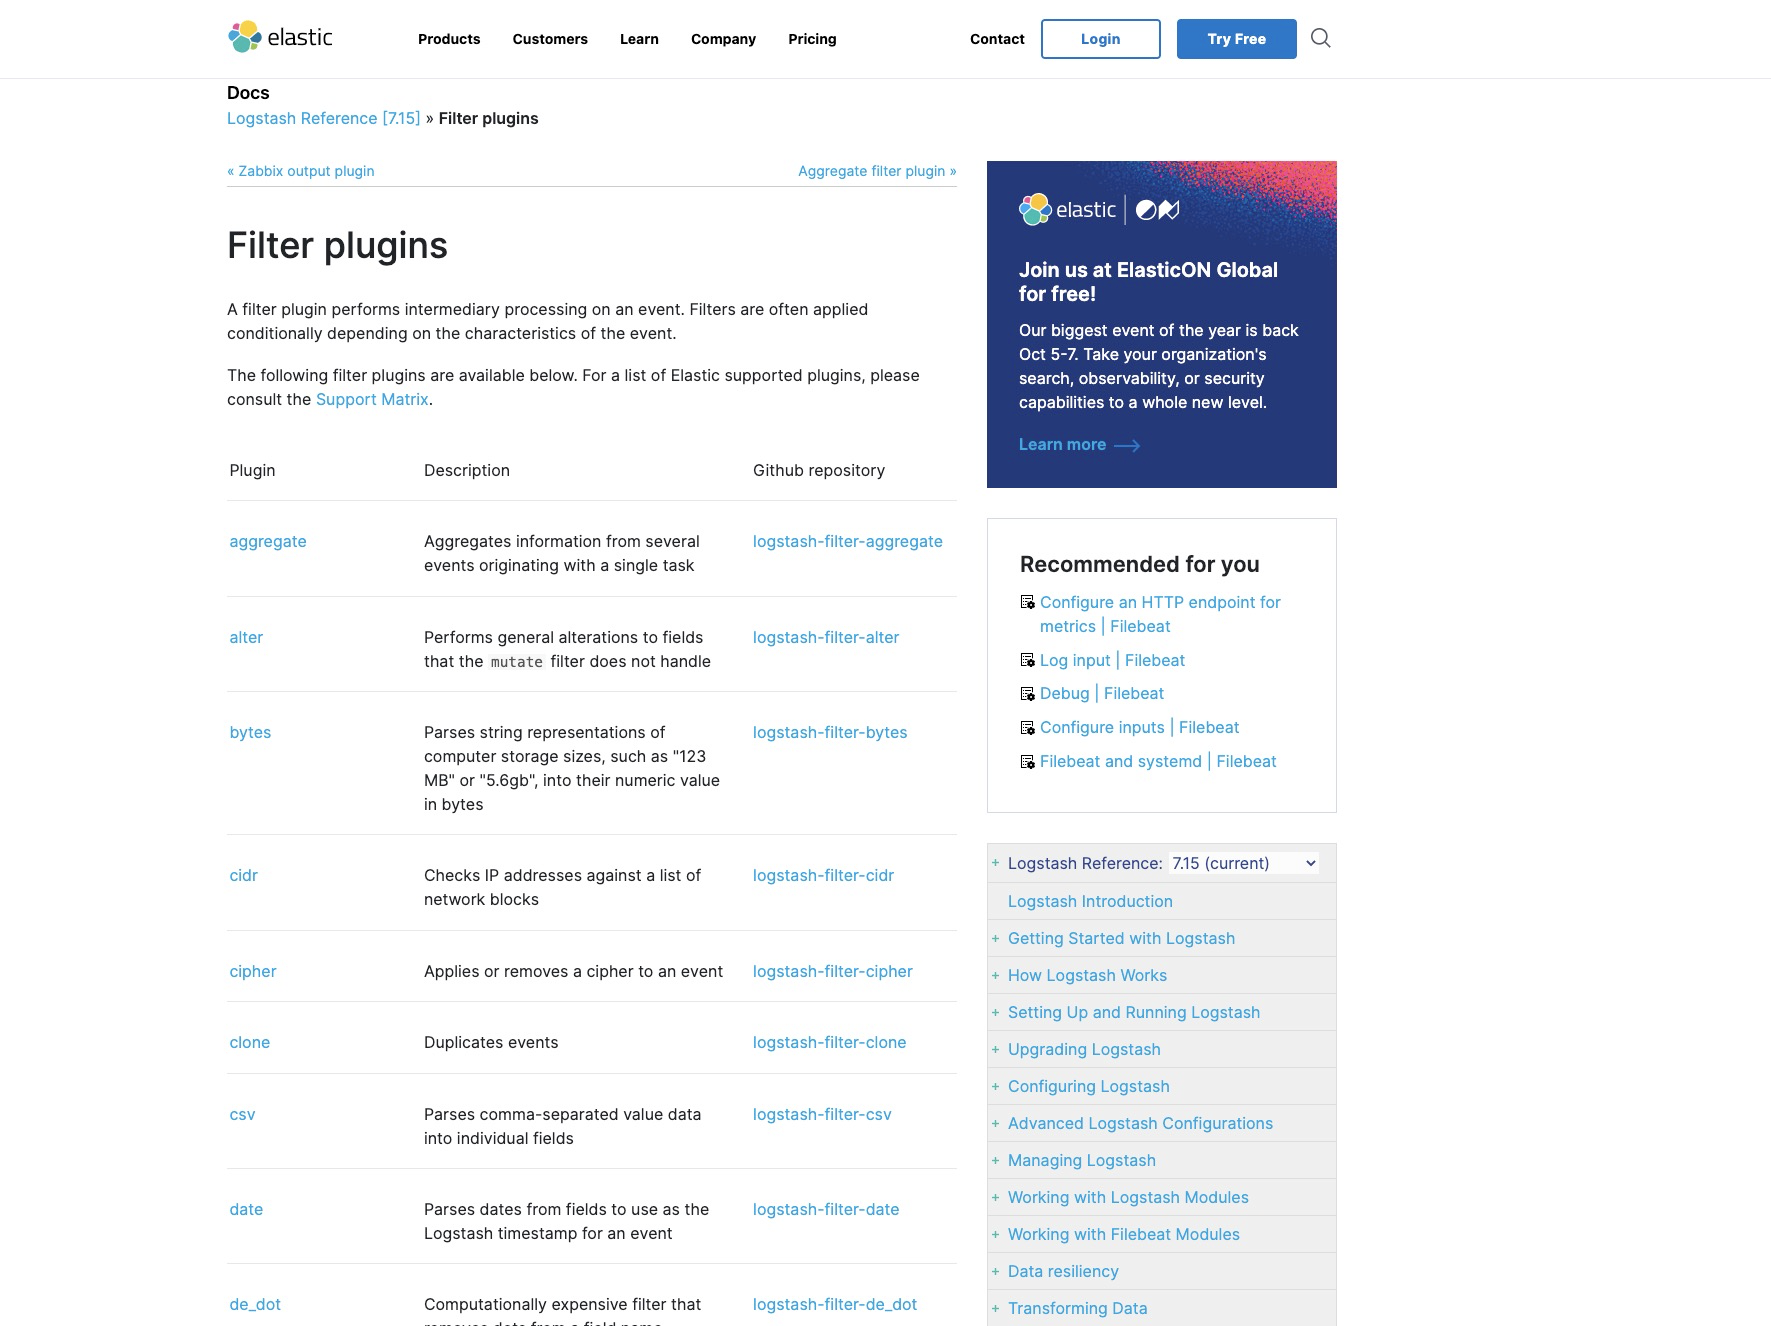
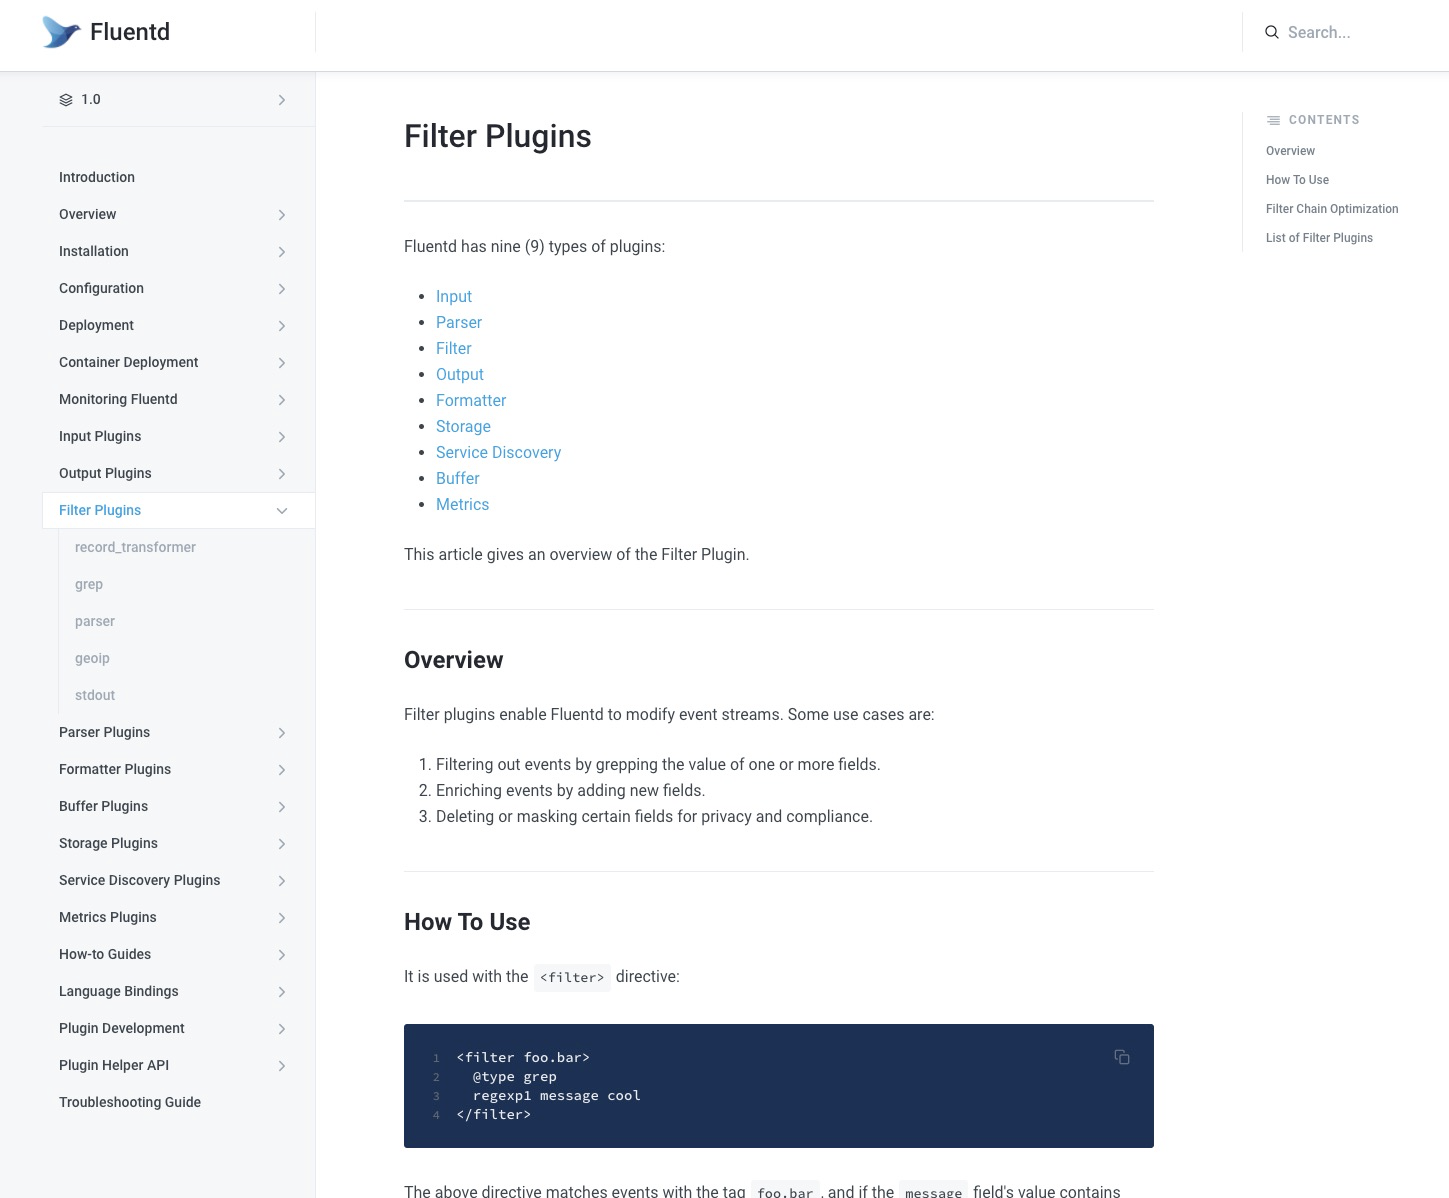
一般的に、Logstash には、grok による任意テキストの解析・構築、mutate によるイベントフィールドの一般的な変換、drop によるイベントの完全削除、clone によるイベントのコピー作成、geoip による IP アドレスの地理位置情報の追加など、一般的なパーサーが含まれています。一方、Fluentd のログ解析で一般的な操作は、1つ以上のフィールドの値を検索してイベントをフィルタリングする、新しいフィールドを追加してイベントをリッチ化する、プライバシーとコンプライアンス保護のために特定のフィールドを削除またはマスクする、といったものです。ただし、関連プラグインは比較的少なく、record_transformer、filter_stdout、filter_grep、parser、filter_geoip の5つのプラグインのみです。DataKit のログ解析には、非構造化テキストデータのパースや構造化テキスト(JSON など)からの部分情報抽出に使用する Pipeline が含まれています。また、glob ルールによるログファイル指定の簡略化、自動検出とファイルフィルタリング、使いやすい対話式 Grok マッチングツールによる grok 使用ハードルの低下、多数のスクリプト関数によるデータ形式の柔軟化など、さらに多くの機能を備えています。
Logstash のログ解析
Grok は、現在の Logstash において非構造化ログデータを構造化された検索可能なコンテンツに解析する最良の方法です。現在 Logstash には 120 種類の grok 解析テンプレートが組み込まれていますが、Logstash が GitHub リポジトリで管理している grok 解析テンプレートはユーザーが共同でメンテナンスしており、公式のテクニカルサポートが不足しています。grok テンプレートのパフォーマンスチューニングを含む多くの業務ニーズについても、ユーザー自身で調査する必要があります。
Fluentd のログ解析
Fluentd のログ解析方式は Logstash と似ていますが、設定方法はより柔軟です。ただし、対応する grok 解析テンプレートは提供されておらず、設定例がいくつか提供されているだけです。ユーザーはドキュメントの例に基づいて解析機能を自分で設定する必要があり、比較的使用ハードルが高くなります。設定中に発生する問題に対する公式のテクニカルサポートも不足しており、ユーザー自身が Google で調べて解決しなければならないことがほとんどです。
同じ構成のサーバー環境では、Nginx のアクセスログをサンプルとして使用します。以下に示す1件のログは 365 バイトで、14個のフィールドに構造化されます:
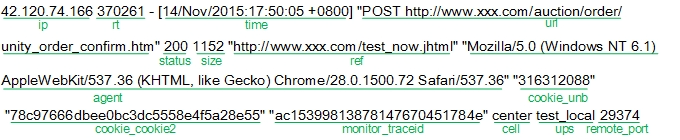
以降のテストでは、さまざまな負荷をシミュレートしてこのログをファイルに繰り返し書き込みます。各ログの time フィールドには現在のシステム時刻を使用し、他の13個のフィールドは同じにします。
実際のシナリオと比較して、シミュレーションシナリオはログ解析に違いはありません。1つだけ違いがあるとすれば、データ圧縮率が高いほどネットワークへの書き出しトラフィックが減少する点です。
logstash
logstash-7.1.0 で、grok を使用してログを解析し、kafka(組み込みプラグイン、gzip 圧縮を有効化)に書き出します。
ログ解析設定:
grok {
patterns_dir=> "/home/admin/workspace/survey/logstash/patterns"

match=>{ "message"=>"%{IPORHOST:ip} %{USERNAME:rt} -
\"%{WORD:method} %{DATA:url}\" %{NUMBER:status} %{NUMBER:size} \"%{DATA:ref}\" \"%{DATA:agent}\" \"%{DATA:cookie_unb}\" \"%{DATA:cookie_cookie2}\" \"%{DATA:monitor_traceid}\" %{WORD:cell} %{WORD:ups} %{BASE10NUM:remote_port}" }

remove_field=>[ "message"]
}
テスト結果:
| 書き込み TPS | 書き込みトラフィック(KB/s) | CPU 使用率(%) | メモリ使用量(MB) |
|---|---|---|---|
| 500 | 178.89 | 25.3 | 432 |
| 1000 | 346.65 | 46.9 | 476 |
| 5000 | 1882.23 | 231.1 | 489 |
| 10000 | 3564.45 | 511.2 | 512 |
fluentd
td-agent-4.1.0 で、正規表現を使用してログを解析し、kafka(サードパーティプラグイン fluent-plugin-kafka、gzip 圧縮を有効化)に書き出します。
ログ解析設定:
<source>
type tail
format /^(? <ip>\S+)\s(?<rt>\d+)\s-\s\[(?<time>[^\]]*)\]\s"(?<url>[^\"]+)"\s(?<status>\d+)\s(?<size>\d+)\s"(?<ref>[^\"]+)"\s"(?<agent>[^\"]+)"\s"(?<cookie_unb>\d+)"\s"(?<cookie_cookie2>\w+)"\s"(?
<monitor_traceid>\w+)"\s(?<cell>\w+)\s(?<ups>\w+)\s(?<remote_port>\d+).*$/
time_format %d/%b/%Y:%H:%M:%S %z
path /home/admin/workspace/temp/mock_log/access.log
pos_file /home/admin/workspace/temp/mock_log/nginx_access.pos
tag nginx.access
</source>
テスト結果:
| 書き込み TPS | 書き込みトラフィック(KB/s) | CPU 使用率(%) | メモリ使用量(MB) |
|---|---|---|---|
| 500 | 174.272 | 13.8 | 58 |
| 1000 | 336.85 | 24.4 | 61 |
| 5000 | 1771.43 | 95.3 | 103 |
| 10000 | 3522.45 | 140.2 | 140 |
DataKit
DataKit-1.1.8-rc3 は、Pipeline を使用して非構造化テキストデータをパースします。
# access log
grok(_, "%{NOTSPACE:ip} %{NOTSPACE:rt} - "%{NOTSPACE:method} %{NOTSPACE:url}\" %{NOTSPACE:status} %{NOTSPACE:size} \"%{NOTSPACE:ref}\" \"%{NOTSPACE:agent}\" \"%{NOTSPACE:cookie_unb}\" \"%{NOTSPACE:cookie_cookie2}\" \"%{NOTSPACE:monitor_traceid}\" %{NOTSPACE:cell} %{NOTSPACE:ups} %{NOTSPACE:remote_port}")

cast(status_code, "int")
cast(bytes, "int")

default_time(time)
テスト結果:
| 書き込み TPS | 書き込みトラフィック(KB/s) | CPU 使用率(%) | メモリ使用量(MB) |
|---|---|---|---|
| 500 | 178.24 | 8.5 | 41 |
| 1000 | 356.45 | 13.8 | 45 |
| 5000 | 1782.23 | 71.1 | 76 |
| 10000 | 3522.45 | 101.2 | 88 |
ログ収集アーキテクチャの比較
ELK ソリューション
構成 1
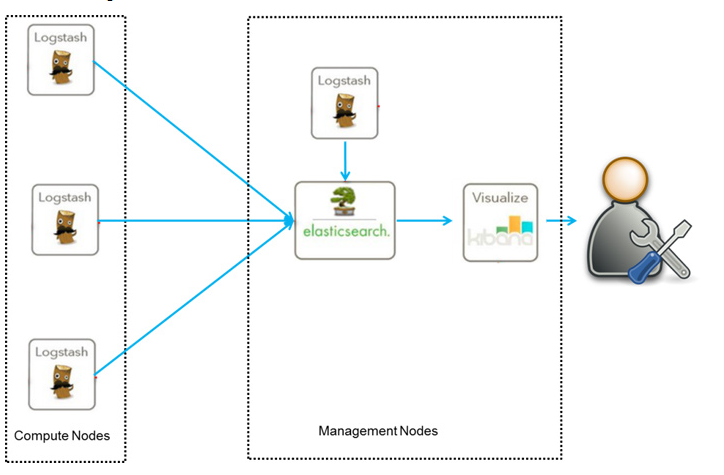
これは最もシンプルな ELK アーキテクチャの1つです。利点は、構築が簡単で習得しやすいことです。欠点は、Logstash のリソース消費が大きく、実行時の CPU とメモリの使用量が高いことです。また、メッセージキューのキャッシュがないため、データ損失のリスクがあります。利用者は Logstash、Elasticsearch、Kibana に十分精通している必要があり、複雑なビジネス上の問題を熟練して運用し解決できなければなりません。さらに、LogStash クラスターと ElasticSearch クラスターの保守担当者も、クラスターのパフォーマンス最適化とリソース管理に十分精通している必要があります。そうして初めて、ビジネスを正常に稼働させ続けることができます。
このアーキテクチャでは、Logstash が各ノードに分散配置され、関連するログやデータを収集し、分析・フィルタリング後にリモートサーバー上の Elasticsearch に送信して保存します。Elasticsearch はデータをシャード形式で圧縮保存し、ユーザーがクエリや操作を行うためのさまざまな API を提供します。ユーザーは Kibana Web を設定することで、より直感的にログを検索し、データに基づいてレポートを生成することもできます。
構成 2
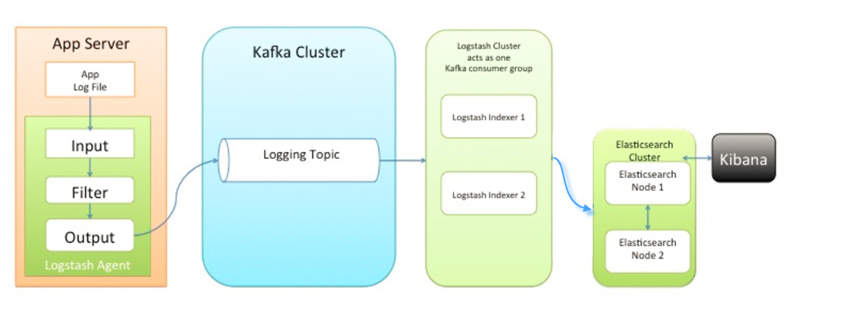
これは比較的成熟した ELK アーキテクチャです。利点は、Kafka を導入しているため、リモートの Logstash クラスターが障害で停止した場合でも、データが先に保存され、データの損失を回避できることです。欠点は、構築が複雑で、テクノロジースタックが複雑なため迅速な習得が比較的難しく、Logstash のリソース消費が大きく、実行時の CPU とメモリの使用量が高いことです。また、Kafka クラスターを追加で運用する必要があり、大規模なシナリオでは Zookeeper クラスターも追加で運用する必要がある場合があります。利用者は Logstash、Elasticsearch、Kafka、Kibana に十分精通している必要があり、複雑なビジネス上の問題を熟練して運用し解決できなければなりません。さらに、LogStash クラスター、Kafka クラスター、ElasticSearch クラスターの保守担当者も、クラスターのパフォーマンス最適化とリソース管理に十分精通している必要があります。そうして初めて、ビジネスを正常に稼働させ続けることができます。
このアーキテクチャではメッセージキューメカニズムが導入されており、各ノード上の Logstash Agent がまずデータ・ログを Kafka(または Redis)に渡し、キュー内のメッセージやデータを間接的に Logstash に渡します。Logstash はフィルタリング・分析後にデータを Elasticsearch に渡して保存します。最後に Kibana がログとデータをユーザーに表示します。Kafka(または Redis)を導入しているため、リモートの Logstash サーバーが障害で停止した場合でも、データは先に保存され、データ損失を回避できます。
EFK ソリューション
構成 1
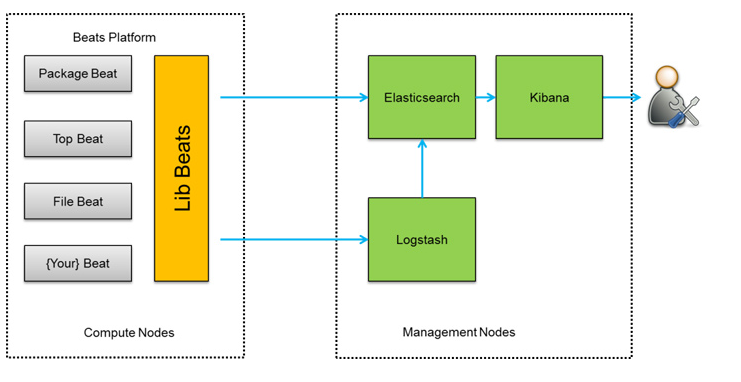
これはより柔軟な EFK アーキテクチャです。利点は、より柔軟で、Logstash と比較してリソース消費が少なく、拡張性が高いことです。欠点は、ログを LogStash クラスターに送信して集中的に処理するには、大規模な LogStash クラスターによる計算能力のサポートが必要になることです。また、利用者は Logstash、Elasticsearch、Kibana に十分精通している必要があり、複雑なビジネス上の問題を熟練して運用し解決できなければなりません。さらに、LogStash クラスターと ElasticSearch クラスターの保守担当者も、クラスターのパフォーマンス最適化とリソース管理に十分精通している必要があります。そうして初めて、ビジネスを正常に稼働させ続けることができます。
このアーキテクチャでは、収集側の Logstash を Filebeat に置き換え、Logstash クラスターと Elasticsearch クラスターを設定して、大規模クラスターシステムの運用ログデータの監視とクエリをサポートします。
構成 2
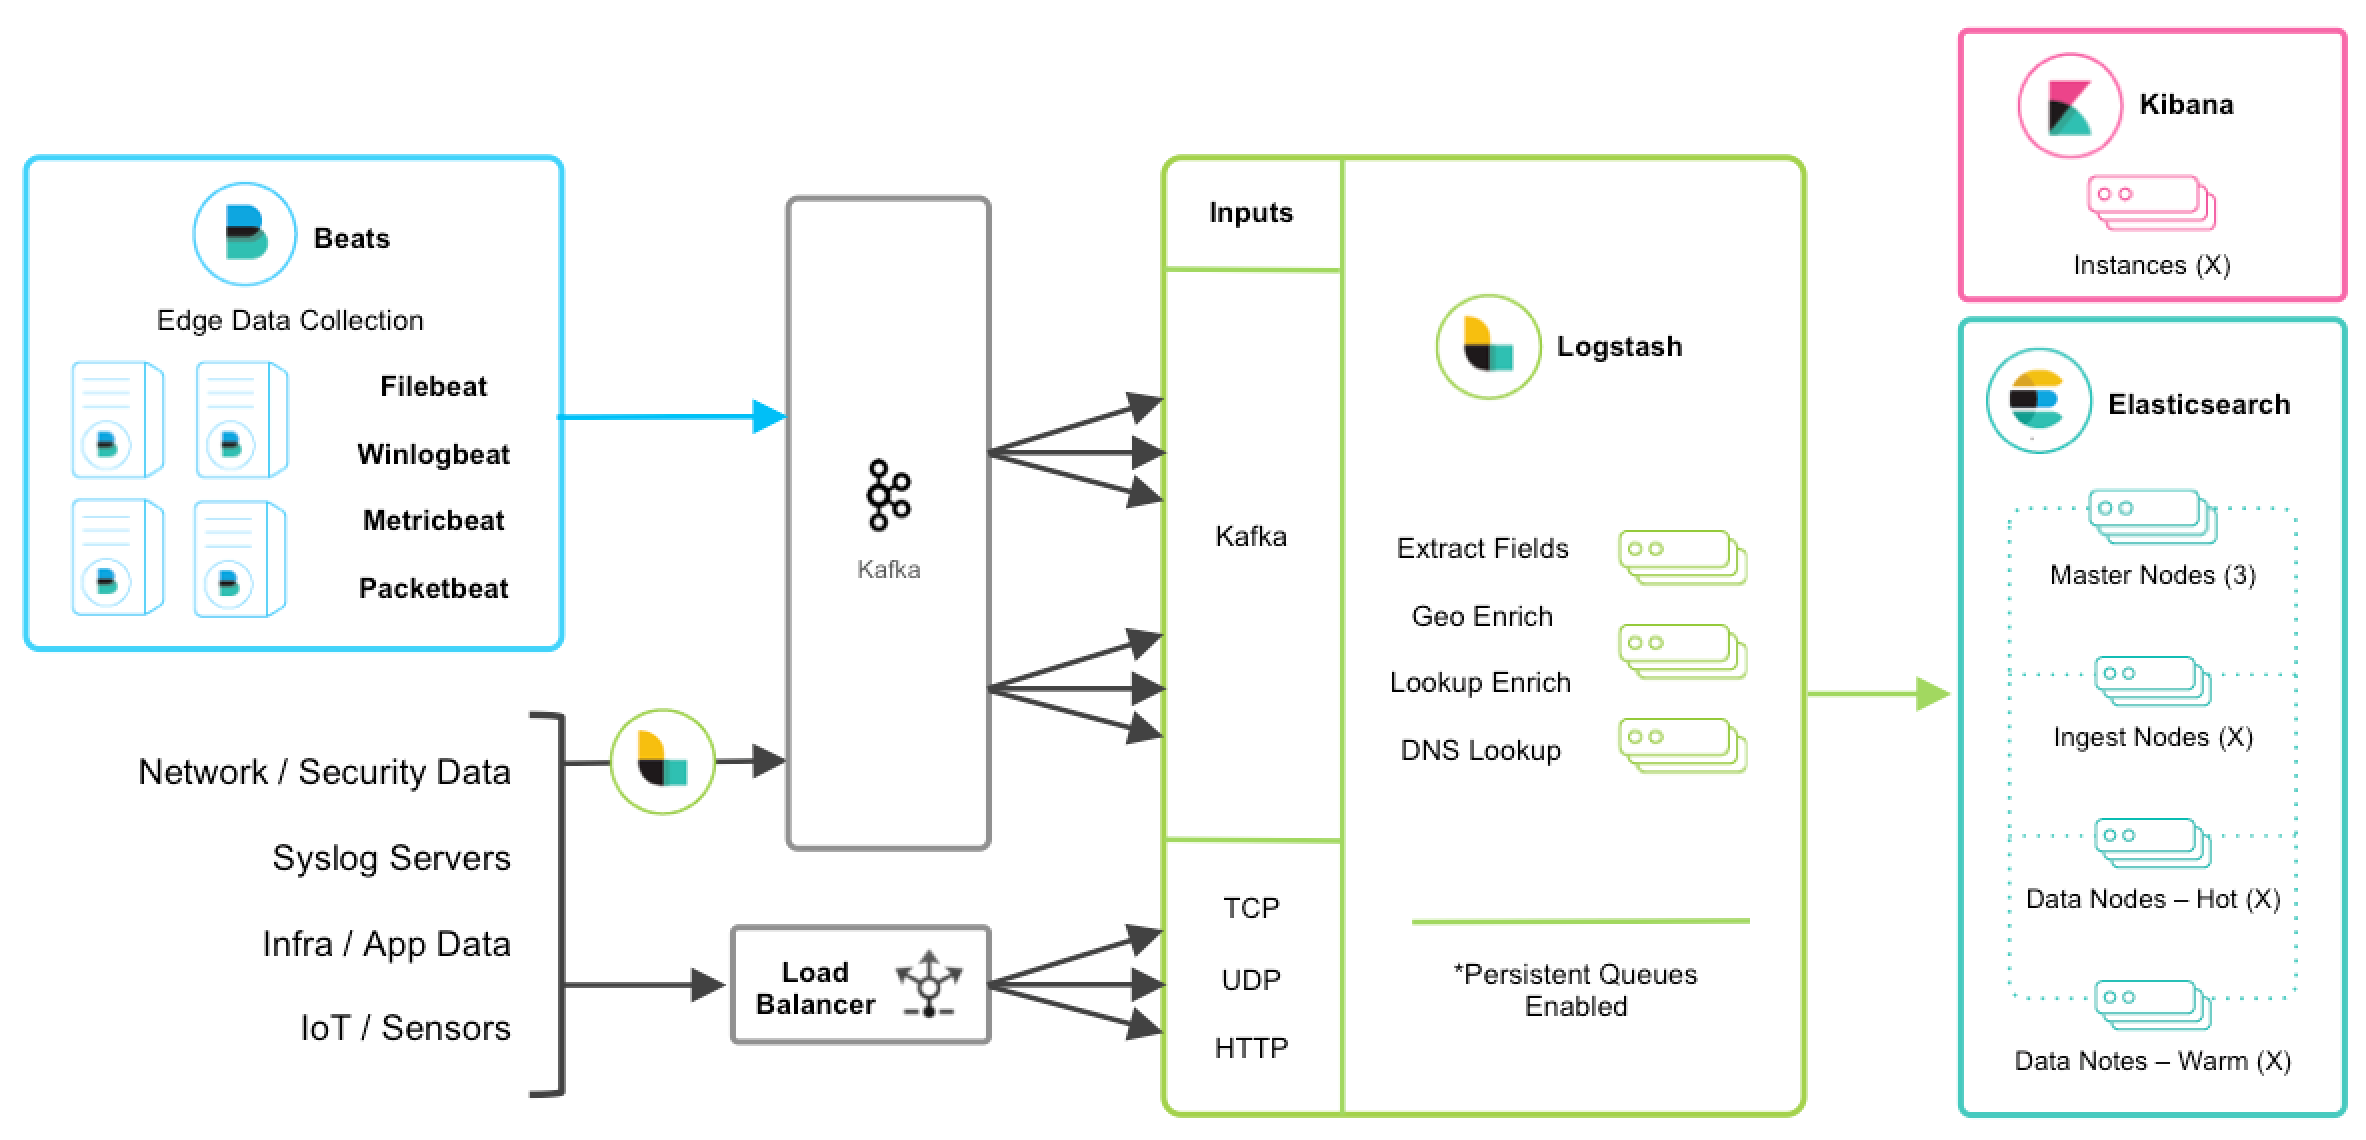
ELK をベースに、ログ収集側として Filebeat を採用しています。利点は、ELK のアーキテクチャのように Logstash をログ収集側として使用する場合、Logstash は Java 環境に基づいているため正常に使用するには各サーバーに Java 環境をインストールする必要がありますが、採用する Filebeat には依存関係がなく、インストール後に設定ファイルを変更してサービスを起動するだけです。欠点は、テクノロジースタックが複雑で迅速な習得が比較的難しく、Logstash のリソース消費が大きく、実行時の CPU とメモリの使用量が高いことです。また、Kafka クラスターを追加で運用する必要があり、大規模なシナリオでは Zookeeper クラスターも追加で運用する必要がある場合があります。利用者は Filebeat、Logstash、Elasticsearch、Kafka、Kibana に十分精通している必要があり、複雑なビジネス上の問題を熟練して運用し解決できなければなりません。さらに、LogStash クラスター、Kafka クラスター、ElasticSearch クラスターの保守担当者も、クラスターのパフォーマンス最適化とリソース管理に十分精通している必要があります。そうして初めて、ビジネスを正常に稼働させ続けることができます。
このアーキテクチャでは、収集側がログファイルを収集する際、Filebeat の input で fields を定義し、log_topic フィールドを定義して、指定パス配下のログファイルを1つのカテゴリに分類します。Output では、Kafka への出力を指定します。Kafka はメッセージキューとして、Filebeat クライアントから収集されたすべてのログを受信し、ログの種類(nginx、php、system など)に応じて分類して転送します。Kafka では、input でカスタム定義したログタイプに基づいて、異なる topic を作成します。Logstash は Kafka メッセージキューからメッセージを受信し、Kafka 内の異なる topic に応じてログを分類して Elasticsearch に書き込みます。Kibana は Elasticsearch のインデックスをマッチングして、ログコンテンツの分析、検索、グラフ表示を行うことができます(もちろん、グラフは自分で設計する必要があります)。
構成 3
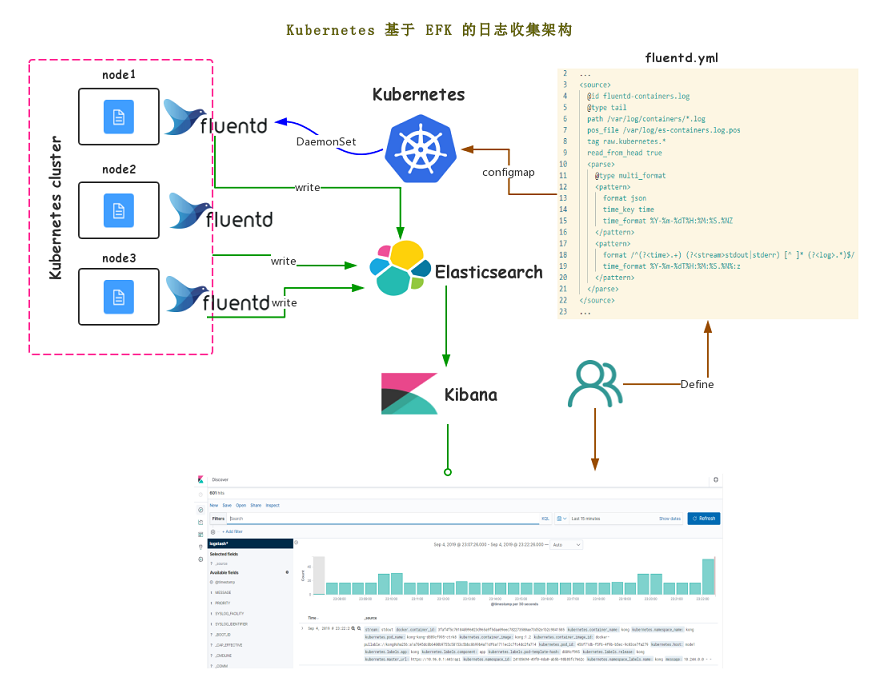
ログ収集側として Fluentd を採用します。利点は、Fluentd のリソース使用量が LogStash クラスターよりはるかに少なく、アーキテクチャをよりシンプルで柔軟にできることです。欠点は、Fluentd の設定が比較的複雑で使用ハードルが比較的高く、迅速な習得が難しいこと、設定ファイルが比較的複雑で変更が面倒なことです。利用者は Fluentd、Elasticsearch、Kibana に十分精通している必要があり、複雑なビジネス上の問題を熟練して運用し解決できなければなりません。さらに、ElasticSearch クラスターの保守担当者も、クラスターのパフォーマンス最適化とリソース管理に十分精通している必要があります。そうして初めて、ビジネスを正常に稼働させ続けることができます。
このアーキテクチャでは、Fluentd がプログラムのログを収集し、ログを Elasticsearch クラスターに保存し、最後に Kibana で Elasticsearch を連携させてログのクエリを実現します。
Guance のアーキテクチャ
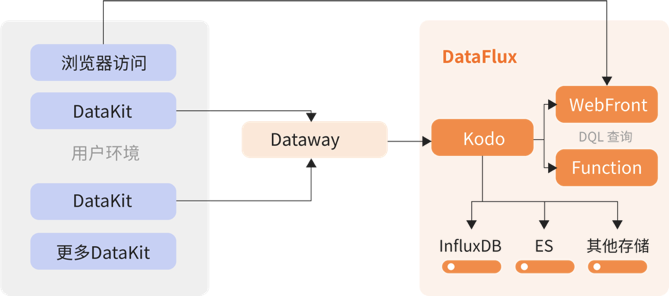
DataKit は基礎的なデータ収集ツールとして、主にシステムの稼働中に生成されるさまざまなメトリクスやログなどのデータを収集し、Dataway を介して Guance に集約します。Guance では、ユーザーは自分のさまざまなメトリクスやログなどのデータを表示・分析できます。DataKit は Guance において極めて重要なデータ収集コンポーネントであり、Guance 内のすべてのデータは DataKit に由来します。
DataKit のデプロイ設定は非常にシンプルで明確であり、ビジュアルなクライアントを通じてユーザーが DataKit を管理するのを支援します。DataKit はログデータの収集だけでなく、APM データ、インフラストラクチャー、コンテナ、ミドルウェア、ネットワークパフォーマンスなどもカバーしています。DataKit は、LogStash や Fluentd のように Elasticsearch、Kafka などのコンポーネントに依存してビジネス機能を補完する必要はありません。Guance はこれらの問題をまったく考慮する必要がなく、ユーザーは本当に自社のビジネス最適化だけに集中できます。DataKit は、利用者が複雑なテクノロジースタックを習得して高い学習コストを払う必要もなく、簡単な設定だけで Guance と組み合わせてさまざまな複雑なビジネス上の問題を解決できます。ELK と EFK は全体の運用コストが莫大で、ElasticSearch クラスターだけで多額の費用がかかります。コスト削減のためにホットデータとコールドデータを考慮するのも頭痛の種ですが、Guance を使用すればこれらの問題を考える必要はなく、ビジネスに集中するだけでよいのです。
ハードウェアコストの比較
価格は誰もが非常に気にする要素です。ここではクラウドサービスを利用して、ELK、EFK、Guance のコストを比較します。
ELK のコスト
Elastic の基本コンポーネントはすべてオープンソースであり、主な費用はハードウェアコストに由来します。ここでは、異なるアーキテクチャ構成で10台のサーバーからログを収集し、各サーバーで1日あたり1GB のログ量としてコストを計算します。
LogStash クラスター + Kafka クラスター + ElasticSearch クラスター + Kibana
- LogStash クラスター
| 課金項目 | 値 | 単価 | 費用(元) |
|---|---|---|---|
| サーバー | 1台(2コア 4GB) | 月額費用: 216.7元/月 | 216.7 |
| ストレージ | 50GB | ESSD: 0.5元/GB | 25 |
| 合計 | 241.7 |
- Kafka クラスター
| 課金項目 | 値 | 単価 | 費用(元) |
|---|---|---|---|
| サーバー | 3台(4コア 16GB) | 月額費用: 788元/月 | 2364 |
| ストレージ | 200GB | ESSD: 0.5元/GB | 300 |
| 合計 | 2664 |
- ElasticSearch クラスター
| 課金項目 | 値 | 単価 | 費用(元) |
|---|---|---|---|
| サーバー | 3台(2コア 8GB) | 月額費用: 383元/月 | 1149 |
| ストレージ | 500GB | ESSD: 0.5元/GB | 750 |
| 合計 | 1899 |
- Kibana ノード
| 課金項目 | 値 | 単価 | 費用(元) |
|---|---|---|---|
| サーバー | 1台(1コア 2GB) | 月額費用: 104元/月 | 104 |
| ストレージ | 50GB | ESSD: 0.5元/GB | 25 |
| 合計 | 129 |
ビジネス規模が大きくないストレージとサーバー構成で計算すると、LogStash + Kafka + ElasticSearch + Kibana の月間総費用は 5175.4(元)です。
シンプルなアーキテクチャで Kafka クラスターを使用しない場合、LogStash + ElasticSearch + Kibana の月間総費用は 2511.4(元)です。
EFK のコスト
Elastic の基本コンポーネントはすべてオープンソースであり、主な費用はハードウェアコストに由来します。ここでは、異なるアーキテクチャ構成で10台のサーバーからログを収集し、各サーバーで1日あたり1GB のログ量としてコストを計算します。
Fluentd + ElasticSearch クラスター + Kibana
- Fluentd
Fluentd はクラスターとして単独でデプロイする必要がないため、Fluentd のコストは考慮せず、ElasticSearch + Kibana のみを計算します。
- ElasticSearch クラスター
| 課金項目 | 値 | 単価 | 費用(元) |
|---|---|---|---|
| サーバー | 3台(2コア 8GB) | 月額費用: 383元/月 | 1149 |
| ストレージ | 500GB | ESSD: 0.5元/GB | 750 |
| 合計 | 1899 |
- Kibana ノード
| 課金項目 | 値 | 単価 | 費用(元) |
|---|---|---|---|
| サーバー | 1台(1コア 2GB) | 月額費用: 104元/月 | 104 |
| ストレージ | 50GB | ESSD: 0.5元/GB | 25 |
| 合計 | 129 |
同じビジネス規模でストレージとサーバー構成を計算すると、Fluentd + ElasticSearch + Kibana の月間総費用は 2028(元)です。
Guance のコスト
Guance 自体は製品費用を請求せず、ストレージ使用量に応じてのみ課金します。DataKit 台数、ログデータ量、バックアップログデータ量、1日あたりのタスクスケジュール回数、DataKit 1台あたりの時系列数、リアルユーザーモニタリング(RUM)の1日あたりのセッション数、アプリケーションパフォーマンスモニタリング(APM)のトレース数に基づいて価格が計算されます。同様に、10台のサーバーからログを収集し、各サーバーで1日あたり1GB のログ量としてコストを計算します。
| 課金項目/プラン | 無料プラン | アジャイルプラン |
|---|---|---|
| DataKit 台数 | 台数無制限 | 5元/日 |
| 時系列 | 合計時系列数 < 500 | DataKit 1台あたりの時系列数 < 500 の場合、DataKit 費用 = DataKit 台数 × 基本単価 DataKit 1台あたりの時系列数 > 500 の場合、DataKit 台数は次の計算式で算出します: - DataKit 台数 = 現在のワークスペースの時系列総数 / 500(最終結果は切り上げ) - DataKit 費用 = DataKit 台数 × 基本単価 |
| ログデータ量 | 200万件 | 0.5元/日(100万件あたり) |
|
| バックアップログデータ量 | なし | 0.2元/日(100万件あたり) |
| トレース数 | 1万件 | 1元/日(100万件あたり) |
| セッション数 / PV 数 | 100セッション | 1元/日(100セッションまたは1,000 PVあたり)
注意:上記2つのうち、実際に発生する費用が低い方を最終費用とします。 |
| Synthetic テスト(API)タスク数 | 5件 | 1元/日(1,000回ごと)
注意:統計にはセルフホストノードで実行された API テストのデータは含まれません。 |
| Synthetic テスト(Browser)タスク数 | | 15元/日(1,000回ごと)
注意:統計にはセルフホストノードで実行された Synthetic テスト(Browser)のデータは含まれません。 |
| タスクスケジュール回数 | 5,000回 | 1元/日(10,000回ごと) |
| SMS 送信回数 | なし | 0.1元/日(1回あたり) |
10台のサーバーに DataKit をインストールし、各サーバーで1日あたり1GB のログを収集し、1件あたり4KB として計算します。
| 課金項目 | 値 | 単価 | 費用(元) |
|---|---|---|---|
| サーバー | DataKit 10個 | 月額費用: 150元/月 | 1500 |
| ストレージ | 1日1GB | 0.5元/日(100万件あたり) | 325 |
| 合計 | 1825 |
同じビジネス規模で計算すると、Guance の月間総費用は 1825(元)です。
運用コストの比較
運用コストについて言えば、クラスターの完全性を保証するためには、関連する運用保守が不可欠であることは誰もが知っています。それでは、各ソリューション間のコスト差を分析してみましょう。
ELK の運用コスト
Elastic の基本コンポーネントはすべてオープンソースであるため、運用管理のためにクラスターを自前で構築する必要があります。複雑なアーキテクチャの ELK は、LogStash クラスター + Kafka クラスター + ElasticSearch クラスター + Kibana ノードで構成される場合があります。まず、ユーザーのビジネスログ量が多く、計算ロジックが複雑な場合、LogStash クラスター、Kafka クラスター、ElasticSearch クラスターの規模と設定に対する要求は非常に高くなります。次に、規模の異なるクラスターでは、運用担当者のスキルに対する要求も非常に高くなります。大規模なクラスターではさまざまな問題が発生する可能性があり、リソース利用率を最大化するには、パフォーマンスチューニングの十分な経験も必要です。最後に、運用担当者にはテクノロジースタックの知識が不可欠です。
EFK の運用コスト
ELK と同様に、EFK もオープンソースコンポーネントに基づいており、ユーザーが自前でクラスターを構築して管理する必要があります。ELK より優れている点は、EFK がコレクターとして Fluentd を採用しているため、データ収集時に LogStash クラスターを省け、リソース使用量も少ないことです。ただし、ビジネスの規模に応じて ElasticSearch クラスターを動的に拡張する必要がある点は変わりません。大規模クラスターでは運用担当者へのスキル要求が高く、最適化が難しいという問題にも直面します。さらに、Fluentd の設定は Logstash より難しく、運用担当者の経験に頼らざるを得ません。スクリプトの最適化が不十分だと、ログ解析時にサーバー上の既存のビジネスに影響を与える可能性もあります。本番ビジネスの安定稼働を保証するためには、運用担当者への要求はさらに高くなるかもしれません。
Guance の運用コスト
Guance は SaaS 型のオブザーバビリティプラットフォームです。ユーザーはデータを収集したいサーバーに DataKit を1つデプロイし、ビジュアル管理機能を有効にするだけで、リモートで視覚的に収集側の設定管理を行うことができます。Guance プラットフォームは最適なログ解析テンプレートを提供し、サーバーへの負荷を最小限に抑えながらパフォーマンスを最大限に活用しつつ、簡単な設定でビジネスログを解析できるため、ユーザーはビジネスの最適化と拡張に集中でき、収集側やログ解析クラスターの最適化に労力を割く必要がありません。また、Guance はクラウド上で完全な可観測機能を提供しており、インフラストラクチャー、コンテナ、ミドルウェア、データベース、メッセージキュー、アプリケーショントレーシング、フロントエンドアクセス、システムセキュリティ、ネットワークアクセスパフォーマンスにわたるエンドツーエンドの観測が可能です。ビジネスニーズに基づいて独自の観測シナリオを実現でき、未成熟なオープンソース製品の研究や改修に労力を割く必要もありません。真の意味で運用コスト 0 でビジネス発展に集中できるという効果を実現します。
学習コストの比較
ログ分析システムの構築や利用には、学習コストが欠かせない要素です。うまく使うにはまずしっかり学ぶ必要があります。それでは、各ソリューションの習得難易度がどれくらいなのかを見てみましょう。
ELK の学習コスト
Elastic のコンポーネントはすべてオープンソースであるため、クラスターを自前で構築する必要があります。まず、ELK スタックを使用してログを分析・処理するには、ELK の環境構築とコンポーネント設定の学習が不可欠です。例えば、Elasticsearch の知識を身につけ、Elasticsearch の基礎を習得し、Elasticsearch のインデックス操作を習得し、Elasticsearch クラスターの計画を立てられるようになる必要があります。また、オープンソース版の LogStash や ElasticSearch に対してパフォーマンス設定の最適化なども行う必要があります。
EFK の学習コスト
ELK と同様に、EFK でもこれらの内容を学ぶ必要があります。さらに、Fluentd は Logstash よりも設定が柔軟な分、学習コストは高くなります。パフォーマンスの最適化も使用経験への依存度が高くなります。Logstash が 120 以上の grok テンプレートを提供しているのに対し、Fluentd ではユーザーがドキュメントを参照しながら学ぶ必要があり、実際に使いこなすにはより多くの学習が必要です。
Guance の学習コスト
Guance では、ユーザー環境にデプロイされるのはデータ収集用の DataKit のみです。ユーザーが必要とするデータ収集の設定については、公式が基本的にすべて設定リファレンスと使用ガイドを提供しています(現在 200 以上のテクノロジースタックをサポート)。ユーザーはログ分析、ビジネス観測、分散型トレーシングなどのために、Guance プラットフォームの対応するモジュールの使い方を少し学び、DataKit の収集項目を有効にするだけで、ビジネスのトレーシングなどのニーズを満たせます。オープンソースのクラスターを構築してログ分析などのニーズを実現するために、多くの技術を学ぶ必要がなくなります。ユーザーはオープンソースクラスターの運用を維持するために多くの時間を費やすのではなく、ビジネス上の問題の処理により多くの労力を注ぐことができます。
使用体験の比較
製品の使用体験の比較も重要です。同じ機能を実現するにあたり、ユーザーに与える印象にはどのような違いがあるのでしょうか。
ELK の使用体験
ELK を使用してログ分析を行うには、まず LogStash、Kafka、ElasticSearch クラスターと Kibana 表示ノードを構築する必要があります。次に、特定のコンポーネントのデータ収集と解析を実現するには、既存の 120 以上の解析テンプレートに自分が使えるものがあるかどうかを確認する必要があり、なければ、データ収集と解析を実現するまでに一連のテストが必要になるかもしれません。収集時のパフォーマンス消費が大きすぎる、または解析処理が遅すぎることが判明した場合、デバッグはまた面倒なプロセスになります。同時に、ログの増分が多すぎる場合は、ElasticSearch のクエリインデックスの最適化とクラスターの頻繁な拡張に直面します。最後に、あるビジネスを表示したい場合は、Kibana の KQL を学習してデータのクエリ表示を行う必要があります。データをリアルタイムで追跡・アラートするには、さらに他のオープンソースコンポーネントに依存する必要があるかもしれません。使用プロセスでは、要件の提示から解決までに 80% 以上の時間をオープンソースコンポーネントのさまざまな問題への対応に費やし、最終的に実際にビジネス分析・最適化に充てる時間はごく一部だけになります。
EFK の使用体験
EFK を使用したログ分析でも、ElasticSearch クラスターと Kibana 表示ノードの構築は避けられません。Fluentd は設定がより柔軟なため、ユーザーはデータの収集と解析をスムーズに完了するまでに、より多くの時間を設定とデバッグに費やす必要があるかもしれません。ElasticSearch クラスターを使用しても、ElasticSearch のインデックス最適化やクラスターの拡張を避けることはできません。最後に、Kibana を学習してデータのクエリ表示を行う必要もあります。同様に、要件の提示から解決までに 80% 以上の時間をオープンソースコンポーネントのさまざまな問題への対応に費やし、最終的に実際にビジネス分析・最適化に充てる時間はごく一部だけになります。
Guance の使用体験
Guance を使用してログ分析などのニーズを実現するのは非常に簡単です。まず、Guance のデータ収集側である DataKit のインストールと設定は非常に簡単で、1つのコマンドだけで完了できます。次に、ユーザーのコンポーネントログやデータ収集のニーズに対して、Guance は 200 以上の主要テクノロジースタックをサポートしており、インフラストラクチャー、コンテナ、ミドルウェア、データベース、メッセージキュー、アプリケーショントレーシング、フロントエンドアクセス、システムセキュリティ、ネットワークアクセスパフォーマンスなどを全方位的にサポートします。また、充実したドキュメント体系を備えており、ユーザーのすべての利用ニーズはドキュメントに基づいて解決できます。さらに、収集ツール DataKit にはビジュアルクライアントが提供されており、ユーザーの利用ハードルを下げています。同時に、Guance プラットフォームは多数の公式シナリオビューを提供し、ユーザーが自社ビジネスの健全性をより良く観測できるようにしています。
Guance は、インフラストラクチャー、コンテナ、ミドルウェア、データベース、メッセージキュー、アプリケーショントレーシング、フロントエンドアクセス、システムセキュリティ、ネットワークアクセスパフォーマンスにわたるエンドツーエンドのオブザーバビリティを構築しています。Guance の標準製品に基づき、ユーザーが DataKit の収集を正しく設定すれば、自社プロジェクトの完全なオブザーバビリティを迅速に構築できます。また、ラインプロトコル(Line Protocol)と Guance のシナリオ構築機能に基づき、ユーザーは観測したいメトリクスをカスタマイズして簡単に統合し、さらなるオブザーバビリティを実現できます。
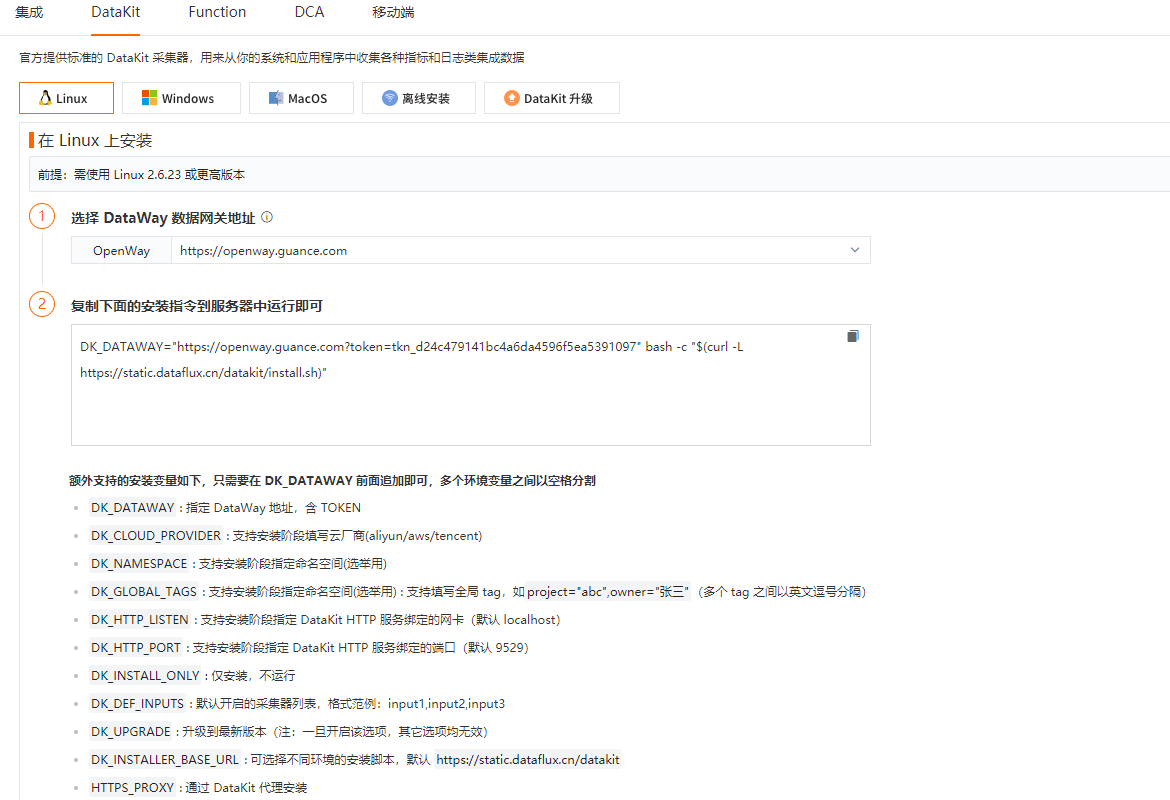
簡単な DataKit インストール
わずか1つのコマンドで DataKit のインストールを完了できます。
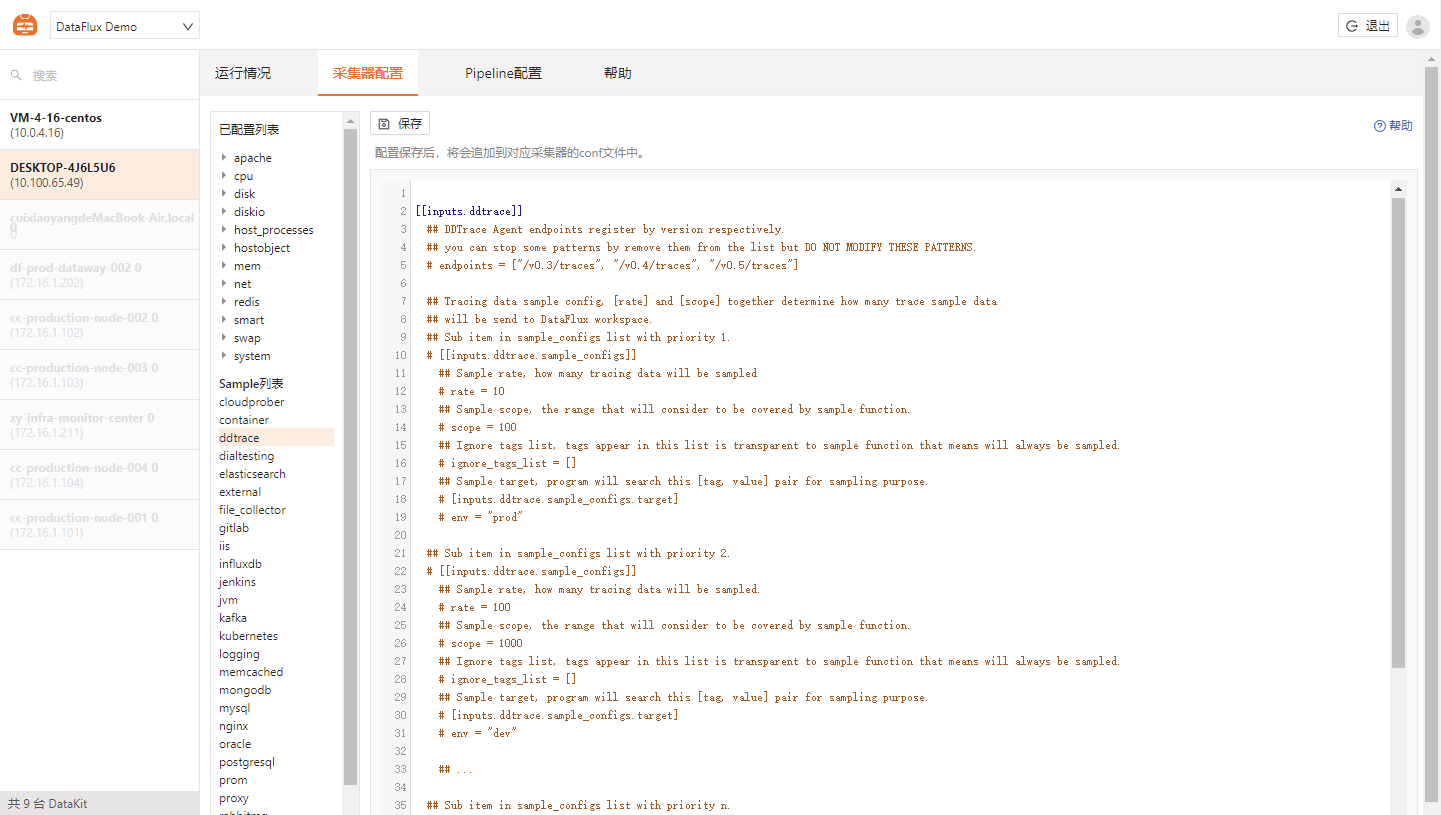
便利な収集項目管理
DataKit クライアントへのアクセスを有効にすると、DataKit クライアントで収集項目を変更できます。同時に多数のテンプレートが組み込まれており、ユーザーは収集したい内容に応じて対応する設定を有効にするだけでデータ収集を完了できます。
豊富な公式コンポーネントサポート
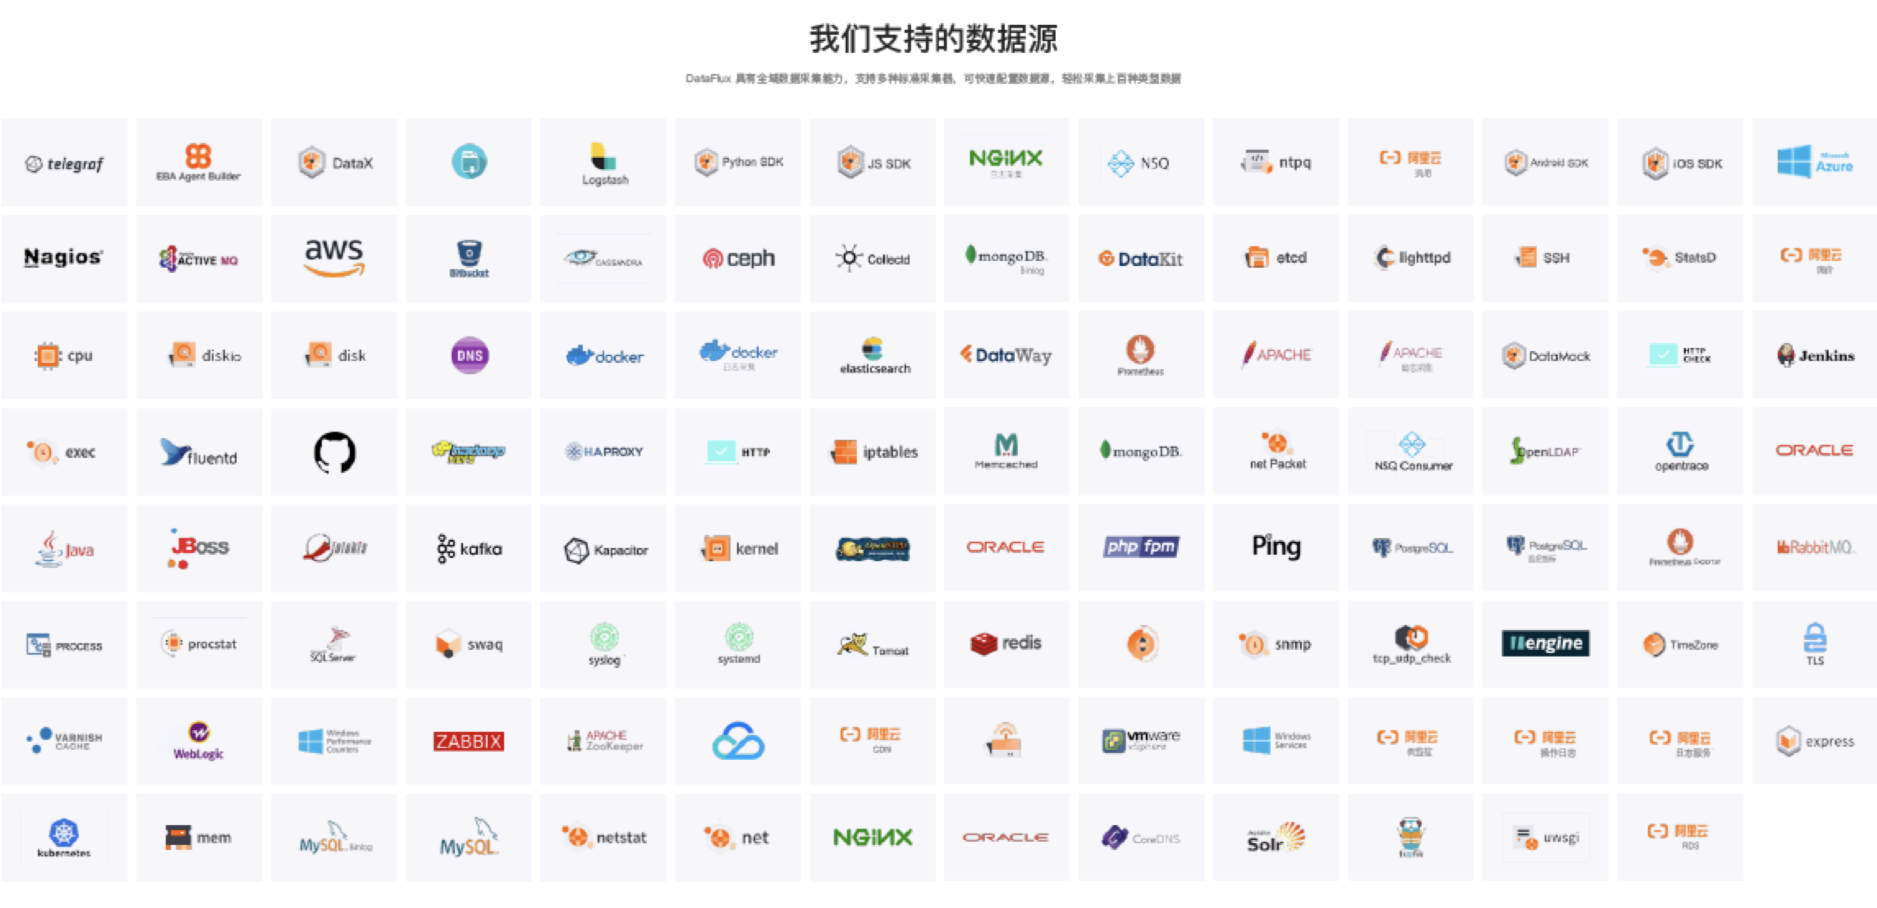
DataKit には、動的な grok 構文のクエリ・デバッグ、独自構文 DQL に基づく高速データクエリ、リアルタイムの inputs 収集実行の観測、エッジコンピューティング機能、ビジュアルなクライアント方式での設定・デプロイ・収集ソース管理など、強力な組み込み機能が含まれています。また、200 以上の公式メンテナンス済みデータソースの取り込みとテクノロジースタックのサポートに加え、Telegraf、Beats、Logstash、Fluentd などのさまざまな外部データ取り込みとも互換性があります。
さらに強力な製品機能
Guance は、インフラストラクチャー、コンテナ、ミドルウェア、データベース、メッセージキュー、アプリケーショントレーシング、フロントエンドアクセス、ログ、システムセキュリティ、ネットワークアクセスパフォーマンスにわたるエンドツーエンドのオブザーバビリティを構築しています。Guance の標準製品に基づき、ユーザーが DataKit の収集を正しく設定すれば、自社プロジェクトの完全なオブザーバビリティを迅速に構築できます。同時に、複数テクノロジースタックに対応した異常検知ライブラリなどの機能をサポートしており、ユーザーは複雑なビジネス上の問題に対してより多くの選択肢を持てます。