SLO 방법론에서 실무까지: Part2 SLO 도구 선택
서비스 수준 목표(SLO)는 사이트 신뢰성 엔지니어링 툴킷의 핵심 요소입니다. SLO는 애플리케이션 성능을 중심으로 명확한 목표를 정의하는 프레임워크를 제공하며, 궁극적으로 팀이 일관된 고객 경험을 제공하고 기능 개발과 플랫폼 안정성의 균형을 맞추며 내부 및 외부 사용자와의 커뮤니케이션을 개선하도록 돕습니다.
SLO와 SLI
우리가 제1부에서 살펴본 것처럼, SLO는 SLI에 대한 정확한 목표를 설정합니다. SLI는 서비스 상태와 성능을 반영하는 지표입니다. Guance에서 SLO를 관리하면 APM의 트레이스 메트릭, 커스텀 메트릭, 신서틱 데이터, 로그에서 생성된 메트릭 등 모니터링 데이터에 원활하게 접근하여 SLI로 사용할 수 있습니다. 예를 들어 일반적인 사용자 요청이 신속하게 처리되도록 하려면 APM의 서비스 중앙값 지연 시간을 SLI로 사용할 수 있습니다. 그런 다음 SLO를 "모든 달력 월에서 99%의 시간 동안 분 단위로 계산한 모든 사용자 요청의 중앙값 지연 시간이 250밀리초 미만이어야 한다"로 정의할 수 있습니다.
실제 성능이 설정한 목표와 어떻게 비교되는지 정확히 추적하려면 실시간 성능을 모니터링할 뿐만 아니라(예: 60초마다 중앙값 지연 시간을 계산하여 250밀리초 임계값과 비교) 더 긴 기간에 걸쳐 해당 임계값을 위반하는 빈도를 측정하는 방법이 필요합니다(매달 99% 목표를 달성했는지 확인하기 위해). Guance는 SLI를 추적하고 설정한 SLO와 관련된 상태를 시각화하므로, 주어진 기간에 실제 성능이 목표와 어떻게 비교되는지 즉시 확인할 수 있습니다.
도구 선택
SLI 지표의 경우 데이터는 주로 세 가지 주요 원천(Metrics, Logs, Traces)에서 비롯됩니다.
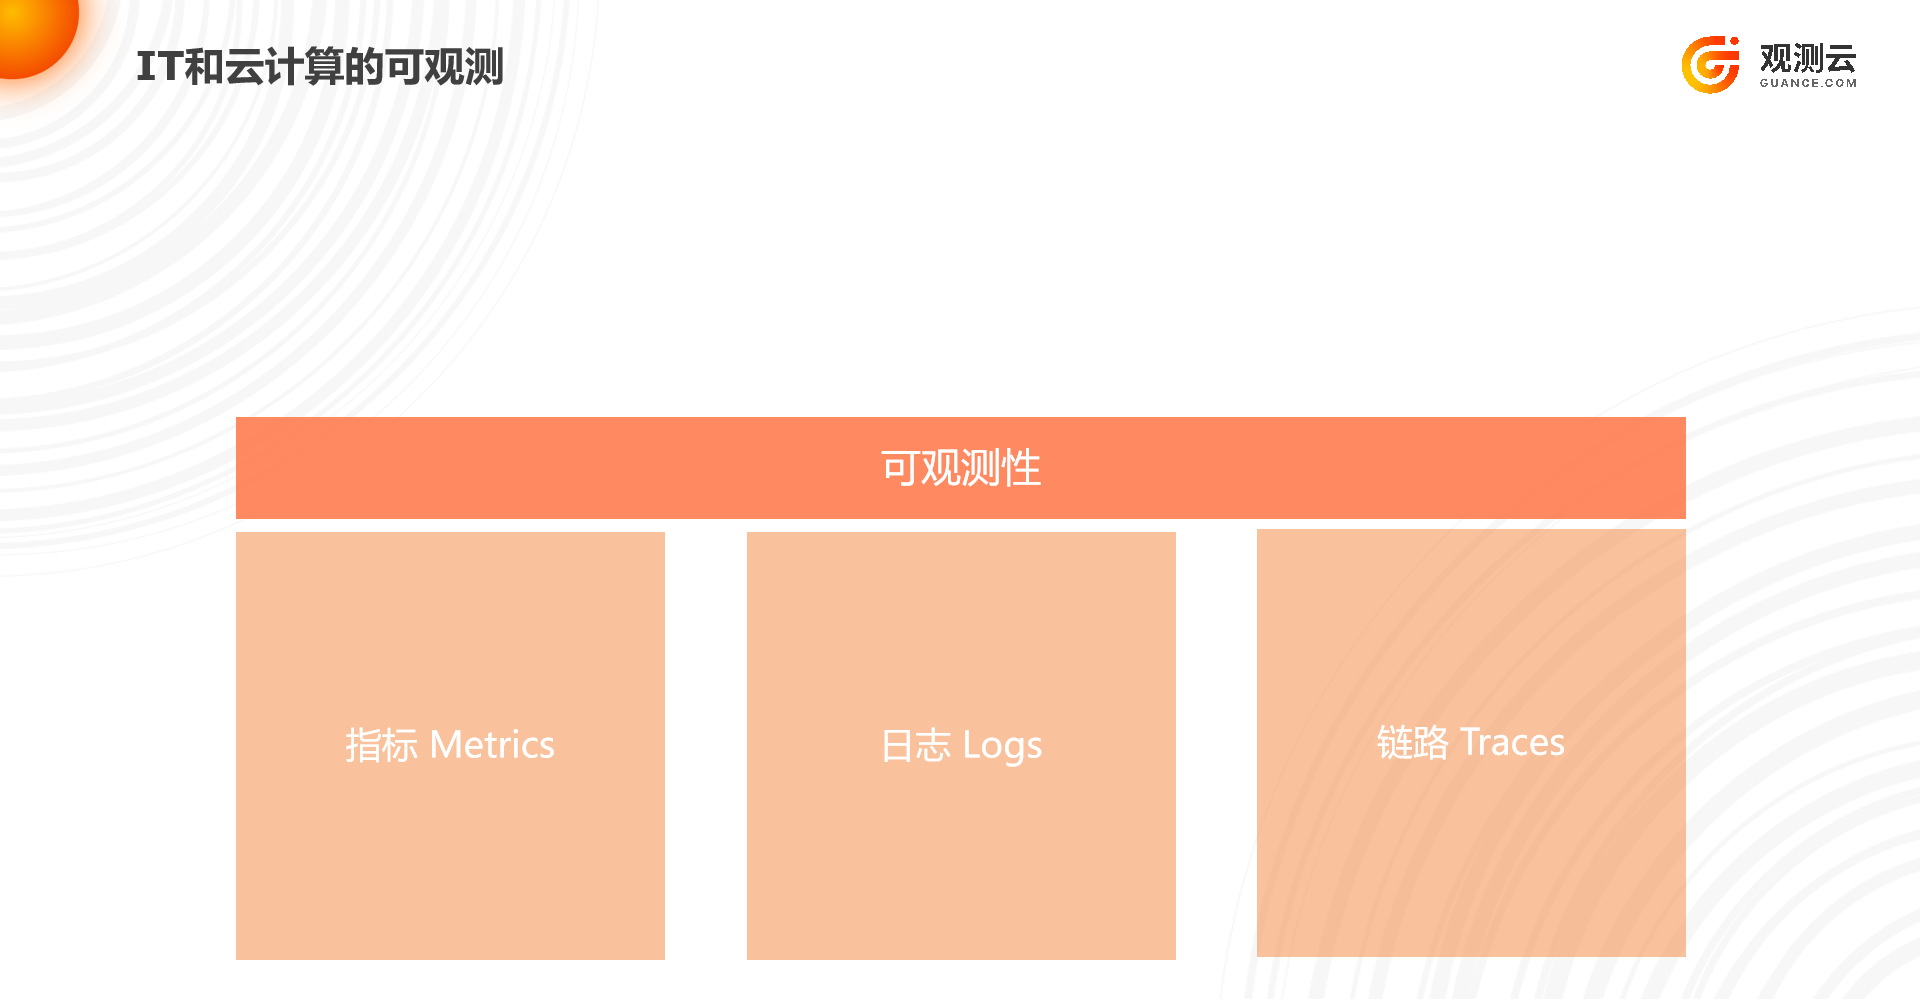
Metrics: 시스템 및 애플리케이션 지표를 수집합니다. 이러한 지표는 서비스에 큰 영향을 미칩니다. 예를 들어 CPU가 갑자기 100%로 급증하면 애플리케이션 처리 능력이 급격히 저하되어 사용자에게는 심각한 끊김 현상으로 나타납니다.
Traces: 트레이스는 방향성 비순환 그래프(DAG)를 기반으로 구축된 소프트웨어 모듈 간의 호출 관계, 즉 서비스 호출 체인입니다. 트레이스 정보를 통해 어떤 서비스 또는 어떤 쿼리가 고객에게 큰 영향을 미치는지(예: 데이터베이스 느린 쿼리) 신속하게 파악할 수 있습니다.
Logs: 로그는 시스템/애플리케이션이 출력하는 시간 관련 기록으로, 일반적으로 시스템/소프트웨어 개발자가 출력하여 시스템 오류와 상태를 쉽게 파악할 수 있게 합니다. 로그에서 연관성 있는 데이터를 Tag 또는 Field로 추출합니다. Tag는 집계와 그룹화에 적합하고, Field는 계산 및 집계에 적합합니다.
일반적인 도구
Metrics promethues, OpenTelemetry... Traces skyworking, OpenTelemetry, jaeger, Sleuth, Zipkin... Logs ELK, filebeat, flume...
무료 오픈소스 도구는 많지만 각 도구 체계마다 고유한 콘솔과 문법이 있습니다. 이러한 도구는 높은 학습 비용과 유지보수 비용이 들며, 시스템과 사용자 체계가 분산되어 있어 여러 플랫폼을 계속 오가야 합니다. SLI에는 바로 이러한 각 시스템 구성 요소를 한곳에 모아주는 플랫폼 통합이 필요하며, 하나의 플랫폼으로 여러 도구를 연결하고 문법을 통일하면 학습 비용을 효과적으로 줄일 수 있습니다. Guance가 가장 좋은 선택입니다. Guance는 원스톱 솔루션을 제공하며 현재 200개 이상의 오픈소스 도구 구성 요소를 통합하고 있습니다. 물론 팀을 구성해 이러한 플랫폼을 직접 구축할 수도 있지만, 권장하지 않습니다.
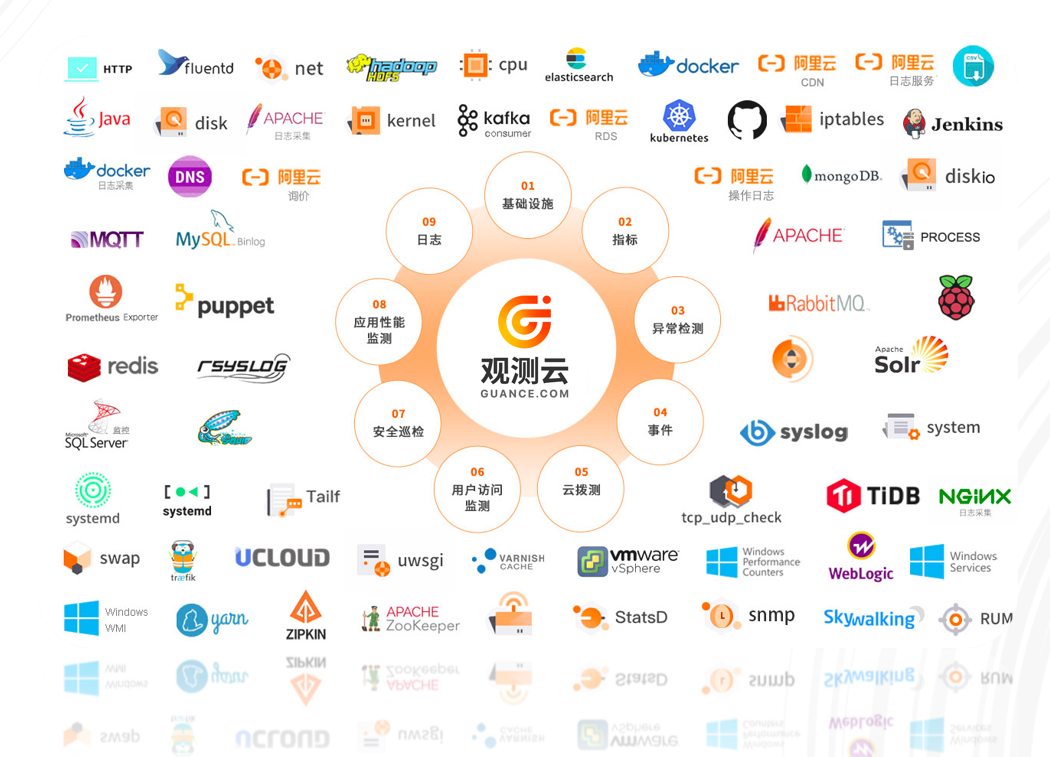
모든 SLO를 한곳에서 관리
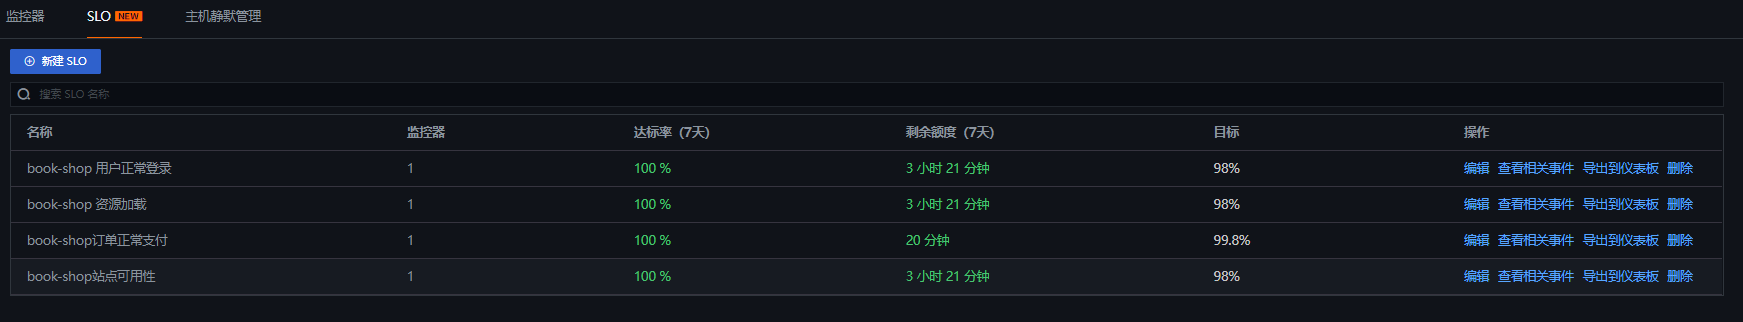
조직이 여러 제품과 팀에 걸쳐 다양한 SLO를 운영한다면, 한곳에서 모든 SLO의 상태를 시각화하면 우선순위를 정하고 문제를 해결하는 데 도움이 됩니다. Guance의 서비스 수준 목표 뷰에서는 모든 SLO의 상태와 각 SLO의 남은 오류 예산을 확인할 수 있습니다.
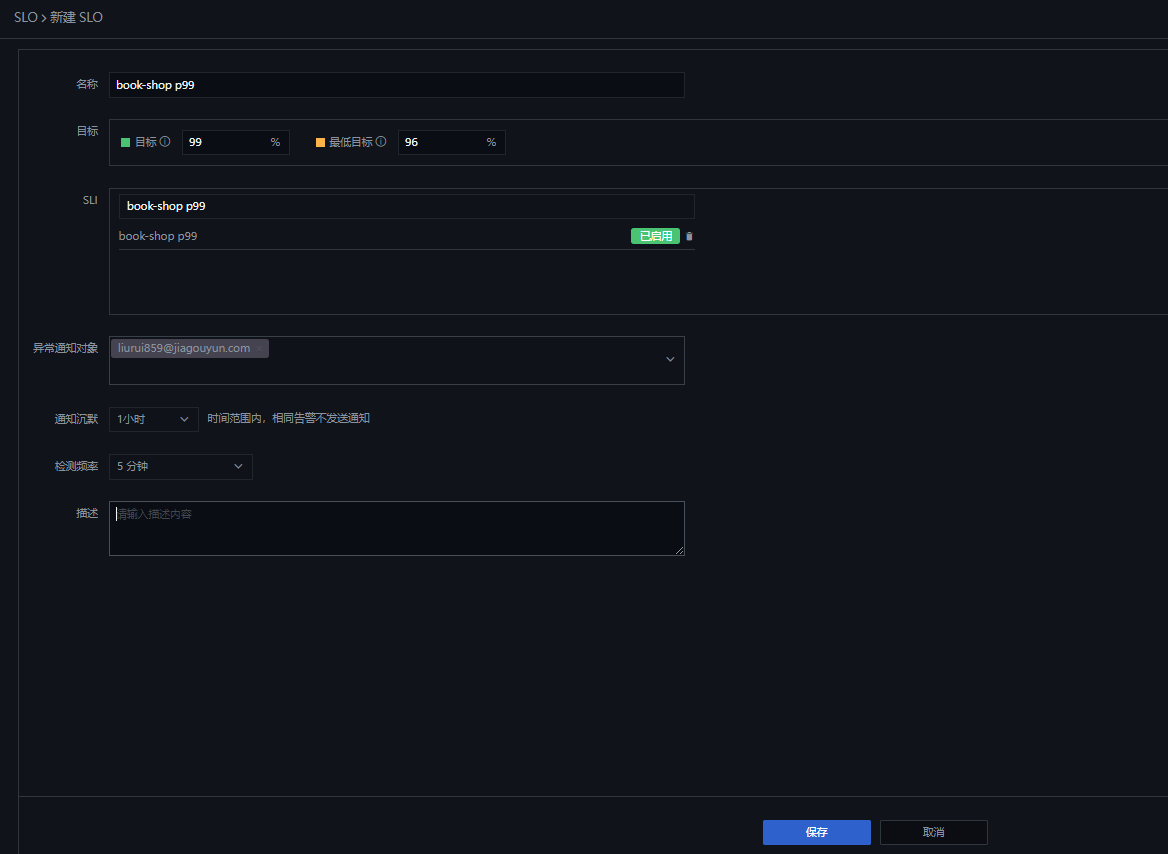
메트릭 및 모니터 기반 SLO 생성
SLO 목록 보기에서 [새 SLO] 버튼을 클릭하여 생성할 수 있습니다. Guance의 SLO는 기존 모니터(예: p90 지연 시간을 목표 임계값과 비교하는 모니터) 또는 메트릭에서 계산된 실시간 상태를 기반으로 할 수 있습니다. 메트릭 기반 SLO는 특정 정의를 충족하는 메트릭의 비율을 모니터링하는 데 사용할 수 있습니다. 예를 들어 로드 밸런서의 5xx가 아닌 응답 수를 전체 응답 수로 나눈 값이 있습니다.
SLO와 오류 예산을 한눈에 확인
SLO를 클릭하거나 이벤트를 열면 상태, 목표 값, 남은 오류 예산 등 SLO의 세부 정보가 표시되는 사이드 패널이 열립니다. Guance는 각 SLO에 대해 오류 예산을 자동으로 생성하며, 이는 SLO를 위반하기 전에 감당할 수 있는 불안정성의 정도를 나타냅니다. 이를 통해 목표를 달성하고 있는지, 그리고 개발 속도가 설정된 성능 및 안정성 목표에 적합한지 빠르게 파악할 수 있습니다. Guance는 지정한 SLO 목표와 시간 창을 기준으로 오류 예산을 자동 계산합니다. 예를 들어 7일 동안 99%의 SLO 목표를 설정하면 해당 기간 동안 성능이 기준에 미치지 못하더라도 약 3시간 30분의 오류 예산이 제공됩니다.
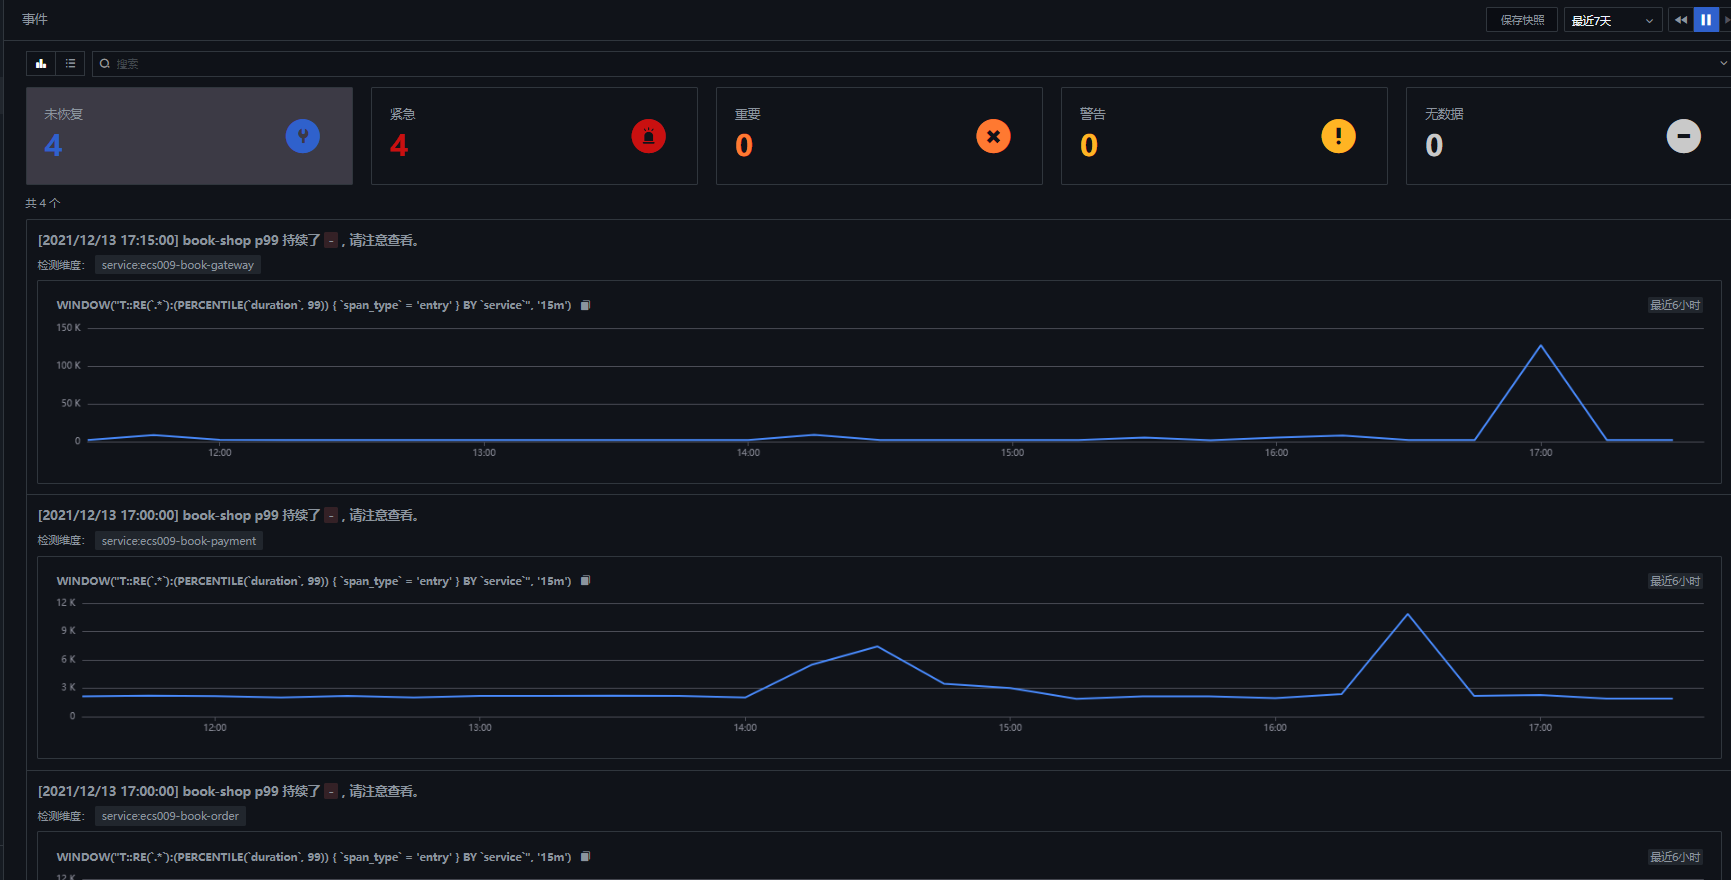
SLO 상태 시각화
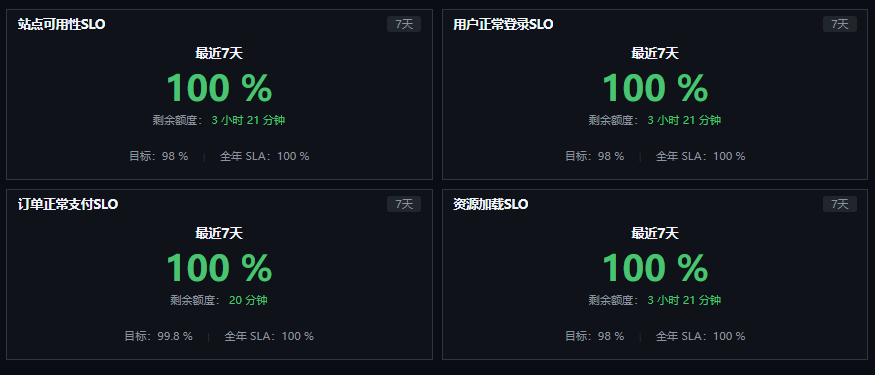 SLO 상태를 관련 서비스 또는 인프라 구성 요소에 대한 세부 데이터와 함께 맥락에서 추적하려면 SLO 위젯을 Guance 대시보드에 추가할 수 있습니다. 그런 다음 대시보드를 내부 또는 외부에 공유하여 서비스에 의존하는 모든 사람에게 SLO의 실시간 상태를 전달할 수 있습니다.
또한 지난주, 지난달, 이번 주 누계, 이번 달 누계 등 일반적인 SLO 기준을 통해 해당 임계값을 위반한 빈도를 시각화할 수 있습니다. 지난 30일 목표를 99%로, 경고 목표를 99.5%로 설정한 경우 SLO 상태는 99.5%를 초과하면 녹색, 99.5% 미만이면 노란색, 99% 미만으로 내려가면 빨간색으로 표시됩니다.
서비스 상태 표시 및 공유
Guance를 사용하면 애플리케이션, 인프라, 사용자 경험 등을 이미 모니터링하고 있는 동일한 공간에서 SLO를 간편하게 모니터링하고 관리할 수 있습니다. 또한 중요하게도, Guance를 사용하면 이러한 SLO 충족에 의존하는 모든 이해관계자나 사용자에게 투명성을 제공할 수 있습니다.아직 Guance로 서비스 상태와 성능을 모니터링하지 않는다면 무료 평가판 계정으로 시작할 수 있습니다.
이 시리즈의 다음이자 마지막 부분을 계속 읽어보세요. Guance에서 SLO를 최대한 활용하는 모범 사례를 공유합니다.