SLO の方法論から実践へ:Part2 SLO ツール選定
サービスレベル目標(SLO)は、サイトリライアビリティエンジニアリング(SRE)ツールキットの重要な構成要素です。SLO は、アプリケーションパフォーマンスに関する明確な目標を定義するための枠組みを提供し、最終的にはチームが一貫した顧客体験を提供し、機能開発とプラットフォームの安定性のバランスをとり、社内外のユーザーとのコミュニケーションを改善するのに役立ちます。
SLO と SLI
第 1 部で説明したように、SLO は SLI に正確な目標を設定します。SLI は、サービスの健全性とパフォーマンスを反映するメトリクスです。Guance で SLO を管理することで、APM のトレースメトリクス、カスタムメトリクス、Synthetic データ、ログから生成されたメトリクスなど、SLI として使用できるモニタリングデータにシームレスにアクセスできます。たとえば、一般的なユーザーリクエストが迅速に処理されるようにするには、APM のサービスの遅延時間の中央値を SLI として使用できます。その後、SLO を「任意の暦月において、全ユーザーリクエストの遅延時間の中央値(毎分計算)が 250 ミリ秒未満であること」と定義できます。 設定した目標に対する実際のパフォーマンスを正確に追跡するには、リアルタイムのパフォーマンス(たとえば、60 秒ごとに遅延時間の中央値を計算し、250 ミリ秒のしきい値と比較する)を監視するだけでなく、より長い期間にわたってそのしきい値を超えた頻度も測定する方法(毎暦月の 99% の目標を達成するため)が必要です。Guance は、SLI を追跡し、設定した SLO に関連するそれらのステータスを可視化するため、指定した期間における実際のパフォーマンスと目標の比較をすぐに確認できます。
ツール選定
SLI メトリクスのデータソースは、主に Metrics、Logs、Traces の 3 つです。
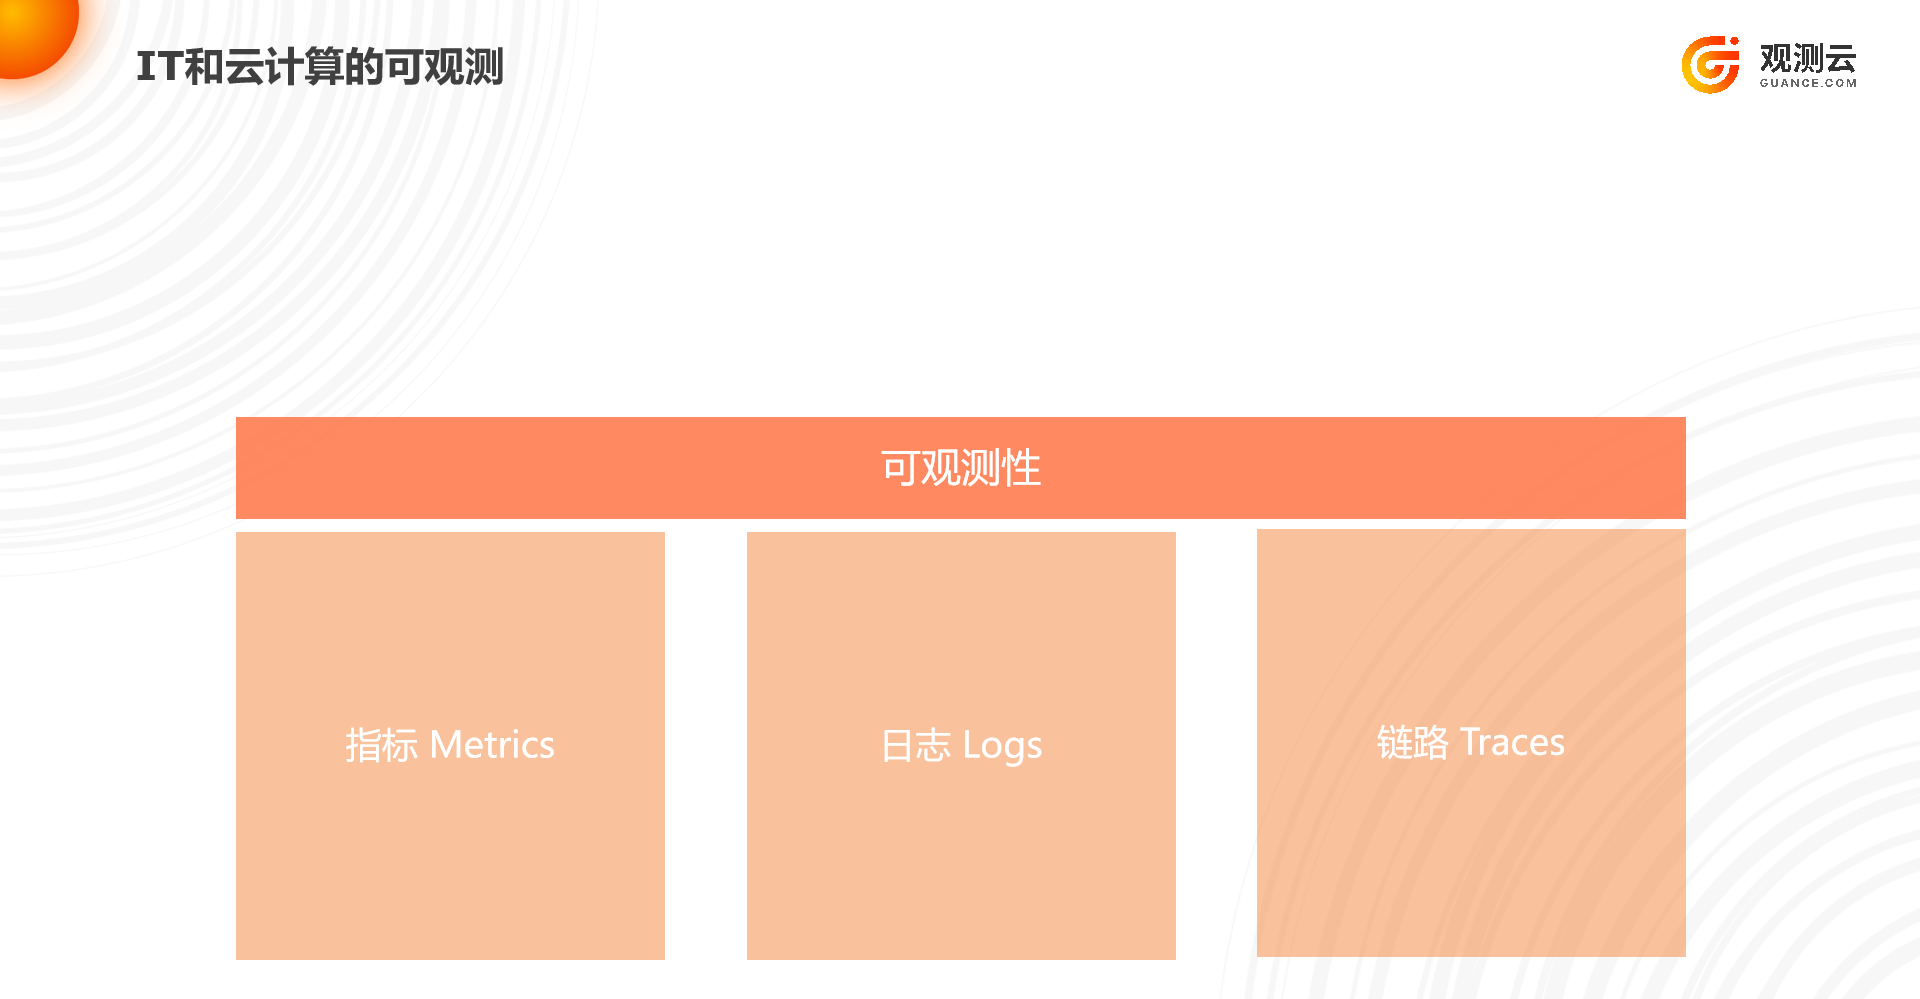 Metrics:メトリクス。主にシステムおよびアプリケーションのメトリクスを収集します。これらのメトリクスはサービスに大きな影響を与えます。たとえば、CPU が突然 100% に急増すると、アプリケーションの処理能力が著しく低下し、ユーザー側では深刻なカクつきとして現れます。
Traces:トレース。有向非巡回グラフに基づいて構築された、ソフトウェアの各モジュール間の直接的な呼び出し関係、およびサービス呼び出しのトレース状況を示します。トレース情報を利用することで、どのサービスやどのステートメントが顧客に大きな影響を与えているか(データベースのスロークエリなど)をすばやく特定できます。
Logs:ログ。システムまたはアプリケーションが出力する時間に関連する記録で、通常はシステムまたはソフトウェア開発者が出力し、システムのエラーや状態を特定するために使用します。ログ内の関連性のあるデータをタグまたはフィールドとして抽出します。タグは集計やグループ化に便利で、フィールドは計算や集計に便利です。
一般的なツール
Metrics Prometheus、OpenTelemetry... Traces SkyWalking、OpenTelemetry、Jaeger、Sleuth、Zipkin... Logs ELK、filebeat、flume...
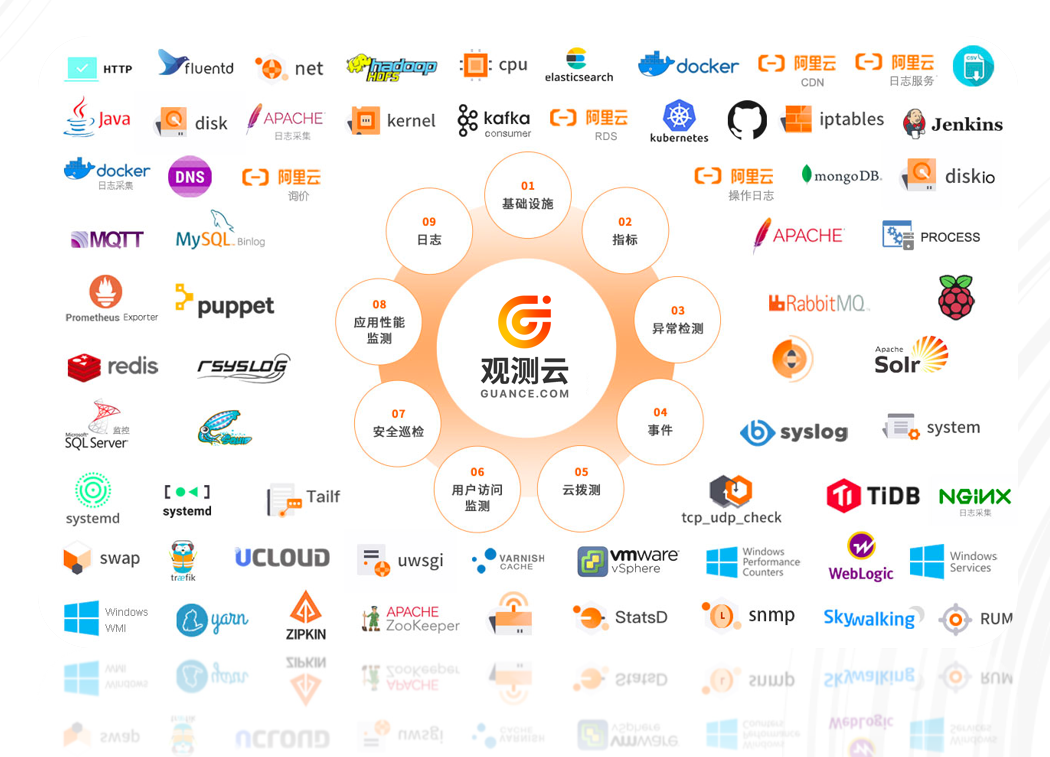
無料のオープンソースツールは多数ありますが、それぞれの体系に専用のコンソールと構文があります。これらのツールは、学習コストと運用コストが高く、システムとユーザー体系が分散しているため、複数のプラットフォームを行き来しなければなりません。まさに SLI には、各システムコンポーネントを集中管理できるプラットフォームが必要です。1 つのプラットフォームで複数のツールを統合し、構文を統一できれば、学習コストを効果的に削減できます。Guance は最適な選択肢であり、ワンストップソリューションを提供し、現在 200 以上のオープンソースツールコンポーネントを統合しています。もちろん、チームを編成してこのようなプラットフォームを構築することもできますが、お勧めはしません。
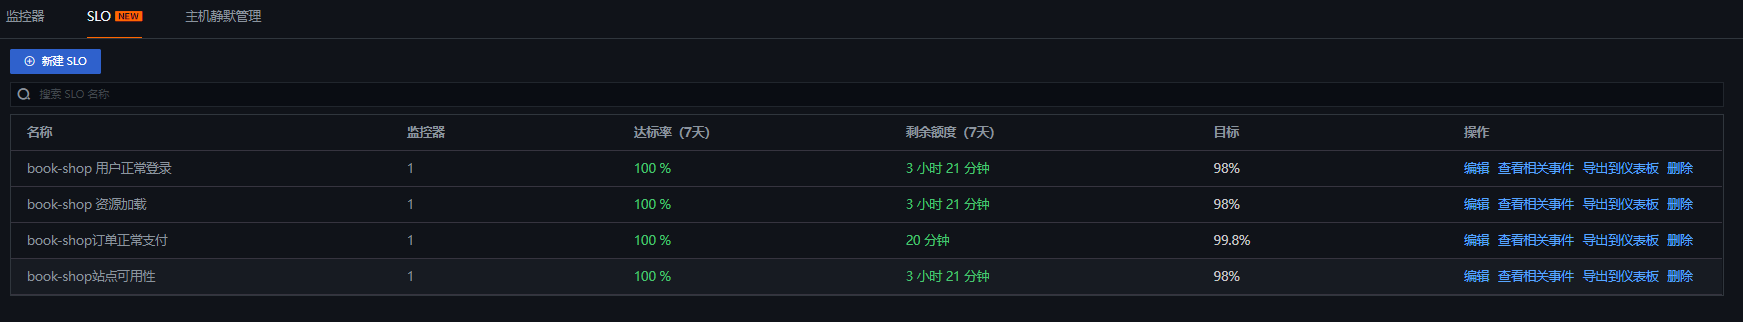
すべての SLO を 1 か所で管理
組織が複数の製品やチームにわたってさまざまな SLO を運用している場合、すべての SLO のステータスを 1 か所で可視化することで、優先順位の設定や問題の解決に役立ちます。Guance のサービスレベル目標ビューでは、すべての SLO のステータスと、各 SLO の残りのエラーバジェットを確認できます。
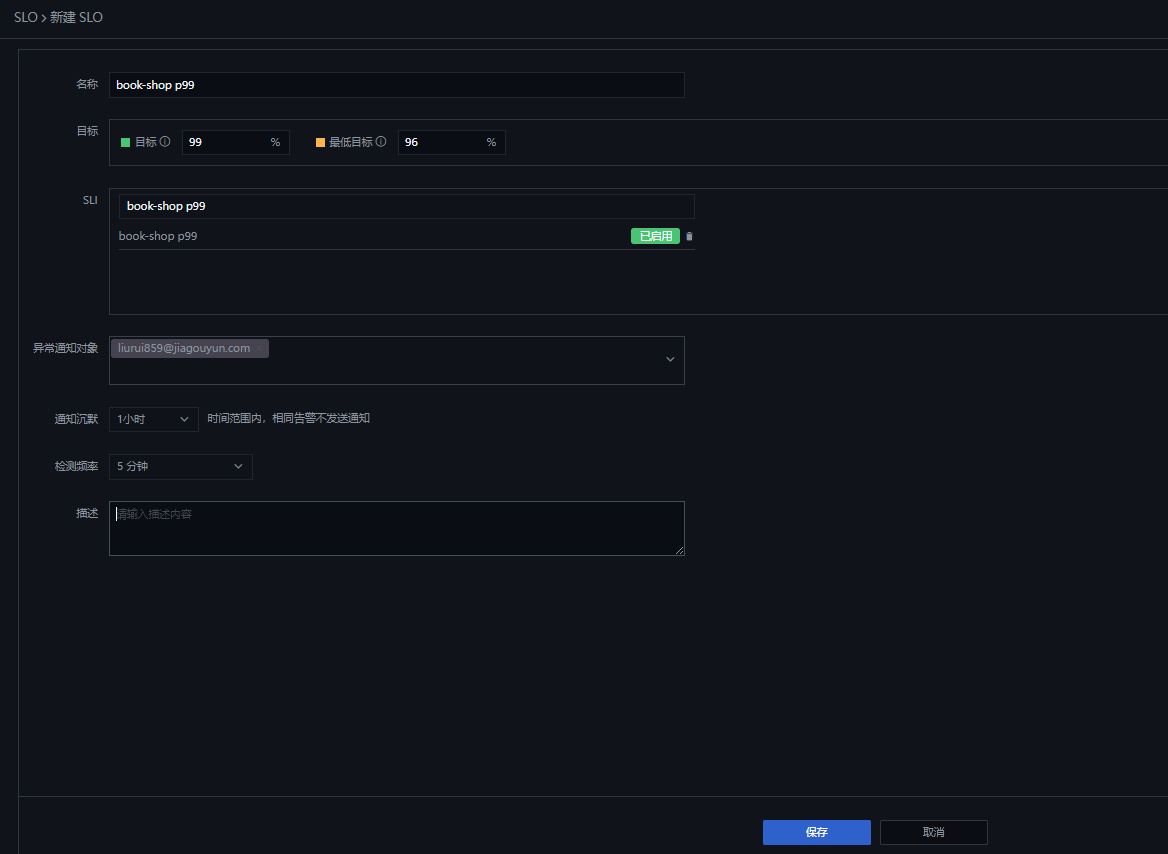
メトリクスとモニターから SLO を作成
SLO リストビューで、SLO を作成ボタンをクリックして作成できます。Guance の SLO は、既存のモニター(たとえば、p90 遅延を目標しきい値と比較するモニター)に基づくことも、メトリクスから計算されたリアルタイムステータスに基づくこともできます。メトリクスベースの SLO は、特定の定義を満たすメトリクスの割合(たとえば、ロードバランサーからの非 5xx 応答数を応答総数で割った値)を監視するために使用できます。
SLO とエラーバジェットをひと目で確認
SLO をクリックするか、イベントを開くと、ステータス、目標値、残りのエラーバジェットなど、SLO の詳細が表示されるサイドパネルが開きます。Guance は各 SLO に対してエラーバジェットを自動的に生成します。これは、SLO を違反する前に許容できる非信頼性の程度を示します。これにより、目標を達成しているかどうか、および開発速度が設定したパフォーマンスと安定性の目標に適合しているかをすばやく把握できます。Guance は、指定した SLO 目標と時間枠に基づいてエラーバジェットを自動的に計算します。たとえば、7 日間の 99% の SLO 目標では、その期間のパフォーマンスが基準を下回る場合、約 3 時間半のエラーバジェットが提供されます。
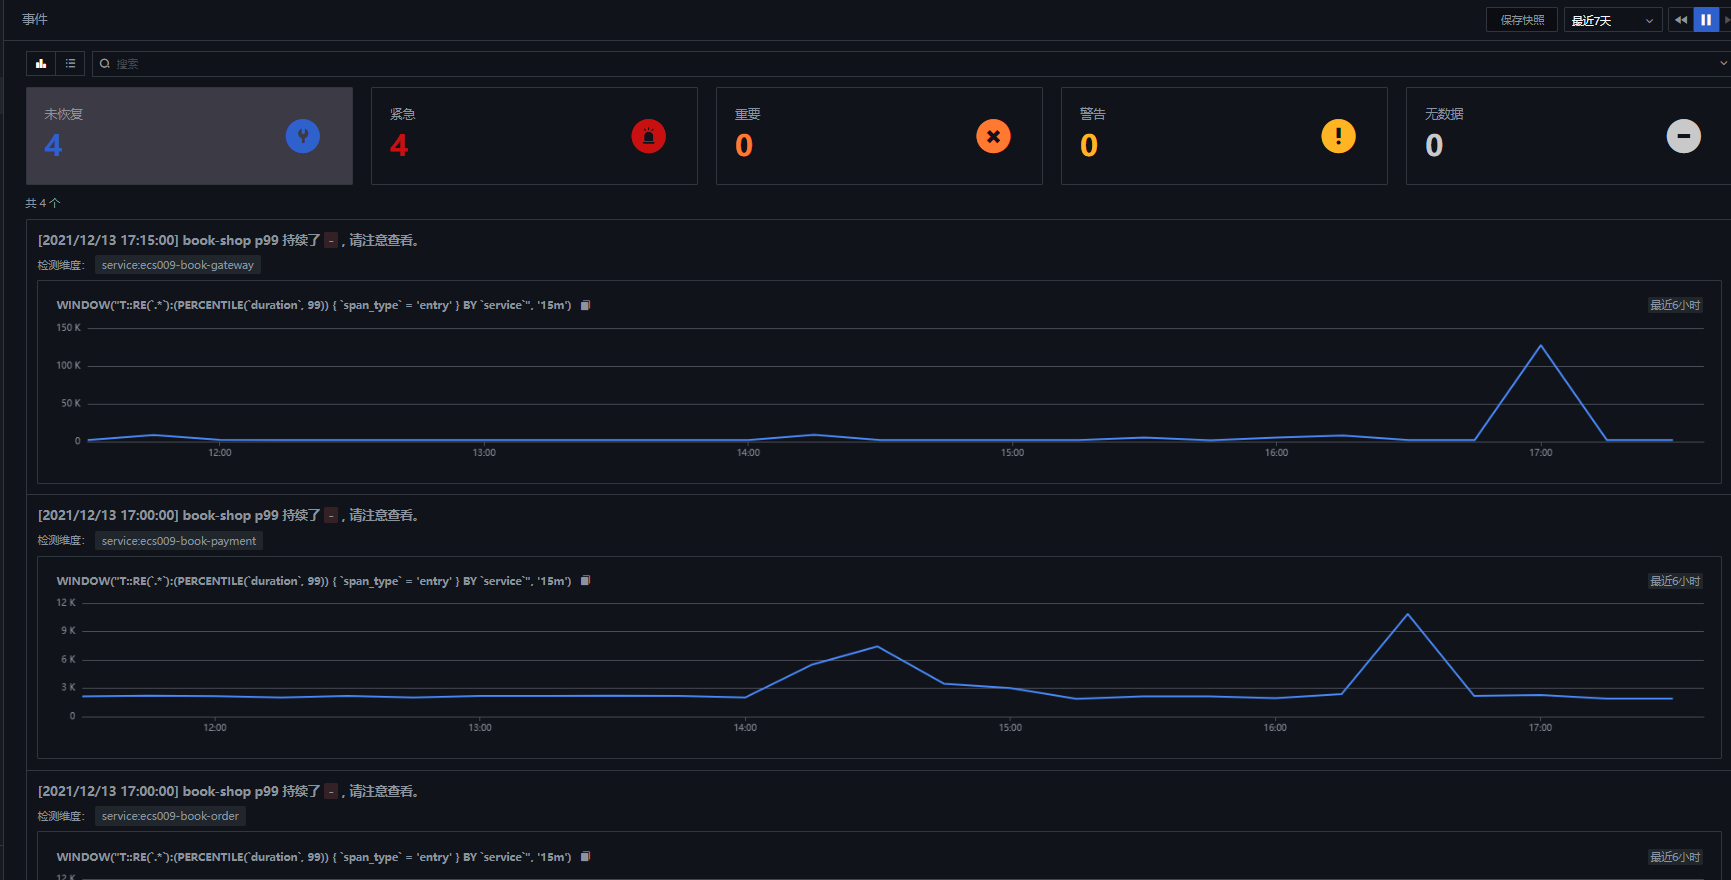
SLO ステータスの可視化
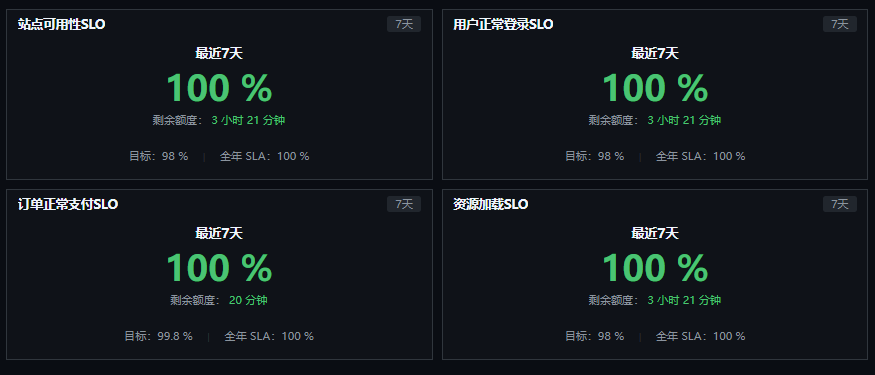 SLO のステータスと、関連するサービスやインフラストラクチャコンポーネントの詳細データをコンテキスト内で追跡するには、SLO ウィジェットを Guance のダッシュボードに追加できます。その後、ダッシュボードを社内外で共有し、SLO のリアルタイムステータスをサービスに依存するすべての関係者に伝えることができます。
また、先週、先月、今週至今、今月至今などの一般的な SLO 基準で、しきい値を超えた頻度を可視化することもできます。過去 30 日間の目標を 99% に設定し、警告目標を 99.5% に設定した場合、SLO ステータスは 99.5% を超えると緑、99.5% を下回ると黄色、99% を下回ると赤で表示されます。
サービスステータスの表示と共有
Guance を使用すると、アプリケーション、インフラストラクチャ、ユーザーエクスペリエンスなどをすでに監視している同じ場所で SLO を監視および管理できます。同様に重要なこととして、Guance を使用すると、これらの SLO の達成に依存するすべてのステークホルダーやユーザーに透明性を提供できます。まだ Guance を使用してサービスの健全性とパフォーマンスを監視していない場合は、無料トライアルアカウントから始めることができます。
このシリーズの次回および最終回に進み、Guance で SLO を最大限に活用するためのベストプラクティスを紹介します。