検索
エクスプローラーの検索バーは、トークン検索、フレーズ検索、フィールド絞り込み、JSON 検索、関数クエリをサポートします。DQL モードに切り替えて、完全なクエリ文を作成することもできます。
検索方法を選択
| クエリの目的 | 使用方法 | 例 |
|---|---|---|
| テキスト内容を検索 | テキスト検索 | connection timeout |
| 連続するフレーズを検索 | フレーズ検索 | #"connection timeout" |
| フィールドと値で絞り込む | フィールド絞り込み | service:api |
| JSON の埋め込みフィールドを検索 | JSON 検索 | @meta.service:api |
| MD5 でマスクされたデータを検索 | MD5 関数クエリ | color:md5(red) |
| IP ネットワークセグメントを検索 | CIDR 関数クエリ | CIDR(@client_ip, 10.0.0.0/8) |
| 複雑なクエリまたは計算を実行 | DQL クエリ | L::logs:(*) {...} |
| 自然言語でクエリの目的を記述 | AI 支援クエリ | 「サービス別に直近 30 分間のエラーログ数を集計する」 |
検索と絞り込み
直接テキストを入力すると、システムはトークン検索を実行します。引用符の前に # を追加すると、フレーズ検索を実行します。字段名:字段值 を使用すると、フィールド絞り込みを実行します。たとえば、error timeout はトークン検索、#"error timeout" は連続フレーズ検索、service:api は service フィールドの絞り込みに使用します。
AI 支援クエリ
AI 支援クエリの入口が提供されているエクスプローラーでは、自然言語で絞り込み条件または DQL ドラフトを生成できます。ログ、トレース、RUM、基本オブジェクト、リソースカタログ、イベントなどのシナリオに適用されます。使用前にワークスペースの AI 機能を有効にする必要があります。共有ページ、SLS クエリモード、バックアップログエクスプローラーでは、この入口は提供されません。
- クエリ条件を生成:説明を現在のエクスプローラーの絞り込み条件に変換し、ページのクエリに使用します。
- DQL を生成:現在のデータ型、インデックス、すでに限定されたソースを維持し、ページの時間範囲と組み合わせて、編集・コピー可能なクエリドラフトを生成します。自動実行は行われません。DQL 実行をサポートするページでは確認後に実行します。ドラフトのみをサポートするページでは、クエリワークベンチにコピーして使用できます。
生成されたドラフトは、ワークスペースのフィールドを項目ごとに確認したり、クエリ結果を検証したりするものではありません。実行前にフィールドと集計基準を確認してください。詳細はAI による DQL 生成支援を参照してください。
組み合わせ検索
ログエクスプローラーでは、検索バーのドロップダウンリストに AND、OR などの一般的な組み合わせ演算子が表示されます。
AND:前後の両方の条件を満たします。OR:前後のいずれか一方の条件を満たします。- 組み合わせ演算子は大文字で指定する必要があります。
- 小文字の
and、orは通常のテキストとして検索対象になります。
たとえば:
service:api AND status:error
source:nginx OR source:apache
(service:api OR service:web) AND status:error
テキスト検索
エクスプローラーのテキスト検索では、search() クエリ構文を使用します。システムは入力内容をトークン化し、すべてのトークンを含むデータを検索します。
- 中国語は文字単位でトークン化されます。
- 英語は空白、句読点などの単語境界でトークン化されます。
- 英語の検索では大文字と小文字を区別しません。
- 各トークンは連続して出現する必要はありません。
トークン検索
テキストを入力すると、システムが自動的にトークン化します。データ内にすべてのトークンが含まれていれば、トークン間に他の内容が存在しても検索できます。
中国語の例:
上記の結果はいずれも、検索内容の有効なトークンをすべて含んでいます。これらのトークンは連続して出現する必要はありません。
英語の例:
入力:connection timeout

一致する可能性:
- connection timeout
- Connection retry timeout
- connection request failed due to timeout
上記の結果はいずれも「connection」と「timeout」を同時に含んでいます。トークンは連続して出現する必要はなく、大文字と小文字も区別されません。
フレーズ検索
完全で連続したフレーズで検索する場合は、引用符の前に # を追加します。英語の半角二重引用符の使用を推奨します:
#"我喜欢苹果":我喜欢苹果,也喜欢香蕉に一致し、我很喜欢吃苹果には一致しません。#"connection timeout":connection timeout occurredに一致し、connection retry timeoutには一致しません。
エクスプローラーでは次のフレーズ表記をサポートします:
| 表記 | 説明 | 変換後の DQL 条件 |
|---|---|---|
#"connection timeout" |
推奨表記 | search('#"connection timeout"') |
#'connection timeout' |
単一引用符の互換表記 | search('#"connection timeout"') |
#“connection timeout” |
中国語引用符の互換表記 | search('#"connection timeout"') |
# はフレーズ検索演算子であり、検索内容には含まれません。# を付けずに引用符のみを使用しても、フレーズ検索は有効になりません。引用符は対で指定する必要があり、フレーズを空にすることはできません。閉じられていない #"connection timeout、#'connection timeout および空のフレーズ #""、#'' は有効なクエリとして実行されません。
フレーズ検索はフィールド絞り込みや組み合わせ演算子と併用できます:
このうち、-#"health check" は該当する連続フレーズを含むデータを除外することを表し、DQL 条件 not search('#"health check"') に対応します。標準モードから DQL モードに切り替えると、互換表記は #"..." の DQL フレーズ形式に統一変換されます。標準モードに戻しても、バックスラッシュのエスケープ文字が累積されることはありません。
ストップワード
頻繁に出現し、検索上の重要度が低い一部の語は全文インデックスに含まれません。検索結果が想定と異なる場合は、全文インデックスのストップワード一覧を参照してください。
JSON 検索
前提条件
- ワークスペースが
2022年6月23日以降に作成されていること。 - ログエクスプローラーで使用すること。
JSON 検索は、ログフィールド内の JSON 埋め込みフィールドをクエリするために使用します。クエリ対象のログフィールドには、有効な JSON コンテンツが含まれている必要があります。
クエリ形式は 日志字段名@JSON字段路径:字段值 です。message フィールドをクエリする場合は message を省略し、@JSON字段路径:字段值 と簡略化できます。他のログフィールドをクエリする場合は、ログフィールド名を明示的に指定する必要があります。
ネストされたフィールドをクエリする場合は、. で各階層のフィールド名を連結します。
@meta.service:api を例に説明します:
| 構成要素 | 意味 |
|---|---|
@ |
JSON フィールドのプレフィックス。エクスプローラーはこれを演算子として認識します。 |
meta.service |
message 内のネストされたフィールドパス |
: |
フィールドと値の区切り文字 |
api |
一致対象のフィールド値 |
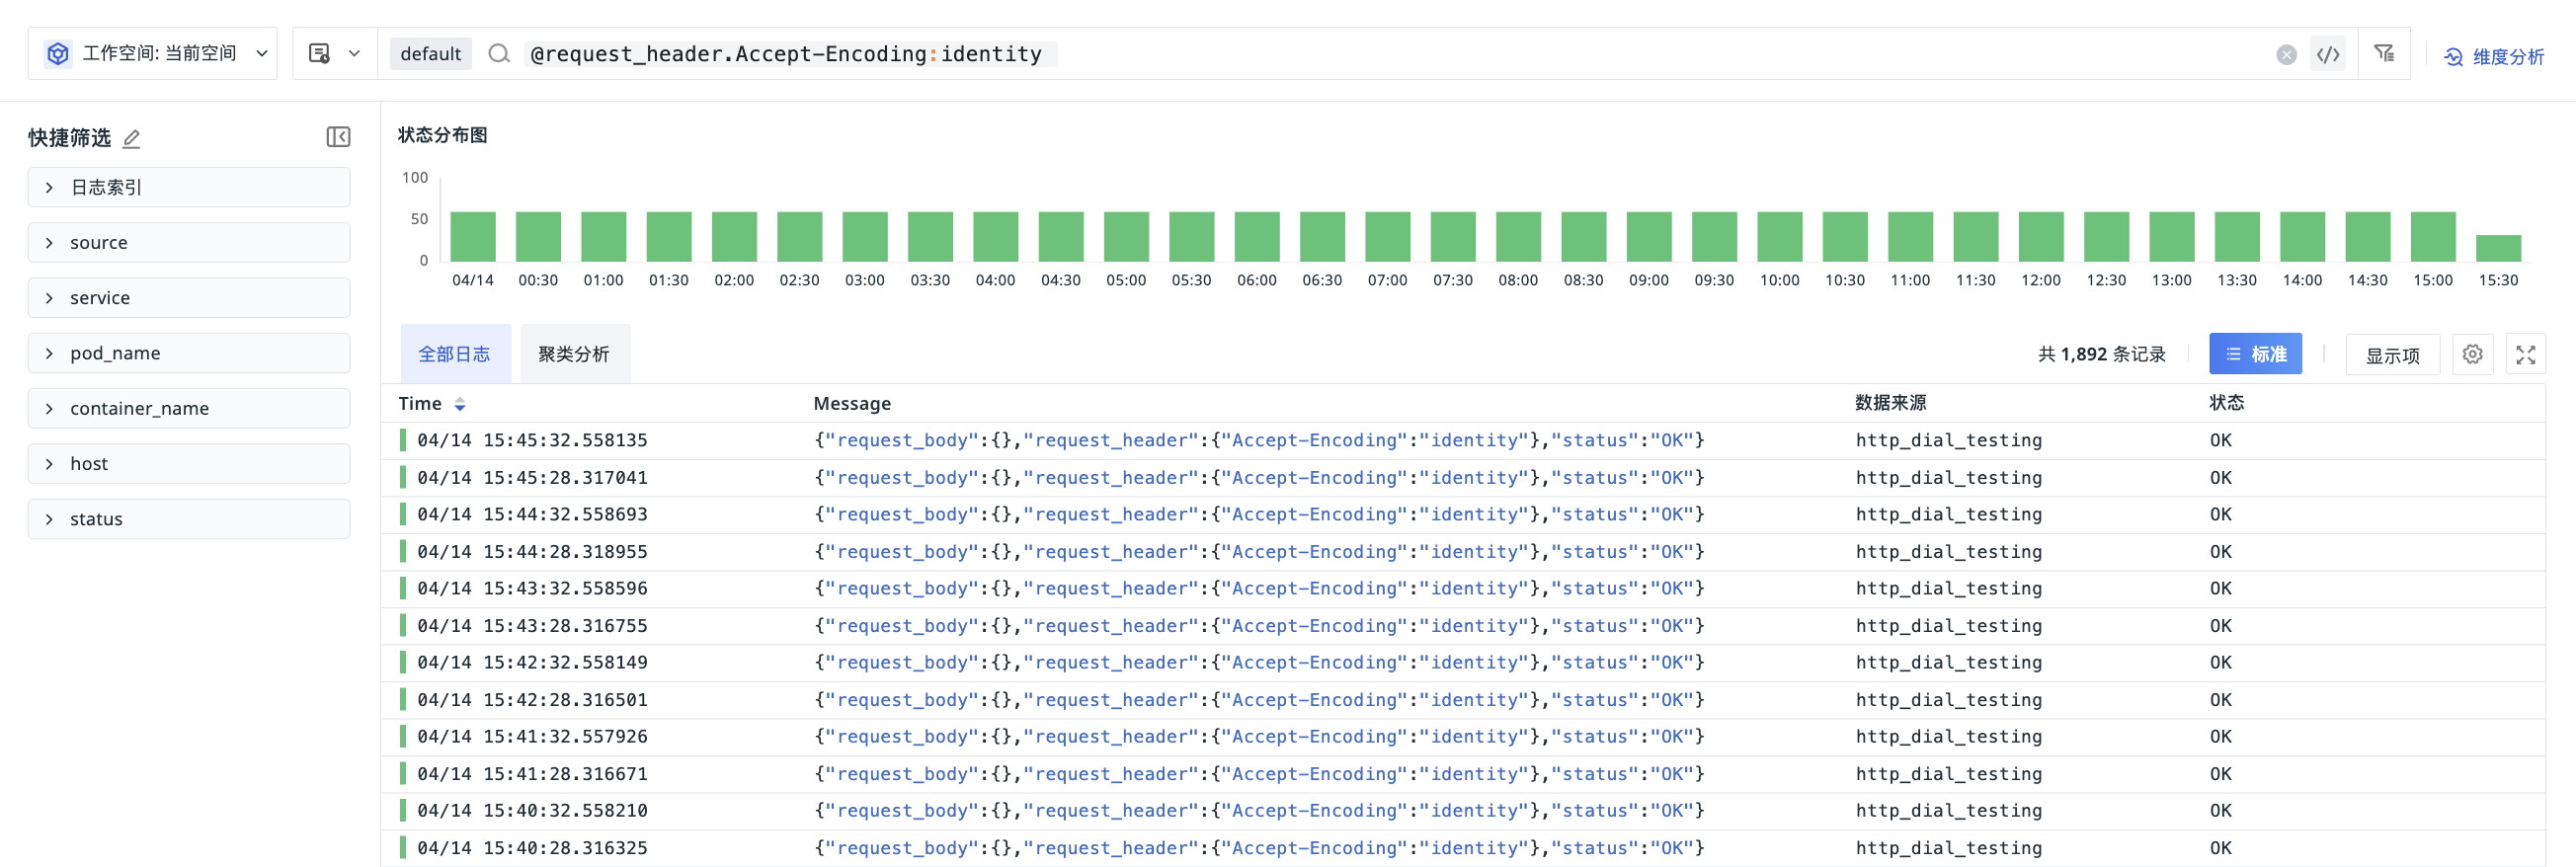
たとえば、message の内容が次のとおりであるとします:
{
  "__namespace": "tracing",
  "cluster_name_k8s": "k8s-demo",
  "meta": {
    "service": "ruoyi-mysql-k8s",
    "name": "mysql.query"
  }
}
次の条件でクエリできます:
@cluster_name_k8s:k8s-demo       # 完全一致
@cluster_name_k8s:k?s*           # ワイルドカード一致
@meta.service:ruoyi-mysql-k8s    # ネストされたフィールドをクエリ
@meta.service:ruoyi?mysql*       # ネストされたフィールドのワイルドカード一致
ここで、* は 0 個以上の文字に一致し、? は 1 文字に一致します。ここのワイルドカードはフィールド絞り込みにのみ使用され、通常のテキスト検索には適用されません。
上記の例はデフォルトで message フィールドをクエリします。同じ JSON コンテンツが payload フィールドに保存されている場合は、payload@cluster_name_k8s:k8s-demo、payload@meta.service:ruoyi-mysql-k8s などの形式でクエリします。
フィールド名に . が含まれる場合
JSON 検索では、. はデフォルトでネストされたフィールド階層を表します。フィールド名自体に . が含まれる場合は、バックスラッシュ \ でエスケープする必要があります。
| シナリオ | 正しい表記 | 説明 |
|---|---|---|
ネストされたフィールド log.tag をクエリ |
@log.tag:error |
. はフィールド階層を表します。 |
フィールド名 user.id をクエリ |
@user\.id:1001 |
\ は . をフィールド名の一部としてエスケープします。 |
フィールド名を二重引用符で囲むことはサポートされていません(例:@"user.id":1001)。
MD5 関数クエリ
機密データスキャンルールが機密コンテンツを MD5 処理する場合、元の値は不可逆な 32 桁の 16 進数ハッシュ値に置き換えられます。元の値を使用してマスク後のデータを特定する必要がある場合は、エクスプローラーで MD5 関数クエリを使用できます。
関数形式の使用を推奨します:
たとえば、color フィールドの元の値 red が MD5 ハッシュに変換されている場合は、次のように入力できます:
システムはこれを次の DQL 条件に変換します:
エクスプローラーは md5 と括弧を関数構文として認識します。既存のクエリとの互換性のため、旧表記 color:md5|red も引き続き使用でき、同じ DQL 条件を生成します。関数の引数は空にできません。MD5 は大文字と小文字および空白を区別するため、入力内容がハッシュ化前の元の値と完全に一致していることを確認してください。
MD5 は一方向ハッシュアルゴリズムであるため、ハッシュ値から元の内容を復元することはできません。詳細は機密データスキャンを参照してください。
DQL クエリ
関数、式、集計、または複雑な絞り込み条件を使用する場合は、検索バー右側の DQL ボタンをクリックし、DQL クエリモードに切り替えます:
標準モードの検索条件は、モード切り替え時に DQL に変換されます。たとえば:
| 標準モード | DQL 条件 |
|---|---|
#"connection timeout" |
search('#"connection timeout"') |
-#"health check" |
not search('#"health check"') |
color:md5(red) |
`color` = md5("red") |
システムは現在のエクスプローラーに応じて、対応するデータ型とデータソースを自動的に設定します。たとえば、次の DQL クエリは、直近 1 時間以内に message に connection timeout を含むログを検索するために使用します:
Lはログデータを表します。"default"はログインデックスを表します。logsはデータソースを表します。[1h]は直近 1 時間のデータをクエリすることを表します。
DQL モードでは、完全な DQL ステートメントを使用する必要があります。エクスプローラーごとに対応するデータ型が異なり、現在のエクスプローラーで他のデータ型に切り替えることはできません。
ログエクスプローラーの分析モード
ログエクスプローラーで高度なクエリとページの分析設定を組み合わせて使用する場合、クエリ文に BY のグループ化条件が含まれていても、ページは文内の BY を無視し、ページ設定の分析ディメンションを優先します。これにより、重複または競合するグループ化条件の発生を防ぎます。
CIDR 関数クエリ
CIDR 関数は、指定した IP フィールド内で特定のネットワークセグメントに属するデータをクエリするために使用します。文字列一致ではなく、ネットワークセグメントの範囲一致を実行します。
CIDR はネットワークアドレスとプレフィックス長で構成されます(例:13.0.0.0/8)。プレフィックス長が大きいほど、一致するアドレス範囲は小さくなります。IPv4 では /32 は 1 つの IP アドレスのみに一致します。
クエリ形式:
たとえば、network.client.ip フィールド内で 13.0.0.0/8 ネットワークセグメントに属するデータをクエリします:
単一の IPv4 アドレスを完全一致で検索する場合は、/32 を使用できます:
フィールド値が空、形式が不正、または有効な IP アドレスでない場合、一致しません。
DQL モードでは、小文字の cidr() 関数を使用し、ネットワークセグメントを二重引用符で囲むことができます:
検索履歴
ログエクスプローラーのインデックス選択履歴は、検索・絞り込み条件の履歴とは独立しており、ログインデックス検索ボックス右側の履歴アイコンから開きます。
現在のユーザーはローカルブラウザーで最近使用した検索・絞り込み条件を確認できます。最大 100 件まで保持されます。履歴条件をクリックすると、現在のエクスプローラーで再利用できます。
検索履歴の統合記録
エクスプローラーはプラットフォーム内の汎用ツールであり、複数の機能で利用されます。機能間で検索履歴の共有範囲に違いがあります:
- RUM > Session/View/Resource/Action/Long Task/Error の 6 種類のエクスプローラー間で検索履歴が共有されます。
- コンテナエクスプローラーと Kubernetes エクスプローラー間で検索履歴が共有されます。
- リソースカタログエクスプローラー間で検索履歴が共有されます。
- ログエクスプローラーとログエラー追跡エクスプローラー間で検索履歴が共有されます。
- トレースエクスプローラー、APM エラー追跡、プロファイリングエクスプローラー間で検索履歴が共有されます。
上記以外のエクスプローラーは、それぞれ独立して検索履歴を保存します。