しきい値検出
このドキュメントの位置付け
このドキュメントは、検出ルール設定フローの 2 番目のステップです。設定が完了したら、メインドキュメントに戻り、ステップ 3:イベント通知 に進んでください。
データ範囲:指標 M、ログ L、トレース T、RUM データ R、オブジェクト O など、すべてのデータタイプをサポートします)。
検出設定
検出頻度
検出を実行する時間間隔を設定します。
-
プリセットオプション:1 分、5 分、10 分、15 分、30 分、1 時間
-
Crontab モード:「Crontab モードに切り替え」をクリックすると、カスタム周期を設定できます。秒、分、時間、日、月、週などの周期に基づいて、スケジュールタスクの実行を設定できます。
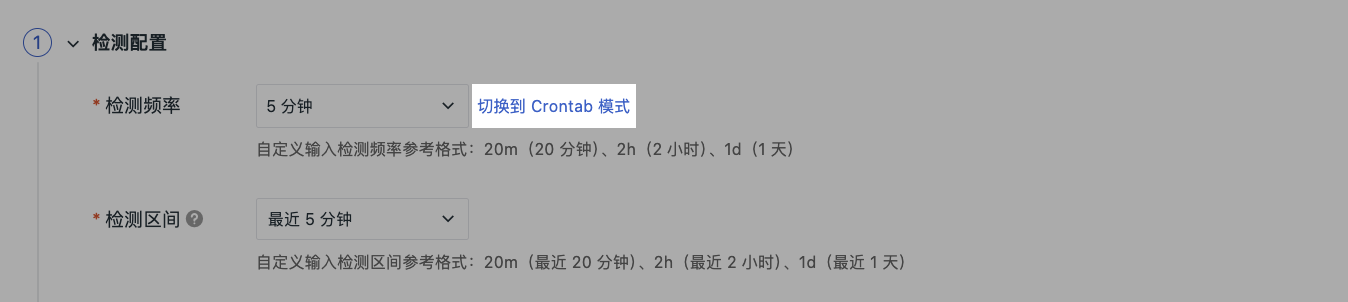
検出ウィンドウ
各検出時にクエリするデータの時間範囲を設定します(❗️検出ウィンドウは検出頻度以上である必要があり、実際のデータ報告周期と一致させることで、検出漏れや誤検出を防ぎます)。
- プリセットオプション:
| 検出頻度 | 検出ウィンドウ(ドロップダウン選択肢) |
|---|---|
| 30s | 1m/5m/15m/30m/1h/3h |
| 1m | 1m/5m/15m/30m/1h/3h |
| 5m | 5m/15m/30m/1h/3h |
| 15m | 15m/30m/1h/3h/6h |
| 30m | 30m/1h/3h/6h |
| 1h | 1h/3h/6h/12h/24h |
| 6h | 6h/12h/24h |
| 12h | 12h/24h |
| 24h | 24h |
- カスタム形式:検出ウィンドウを任意に入力できます。例:20m(直近 20 分)、2h(直近 2 時間)、1d(直近 1 日)。
検出メトリクス
DQL に基づいて検出データソースと集計方法を定義します。
検出ディメンションとして高基数フィールドを選択しないでください。設定が不適切でトリガー条件が緩すぎる場合、頻繁なアラートが発生する可能性があります。現在、クエリの最大返却件数は 10 万レコードです。
設定例:モニターの検出メトリクスを設定する際に、trace_id をグループ化フィールドとして選択した場合。
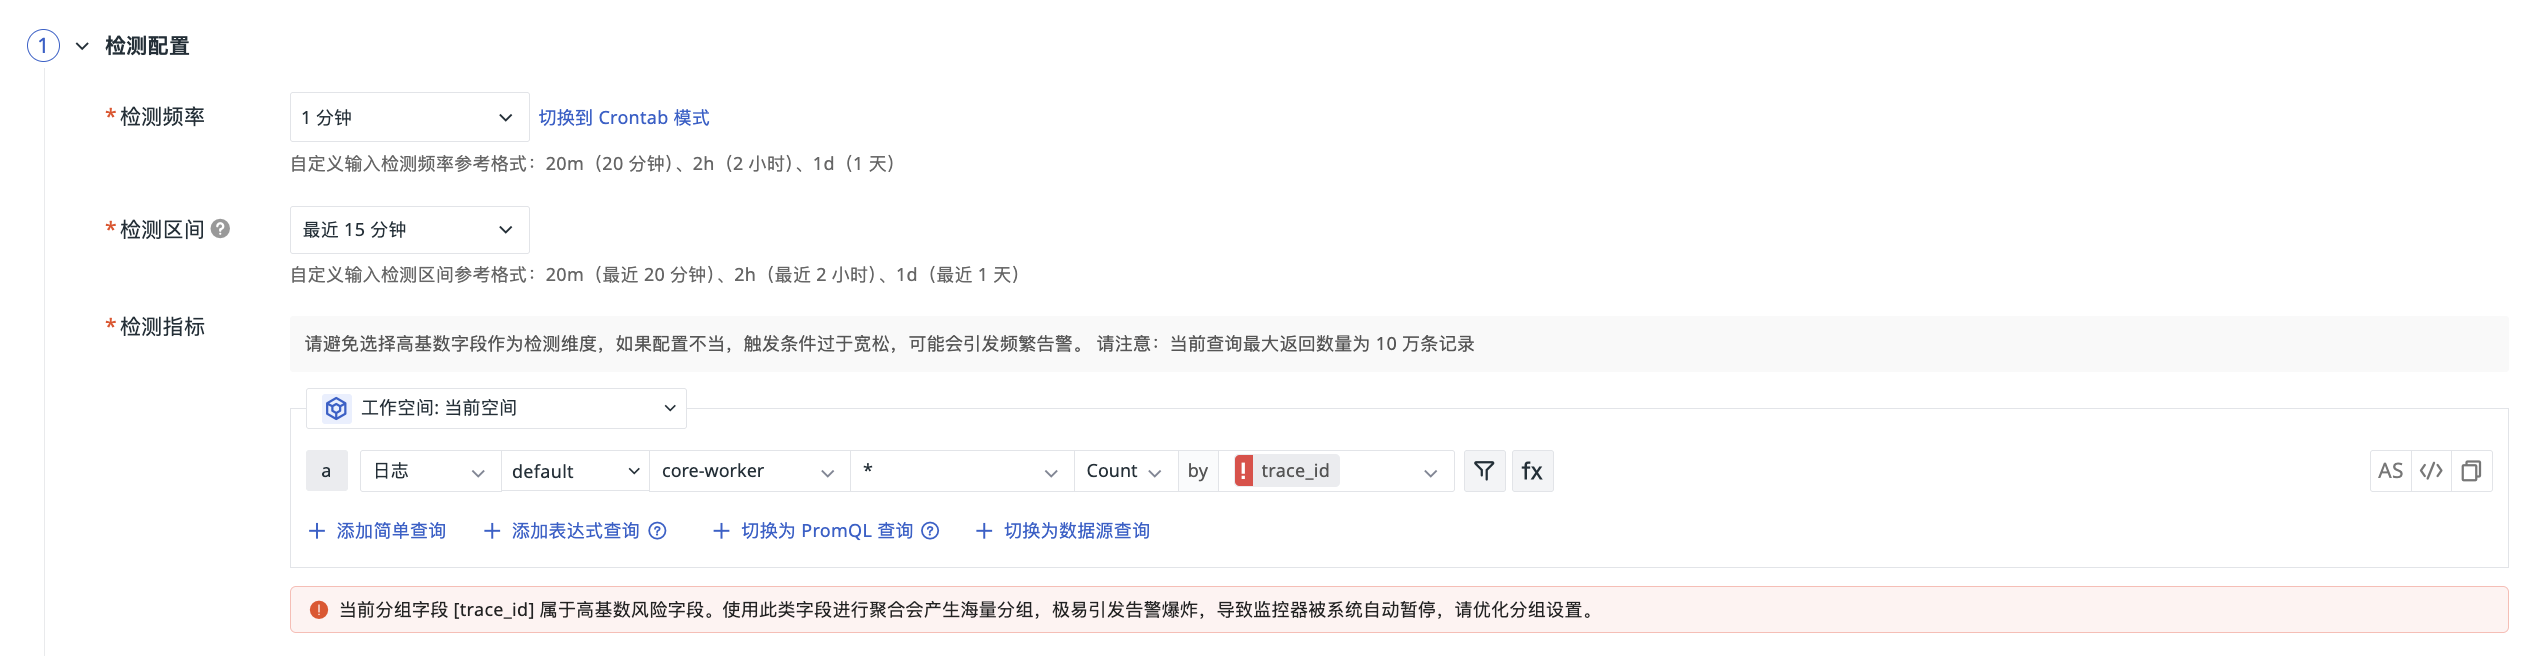
このとき、システムは次のように通知します:
現在のグループ化フィールド trace_id は高基数リスクフィールドです。このようなフィールドで集計すると大量のグループが生成され、アラート爆発を引き起こしやすくなり、モニターがシステムによって自動的に一時停止される可能性があります。グループ設定を最適化してください。
設定要素
| 設定項目 | 説明 |
|---|---|
| ワークスペース | デフォルトでは現在のワークスペースで、他の承認済みワークスペースに切り替えられます 承認後、現在のアカウント下にある他のワークスペースの検出メトリクスを使用してモニターを作成できます。ルールの作成に成功すると、ワークスペースをまたぐアラート設定が可能になります。なお、他のワークスペースを選択した場合、検出メトリクスのドロップダウンリストには、現在のワークスペースで使用が承認されているデータタイプのみが表示されます |
| データソースタイプ | 指標、ログ、トレース、RUM データなど |
| クエリ方式 | シンプルクエリ、式クエリ、PromQL クエリ、データソースクエリ |
| フィルター条件 | タグで検出対象をフィルタリングします |
| 集計方法 | avg、sum、max、min、count など |
| 関数サポート | fx ボタンをクリックすると、以下の関数を選択できます:❗️変換関数 derivative、difference、non_negative_derivative、non_negative_difference を選択する場合は、interval を追加する必要があります。例:[::5m] |
クリックすると、クエリ方式の詳細、関数の使用に関する詳細説明 を確認できます。
トリガー条件
トリガー条件と重大度を設定します。クエリ結果が複数ある場合、いずれかの値がトリガー条件を満たすとイベントが生成されます。
致命的、重大、重要、警告の 4 段階のしきい値、および正常の復旧条件を設定できます。
| レベル | 設定 | 説明 |
|---|---|---|
| 致命的 | Result >= [値] の場合 |
最高レベルのアラートであり、直ちに対処する必要があります |
| 重大 | Result >= [値] の場合 |
高レベルのアラートであり、優先的に対処する必要があります |
| 重要 | Result >= [値] の場合 |
中レベルのアラートであり、注意が必要です |
| 警告 | Result >= [値] の場合 |
低レベルのアラートであり、留意が必要です |
| 正常 | [N] 回の検出でイベントが生成されない |
検出メトリクスが「致命的」「重大」「重要」「警告」の異常イベントをトリガーした後、連続する N 回の検出がすべて正常であれば、「正常」イベントが生成されます。異常イベントが正常に復旧したかを判定するために使用します。設定を推奨します |
詳細については、イベントレベルの説明 を参照してください。
詳細オプション
連続トリガー判定
有効にすると、トリガー条件を継続的に満たした場合にのみイベントを生成し、一時的な変動による誤検出を防ぎます(❗️設定上限は最大 10 回です)。
大量アラート保護
システムではデフォルトで有効になっています。
1 回の検出で生成されるアラート数がプリセットのしきい値を超えると、システムは自動的にステータス別集約ポリシーに切り替わります:アラート対象を 1 件ずつ処理するのではなく、イベントステータスに基づいて少数のサマリーアラートを生成してプッシュします。
これにより、通知の適時性を確保しつつ、アラートノイズを大幅に削減でき、大量のアラート処理によるタイムアウトのリスクを回避できます。
このスイッチを有効にすると、その後モニターが異常を検出して生成されるこの種のイベント詳細には、履歴と関連イベントが表示されません。
復旧条件
復旧条件と重大度を設定します。クエリ結果が複数ある場合、いずれかの値がトリガー条件を満たすと復旧イベントが生成されます。
レベルごとに独立した復旧しきい値を設定し、段階的な復旧を実現します。例えば、重大アラートは値が 70 以下になると復旧し、重要アラートは 80 以下で復旧します。
アラート復旧ロジック
「復旧条件」を有効にすると、システムは Fault ID(インシデント ID)を一意の識別子として使用し、アラートのライフサイクル全体(Issue の作成など)を管理します。
段階的復旧機能を同時に有効にした場合:
-
プラットフォームは各アラートレベル(例:
critical、warning)ごとに個別の復旧ルール(復旧しきい値)を設定します -
各レベルのアラート状態と復旧状態は個別に計算されます
-
既存の Fault ID で識別されるアラートのライフサイクルには影響しません
そのため、モニターが初めてアラートをトリガーしたとき(新しいアラートライフサイクルを開始したとき)、システムは同時に 2 件のアラートメッセージを生成します。これらが同じように見えるのは、次の理由によります:
-
1 件目のアラートソース:全体検出(
check)。元のルールに基づく、インシデントライフサイクル全体の開始を表します。 -
2 件目のアラートソース:段階的検出(
critical/error/warning/…)。有効化された段階的復旧機能が開始されたことを表し、具体的なアラートレベルとその後の復旧状態(例:critical_ok)を提示するために使用されます。
上記において、df_monitor_checker_sub フィールドは 2 種類のアラートを区別する主な判断基準です:
-
check:全体検出の結果を表します。 -
その他の値(
critical、error、warningなど):段階的検出ルールの結果に対応します。
したがって、アラートが初めてトリガーされると 2 件のレコードが現れ、内容は類似していますが、ソースと用途が異なります。
df_monitor_checker_sub |
T+0 | T+1 | T+2 | T+3 |
|---|---|---|---|---|
check |
check |
error |
warning |
ok |
critical |
critical |
critical_ok |
||
error |
error |
error_ok |
||
warning |
warning |
warning_ok |
データ欠損
検出ウィンドウ内で検出メトリクスのクエリ結果が空の場合の処理ポリシー:
| オプション | 説明 |
|---|---|
| イベントをトリガーしない(デフォルト) | データがないときにアラートを生成しません。データ欠損を許容するシナリオに適しています |
| クエリ結果を 0 とみなす | 空のデータを 0 値とみなしてしきい値判定を行います |
| データ欠損イベントをトリガーする | 同一オブジェクトについて、データ欠損が発生するたびに 1 回データ欠損イベントを生成します。復旧後に再び欠損した場合は再度生成できます。 |
| データ欠損イベントを継続的にトリガーする | 同一オブジェクトがデータ欠損条件を継続的に満たす場合、データが復旧するまで検出頻度に従って欠損イベントを生成します。設定方法はデータ欠損を参照してください。 |
| 致命的イベントをトリガーする | データがないときに致命的レベルのイベントをトリガーします |
| 重大イベントをトリガーする | データがないときに重大レベルのイベントをトリガーします |
| 重要イベントをトリガーする | データがないときに重要レベルのイベントをトリガーします |
| 警告イベントをトリガーする | データがないときに警告レベルのイベントをトリガーします |
| 復旧イベントをトリガーする | データがないときに復旧イベントをトリガーします |
トリガー条件、データ欠損、情報生成を同時に設定した場合、次の優先順位でトリガーを判定します:データ欠損 > トリガー条件 > 情報イベント生成。
つまり、まずデータ欠損かどうかを判定し、次にしきい値をトリガーするかどうかを判定し、最後に情報イベントを生成するかどうかを判定します。
情報生成
このオプションを有効にすると、情報生成条件を設定する必要があります。検出結果が「致命的」「重大」「重要」「警告」のいずれのしきい値もトリガーせず、かつ情報生成条件を満たす場合にのみ、システムは「情報」イベントを書き込みます。
正常な状態変化や低優先度の情報を記録する必要があるシナリオに適しています。
後続の設定
上記の検出設定が完了したら、引き続き次を設定してください: