SLO
Guance の SLO は、サービスが合意した信頼性目標を継続的に達成しているかを評価するために使用します。直近 7 日間または 30 日間を評価期間として選択し、モニターの異常時間またはビジネス成功数に基づいて達成率を計算し、目標を下回った場合にアラートポリシーを通じて関係者に通知できます。
概念
| 用語 | 説明 |
|---|---|
| SLI(サービスレベル指標) | サービス品質を測定する指標。例: 稼働時間の割合、リクエスト成功率。 |
| SLO(サービスレベル目標) | 指定した評価期間内に SLI が達成すべき目標。例: 「直近 30 日間のリクエスト成功率 99.9%」。 |
| SLA(サービスレベル契約) | サービス提供者と顧客が取り決めたサービス品質の保証。SLO の達成率はサービス品質の継続的な監視に利用できます。 |
| エラーバジェット | 目標が許容する失敗の枠。モニタータイプの SLO では、許容できる異常時間として表されます。 |
SLI タイプの選択
| SLI タイプ | ユースケース | 達成率の計算 |
|---|---|---|
| モニター | モニターを使用してサービスの異常を判定しており、サービスの正常稼働時間の割合を評価したい場合。 | (評価期間の時間 − 異常時間)÷ 評価期間の時間 × 100%。 |
| メトリクス | リクエスト数やタスク数などのビジネス数量を収集しており、成功したリクエストまたはタスクの割合を評価したい場合。 | 成功数 ÷ 総数 × 100%。 |
例えば、同じ決済サービスでも、モニターを選択するとサービスの正常稼働時間を評価でき、メトリクスを選択すると統計対象となった決済リクエストのうち成功した割合を評価できます。ビジネス上の合意に応じて統計の基準を選択してください。
モニタータイプ
1 つ以上のモニターを SLI として選択します。システムはこれらのモニターが生成した異常イベントに基づいて異常のカバー時間を計算し、分単位で異常による減点を算出します。複数の異常がカバーする時間帯はマージされ、重複部分は 1 回だけ計算されます。グループ化ディメンションが設定されている場合は、各ディメンションの組み合わせごとに個別に計算されます。
例えば、モニター A が 10:00–10:05 に異常、モニター B が 10:03–10:08 に異常で、両方が同じ評価対象に属する場合。マージ後、異常のカバー時間は 10:00–10:08 となり、今回の減点は 8 分です。
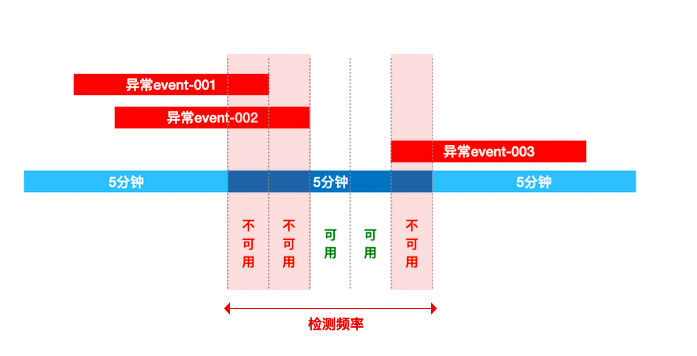
選択した評価期間内の累積異常減点に基づいて計算します:
- 達成率 = (期間の総分数 − 累積異常分数)÷ 期間の総分数 × 100%。
- 初期エラーバジェット = 期間の総分数 ×(1 − 目標 ÷ 100)。
- 残存エラーバジェット = 初期エラーバジェット − 累積異常分数。
7 日間、目標 99.9% の場合、期間は合計 7 × 24 × 60 = 10,080 分で、初期エラーバジェットは 10,080 × 0.1% = 10.08 分です。この 7 日間に上記の 8 分間の異常のみが発生した場合、達成率は約 99.9206%、残存エラーバジェットは 2.08 分となります。
作成時には、目標と最低目標に従ってイベントしきい値を設定します。プロジェクト、環境、サービスごとに個別に評価する必要がある場合は、グループ化ディメンションを設定します。
メトリクスタイプ
総数と成功数のクエリをそれぞれ設定し、同じビジネス範囲の評価期間内の数量を集計して成功率を計算します。具体的な設定と例については、SLO の作成を参照してください。
検出のたびに完全な期間の統計結果が生成され、ページには直近の有効な結果とデータの集計時点が表示されます。メトリクスタイプはビジネスの成功率の測定に使用します。障害時間や時間単位のエラーバジェットはモニタータイプに使用されます。
評価期間と検出頻度
評価期間は各評価がカバーする時間範囲を決定し、直近 7 日間または 30 日間に対応します。検出頻度は結果の更新間隔を決定し、5 分または 10 分に対応します。
例えば、評価期間が 30 日間、検出頻度が 5 分の場合、5 分ごとにそれまでの 30 日間のサービスパフォーマンスを再評価することを意味します。