ログインデックス
システムは設定したフィルター条件に基づいて、ログデータを自動的に該当するインデックスにアーカイブします。複数のログインデックスを作成することで、以下が可能になります。
- ビジネスライン、環境、プロジェクトごとにログデータを分離する
- インデックスごとに異なる保存ポリシーを設定する
- クエリパフォーマンスを最適化し、無関係なデータのスキャンを減らす
注意
❗️ デフォルトでは、ログインデックスを新規作成できません。この機能の利用をご希望の場合は、アカウントマネージャーに連絡して申請してください。
作成
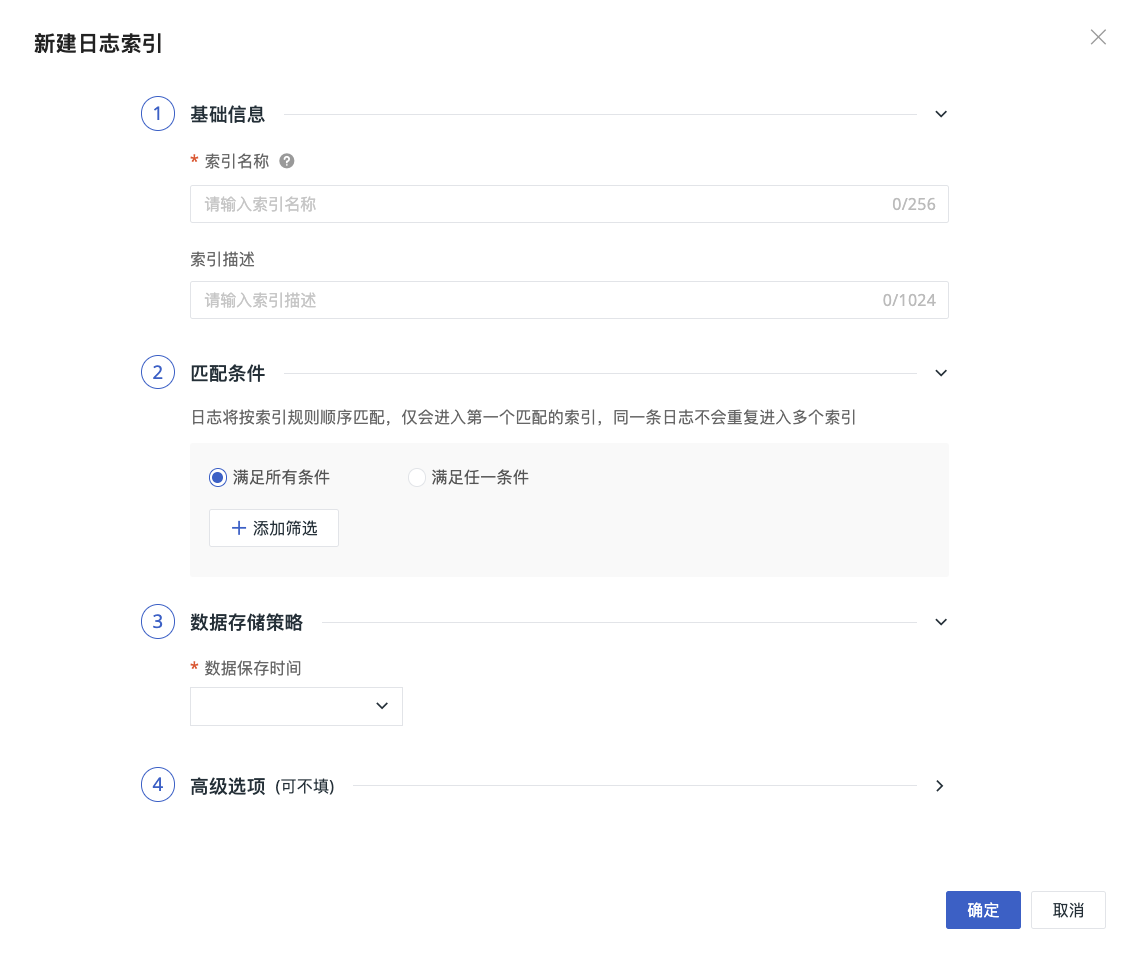
- インデックス作成 > ログインデックス ページに移動します。
- インデックス名を任意に設定します。
- 必要に応じて説明を追加します。
- マッチ条件 を追加します。
-
データ保存ポリシーを設定します:ログの保持期間を選択し、期限切れ後に自動的にクリーンアップします。
- デプロイメントプランのユーザーは保存期間をカスタマイズできます。範囲:1d ~ 1,800d
-
必要に応じてクローンインデックスを設定します。
-
クローン設定には、名前、保存時間、クローン条件が含まれます。
-
必要に応じて詳細オプション を設定します。
- 確定します。
マッチ条件
マッチ条件は、ログが現在のインデックスに入るためのフィルタールールを定義するために使用します。現在は、通常マッチと詳細マッチの2つの設定モードをサポートしています。
通常マッチ
通常マッチは従来の設定方法をそのまま使用し、フィルターロジックが比較的単純なシナリオに適しています。
-
条件の関係を選択します:
- すべての条件を満たす:ログがすべてのフィルター条件を同時に満たす場合にのみ、現在のインデックスに入ります。
- いずれかの条件を満たす:ログがいずれかのフィルター条件を満たす場合、現在のインデックスに入ります。
-
フィルター条件を追加します:
- フィールド名:
source、service、hostなどのログフィールドを選択します。 - 演算子:マッチ方法を選択します。
- マッチ値:フィールド値を入力します。複数の値は半角カンマで区切ります。
- フィールド名:
通常マッチは、固定フィールドでインデックスの振り分けをすばやく設定する場合に適しています。
詳細マッチ
詳細マッチは、マッチルールをより柔軟に組み合わせる必要があるシナリオに適しています。詳細マッチを有効にすると、ログデータは Pipeline に入ってマッチ判定が行われ、対応する費用が発生します。
詳細マッチでは、複数のフィルター条件を設定できます。各条件には以下が含まれます:
- フィールド名:判定するログフィールドを入力します。
- マッチ方法:
=、!=、in、not in、match、not match、wildcard、not wildcardをサポートします。 - マッチ値:フィールドに対応するマッチ値を入力します。
フィルターを追加 をクリックすると条件をさらに追加できます。すべての条件をクリア をクリックすると、現在設定されているすべての条件を削除できます。
ページ下部には式プレビューが表示され、現在のフィルター条件から最終的に生成されるマッチ式を確認できます。条件が不完全または式が無効な場合、ページには「フィルター条件を完成または修正してください」と表示されます。この場合は、フィールド名、マッチ方法、またはマッチ値を補充してから保存する必要があります。
注意
ログはインデックスリストの順序でマッチングされ、通常インデックスのマッチング段階では、最初にヒットした通常インデックスのみに書き込まれます。この通常インデックスにクローンルールが設定されており、ログがクローン条件を満たす場合、システムは対応するクローンインデックスに追加で非同期コピーを1部作成します。
詳細オプション
詳細オプションはデフォルトで展開されています。ここで全文インデックスフィールドを確認または選択できます。
全文インデックスフィールド
-
全行インデックス(作成時のデフォルト):全文検索はログ内のすべてのビジネスフィールドを対象とし、システムフィールドは含みません。システムはビジネスフィールドをまとめて
variantに書き込み、variantに対してのみ全文インデックスを作成します。 -
messageのみのインデックスフィールド(既存データ互換):全文検索は元のmessageフィールドのみを対象とし、システムはmessageに対して全文インデックスを作成します。
新規作成するログインデックスはデフォルトで全行インデックスを使用します。すでに message インデックスフィールドを使用している既存のログインデックスは引き続き使用できますが、全行インデックスに切り替えることもできます。この切り替えは単方向の操作であり、全行インデックスに切り替えた後は message のみのインデックスに戻すことはできません。
JSON Path クエリ高速化の再設定
元のインデックスで message フィールド内の JSON Path に対してクエリ高速化を設定している場合、全行インデックスに切り替えた後、これらの JSON Path のクエリ高速化を再設定する必要があります。設定方法は JSON Path 内蔵フィールドのクエリ高速化 を参照してください。
全行インデックスのログに message が存在する場合、システムはこのフィールドを削除せず、通常のビジネスフィールドとして variant に書き込みます。システムは message と variant に対して2つの全文インデックスを同時に作成することはありません。重複インデックスによる追加のストレージコストを避けるためです。
全行インデックスのデータ処理方式
message が存在しない場合:
ビジネスフィールド → variant → 全文インデックス

message が存在する場合:
message + その他のビジネスフィールド → variant → 全文インデックス
message が存在するかどうかは、クライアントまたは Pipeline の実際の処理結果によって決まります。同じログインデックスに、message を含むログと含まないログを同時に格納できます。
DataKit の JSON フィールド抽出を設定する場合、または Pipeline でフィールドを抽出した後に元の message を削除する場合は、全行インデックス を参照してください。
従来の「マッチングサービス」機能は、ログインデックスマッピング に移行されました。
クローンインデックス
クローンインデックスは、通常のログインデックスから一部のログデータをさらに絞り込んでコピーするために使用します。クエリ頻度が高く、データ範囲が明確なログは、専用のクローンインデックスにコピーすることで、クエリ時にスキャンするデータ量を減らし、ログ検索の効率を向上させることができます。
ログはまず通常インデックスの並び順に従ってマッチングされ、最初にヒットした通常インデックスに書き込まれます。書き込み完了後、システムはこのインデックスに設定されたクローン条件に基づいて、ログをクローンインデックスにコピーする必要があるかどうかを非同期で判断します。
ログの送信
   ↓
通常インデックスを順番にマッチング
   ↓
最初にヒットした通常インデックスに書き込み
   ↓
クローンルールが設定されているか判断
   ↓
クローン条件を満たす ──→ クローンインデックスに非同期コピー
条件を満たさない   ──→ クローンを実行しない
クローンタスクは非同期で実行されます。クローンに失敗しても、ログのソースインデックスへの書き込みには影響しません。
ユースケース
クローンインデックスは以下のシナリオに適しています:
- 高頻度のクエリで通常インデックス内の一部のログのみに注目する場合。
- サービス、環境、ステータス、ビジネスタイプなどの条件でクエリ範囲を絞り込む必要がある場合。
- 通常インデックスのデータ量が大きく、よく使うクエリのスキャン量を減らしたい場合。
- 高頻度のクエリデータに対してより短い保存時間を設定したい場合。
- ソースインデックスに完全なログを保持しつつ、日常の調査により適した簡潔なデータセットを別途作成したい場合。
例えば、通常インデックス application にすべてのアプリケーションログが保存されており、日常の調査では主に本番環境のエラーログに注目しているとします。この場合、application にクローンインデックス application_error を設定し、以下のクローン条件を構成できます:
条件を満たす新しいログは、以下の両方に保存されます:
- ソースインデックス:
application - クローンインデックス:
application_error
本番環境のエラーログをクエリする際は、application_error を直接選択できるため、application の全量データのスキャンを減らせます。
クローンインデックスの設定
通常のログインデックスを新規作成または編集するときに、必要に応じてクローンインデックスを設定できます:
- ログ > インデックス に移動します。
- ログインデックスを新規作成するか、既存の通常のログインデックスを編集します。
- クローンインデックス の設定を見つけます。
- クローンインデックスを有効にします。
- クローンインデックス名を入力します。
- クローンインデックスのデータ保存時間を設定します。
- クローン条件を追加します。
- インデックス設定を保存します。
各通常インデックスには、クローンインデックスを最大1つだけ設定できます。
クローンインデックス名
クローンインデックス名は、インデックスリストとログエクスプローラーでこのインデックスを識別するために使用します。
名前を設定する際の注意点:
- クローンインデックス名は現在のワークスペース内で一意である必要があります。
- クローンインデックスは、既存の通常インデックス、ネイティブ直接書き込みインデックス、外部インデックス、または他のクローンインデックスと同名にすることはできません。
- 作成後、クローンインデックスはソースインデックスの2階層目の行として表示されます。
- クローンインデックスは他のクローンインデックスのソースにすることはできません。
保存時間
クローンインデックスには独立したデータ保存時間を設定できますが、ソースインデックスの保存時間を超えることはできません。
| ソースインデックスの保存時間 | クローンインデックスに設定できる保存時間 |
|---|---|
| 7 日 | 7 日以内 |
| 14 日 | 14 日以内 |
| 30 日 | 30 日以内 |
ソースインデックスの保存時間を変更する場合は、クローンインデックスの保存時間が引き続き制限を満たしていることを確認する必要があります。
クローンインデックス内のログは保存期間に達すると自動的にクリーンアップされますが、ソースインデックス内の元のログには影響しません。
クローン条件
クローン条件は、ソースインデックス内のログをクローンインデックスにコピーする必要があるかどうかを判断するために使用します。
ログフィールドに基づいてフィルタールールを設定できます。例:
sourceserviceenvstatushost- その他のログフィールド
以下のすべての条件を同時に満たすログのみがクローンインデックスに入ります:
- ログがソースの通常インデックスに正常に書き込まれていること。
- ログが現在設定されているクローン条件を満たしていること。
- クローンルールがこのログの書き込み前にすでに有効になっていること。
クローン条件を満たさないログは、引き続きソースインデックスに正常に保存されますが、クローンインデックスにはコピーされません。
データ内容
クローンインデックスは、ソースログのフィールドとタグを完全に保持します。クローン条件で使用したフィールドのみを保持するわけではありません。
コピー後のログには以下が含まれます:
- 元のログのビジネスフィールド。
- 元のログのタグ。
- 元のログに存在する
message。 - ログのクエリと表示に必要な関連情報。
クローン操作によって、ソースインデックス内のログが変更または削除されることはありません。
適用範囲
クローンルールは、ルールが有効になった後にソースインデックスへ新しく書き込まれたログのみを処理します。
以下の操作が完了した後、システムはいずれも操作の有効化時点から以降のログを処理します:
- クローンルールの新規作成。
- クローンルールの有効化。
- クローン条件の変更。
- クローンインデックス関連設定の変更。
システムはソースインデックスを自動的にスキャンして履歴データをバックフィルすることはありません。そのため、ルールが有効になる前にソースインデックスに書き込まれたログは、クローンインデックスに自動的にコピーされません。
例えば、2026-08-19 10:00:00 にクローンルールを有効にした場合:
10:00:00以降に新しく書き込まれ、条件を満たすログはクローンインデックスに入ります。10:00:00より前に存在していた履歴ログは自動的にバックフィルされません。
クローンインデックスの表示とクエリ
クローンインデックスはソースインデックスの子ノードとして表示されます。ソースインデックスが親ノード、クローンインデックスが子ノードとなります。クローンインデックスが存在する場合、インデックスツリーはデフォルトで展開されます。
クローンインデックスには専用のアイコンまたは識別子が表示され、通常インデックスと区別できます。
インデックスを検索する場合:
- ソースインデックス名を検索すると、そのソースインデックスとそのクローンインデックスが同時に表示されます。
- クローンインデックス名を検索すると、対応するソースインデックスが上位ノードとして保持され、インデックスの関係を確認しやすくなります。
クエリ時の注意点:
- ソースインデックスとクローンインデックスを同時に選択することはできません。
- ソースインデックスを選択しても、そのクローンインデックスは自動的にクエリされません。
- クローンインデックスを選択した場合は、そのクローンインデックス内のデータのみがクエリされます。
- ワイルドカード
*はデフォルトインデックスとすべての通常インデックスを含みますが、クローンインデックスは含みません。 - クローンインデックスをクエリする場合は、対応するクローンインデックスを明示的に選択する必要があります。
クローンインデックスは、以下のクエリ入口で選択できます:
- ログエクスプローラー。
- メトリクス分析。
- シナリオチャートおよびダッシュボードのログ DQL エディター。
- ダッシュボードのログビュー変数。
- ログモニターのクエリ。
クローンインデックスは、以下の設定入口には独立したインデックスとして表示されません:
- インデックス設定。
- Pipeline。
- フィールドマッピング。
- データルーティング。
- データアクセスルール。
- ログの並び替え。
- データソースインデックスセレクター。
編集と有効化・無効化
通常インデックスを編集するときに、対応するクローンルールを変更できます。
クローンルールを変更または再び有効化した後:
- 新しいルールは有効化時点以降に新しく書き込まれたログのみに適用されます。
- すでにクローンインデックスに書き込まれた履歴ログは、新しいルールに従って再処理されません。
- すでにソースインデックスに書き込まれた履歴ログは自動的にバックフィルされません。
- ルールを変更しても、ソースインデックス内の既存のログデータは変更されません。
クローンルールを無効にすると、以降のログはクローンインデックスにコピーされなくなります。クローンインデックス内で保存期間内の履歴ログは引き続きクエリできます。
制限事項
| 制限項目 | 説明 |
|---|---|
| ソースインデックス | 通常のログインデックスのみクローンインデックスを設定できます |
| クローン数 | 各通常インデックスにクローンインデックスを最大1つ設定できます |
| クローン階層 | クローンインデックスにさらにクローンインデックスを設定することはできません |
| 保存時間 | クローンインデックスの保存時間はソースインデックスを超えられません |
| データ範囲 | クローンルールが有効になった後に新しく書き込まれたログのみを処理します |
| 履歴データ | ソースインデックス内の履歴ログは自動的にバックフィルされません |
| データ内容 | 元のログのフィールドとタグを完全に保持します |
| 異常処理 | クローンに失敗してもソースインデックスへの書き込みには影響しません |
| 一覧の並び順 | クローンインデックスは通常インデックスの並べ替えとページングには含まれません |
| エクスプローラークエリ | 「すべてのログ」にはクローンインデックスは自動的に含まれないため、明示的に選択する必要があります |
注意
- クローンインデックスは高頻度クエリのデータ範囲を絞り込むためのものであり、ソースの通常インデックスを置き換えるものではありません。
- 同じログをソースインデックスとクローンインデックスの両方に同時に存在させることができます。
- クローン条件を変更しても、すでに書き込まれた履歴ログは再処理されません。
- クローンデータをクエリする際は、ログエクスプローラーで対応するクローンインデックスを明示的に選択してください。
インデックスの制限
| 制限項目 | 説明 |
|---|---|
| 合計上限 | 6 個(default デフォルトインデックスを含む)。つまり、カスタムインデックスは最大 5 個作成できます |
| マッチメカニズム | 順次マッチングで、最初にマッチしたインデックスが有効になり、以降のインデックスはマッチングされません |
| 保存期間 | デプロイメントプランは 1d ~ 1,800d をサポートし、SaaS 版はページで選択可能な範囲に準拠します |
| クローンインデックス | 1 つの通常インデックスにつき最大 1 つのクローンインデックス。クローン階層は最大 1 層。クローンの保存時間はソースインデックスを超えません。マッチ条件を変更しても履歴データはバックフィルされません |