外部データソース
DataFlux Func や MySQL など、さまざまなデータソースを Guance に迅速に統合し、データのシームレスなクエリと可視化を実現します。
機能
- ネイティブクエリ:グラフでデータソースのネイティブクエリ文を直接使用。追加の変換は不要です。
- データ保護:データセキュリティとプライバシーの観点から、すべてのデータソース情報はお客様のローカル Func にのみ保存され、プラットフォームには保存されません。これにより情報の安全性が確保され、データ漏洩を防止します。
- カスタム管理:実際のニーズに応じて、さまざまな外部データソースを簡単に追加・管理できます。
- リアルタイムデータ:外部データソースに直接接続し、リアルタイムでデータを取得。即座に応答し、意思決定を行えます。
2 つの統合方法
Guance 側でデータソースを追加する
拡張機能 から直接、接続済みの DataFlux Func を追加または確認し、さらにすべての接続済み外部データソースを管理します。
注意
この方法は、2 つ目の方法 よりも初心者に優しいため、推奨します。
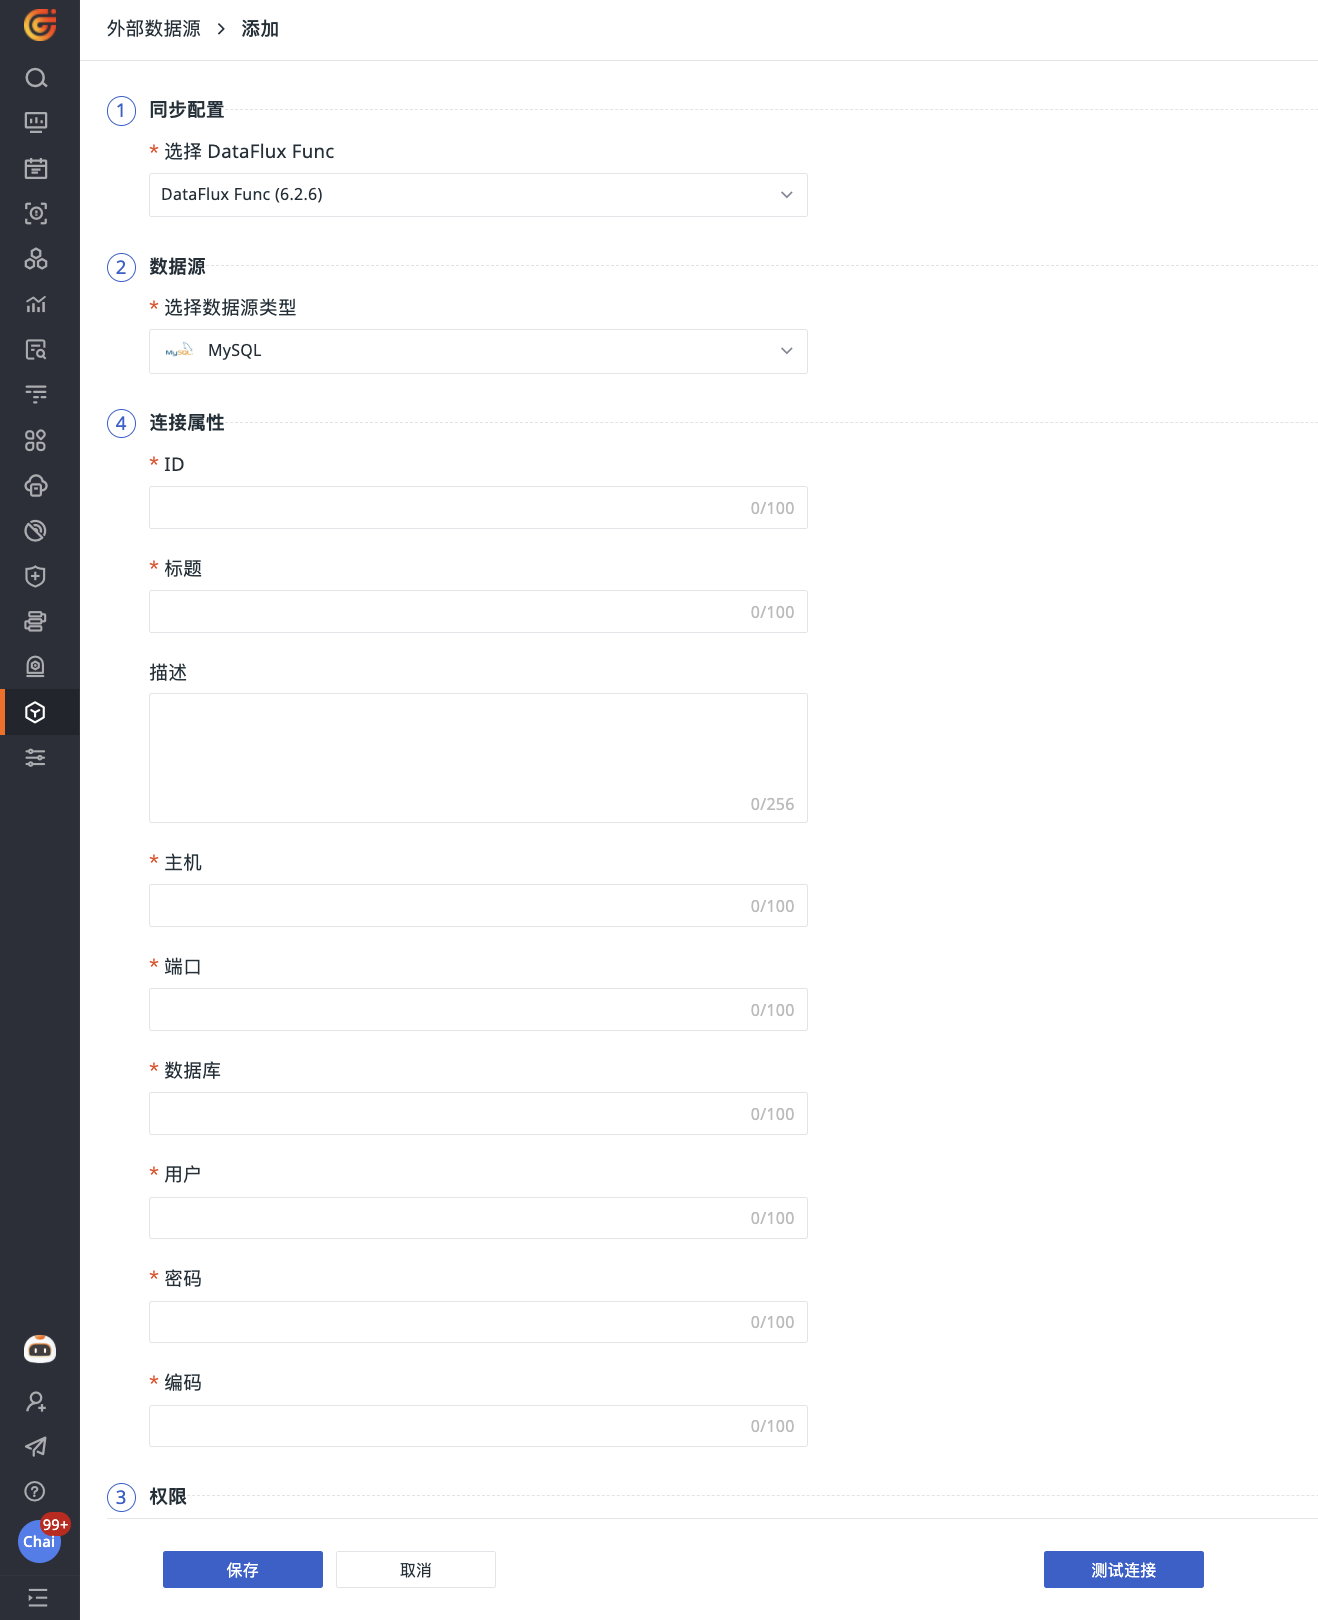
- プルダウンで DataFlux Func を選択します。
- サポートされているデータソースの種類を選択します。
- 接続プロパティ(ID、データソースのタイトル、関連付けるホスト、ポート、データベース、ユーザー、パスワード)を定義します。
- 必要に応じて接続をテストします。
- 保存します。
Func を使用して外部データソースをクエリする
注意
ここでいう「外部データソース」は広義の定義であり、一般的な外部データストレージシステム(MySQL、Redis などのデータベース)だけでなく、サードパーティシステム(例:Guance コンソール)も含まれます。
前提条件
対応するインストールパッケージをダウンロードし、クイックスタート に従って Func プラットフォームをデプロイする必要があります。
デプロイ完了後、初期化が完了するのを待ってからプラットフォームにログインします。
Func と Guance を関連付ける
コネクタを使用すると、開発者は Guance システムに接続できます。
開発 > コネクタ > コネクタを追加 ページに移動します。
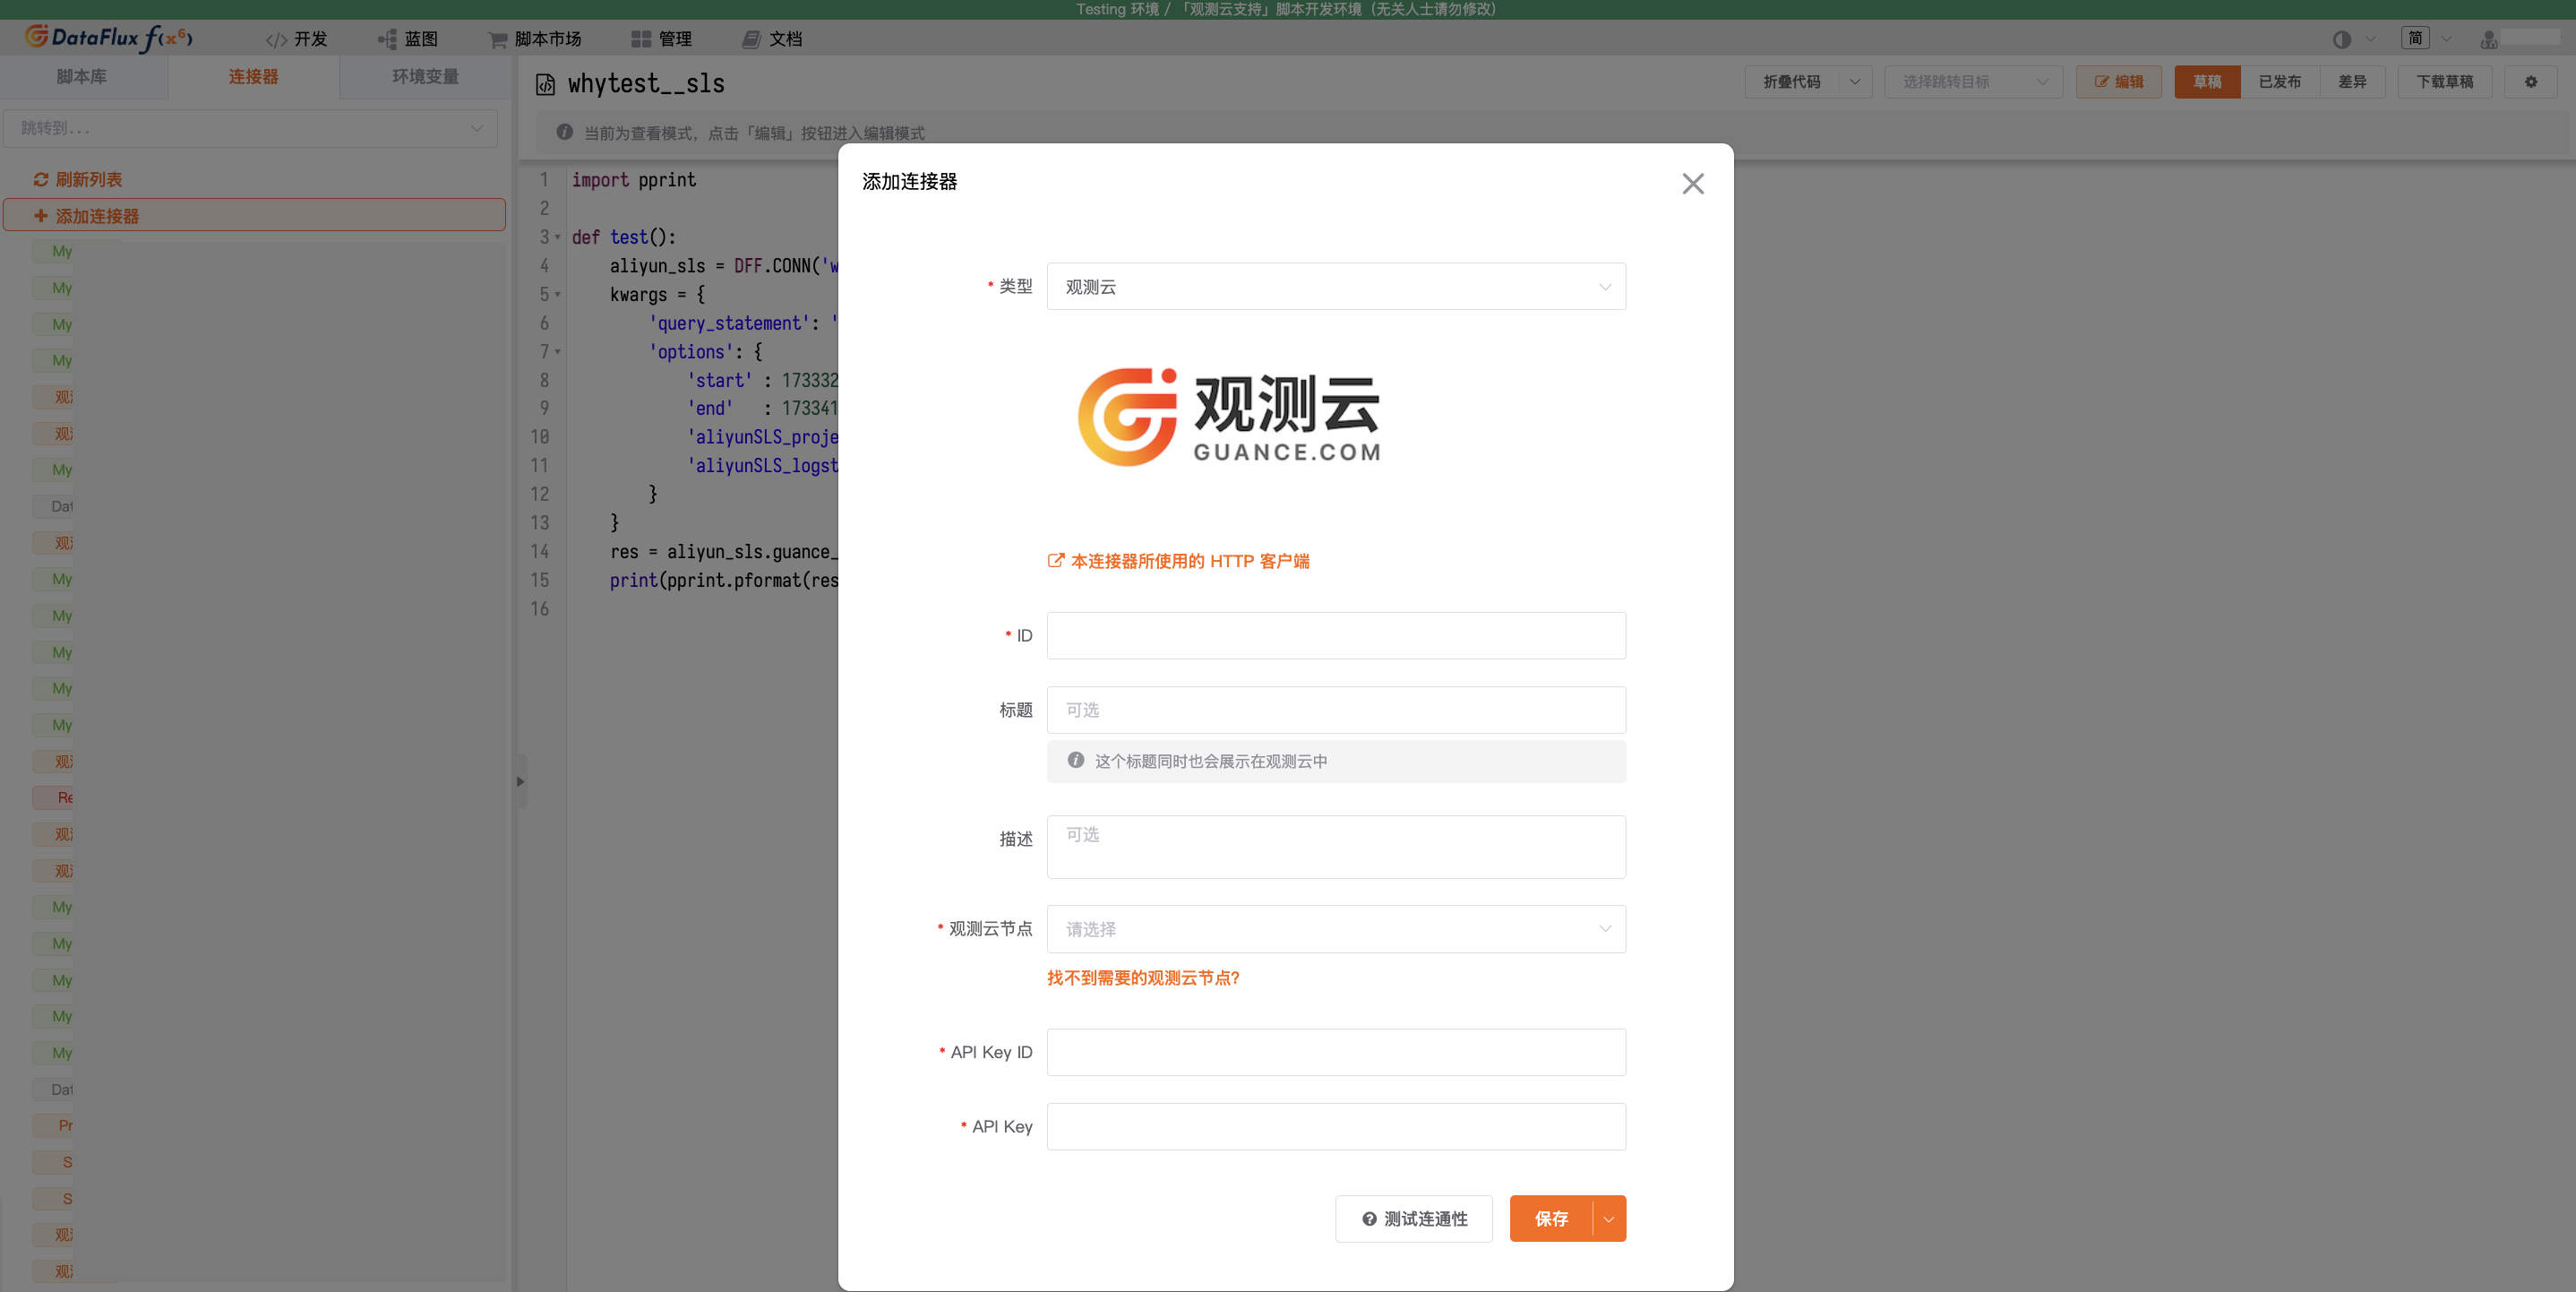
- コネクタの種類を選択します。
- このコネクタの ID をカスタマイズします。
- タイトルを追加します。このタイトルは Guance ワークスペース内にも表示されます。
- 必要に応じて、このコネクタの説明を入力します。
- Guance ノードを選択します。
- API Key ID と API Key を追加します。
- 必要に応じて接続性をテストします。
- 保存します。
関連付けが完了すると、Func プラットフォームでは以下の 2 つの方法でデータソースをクエリできます。
API Key を取得する方法
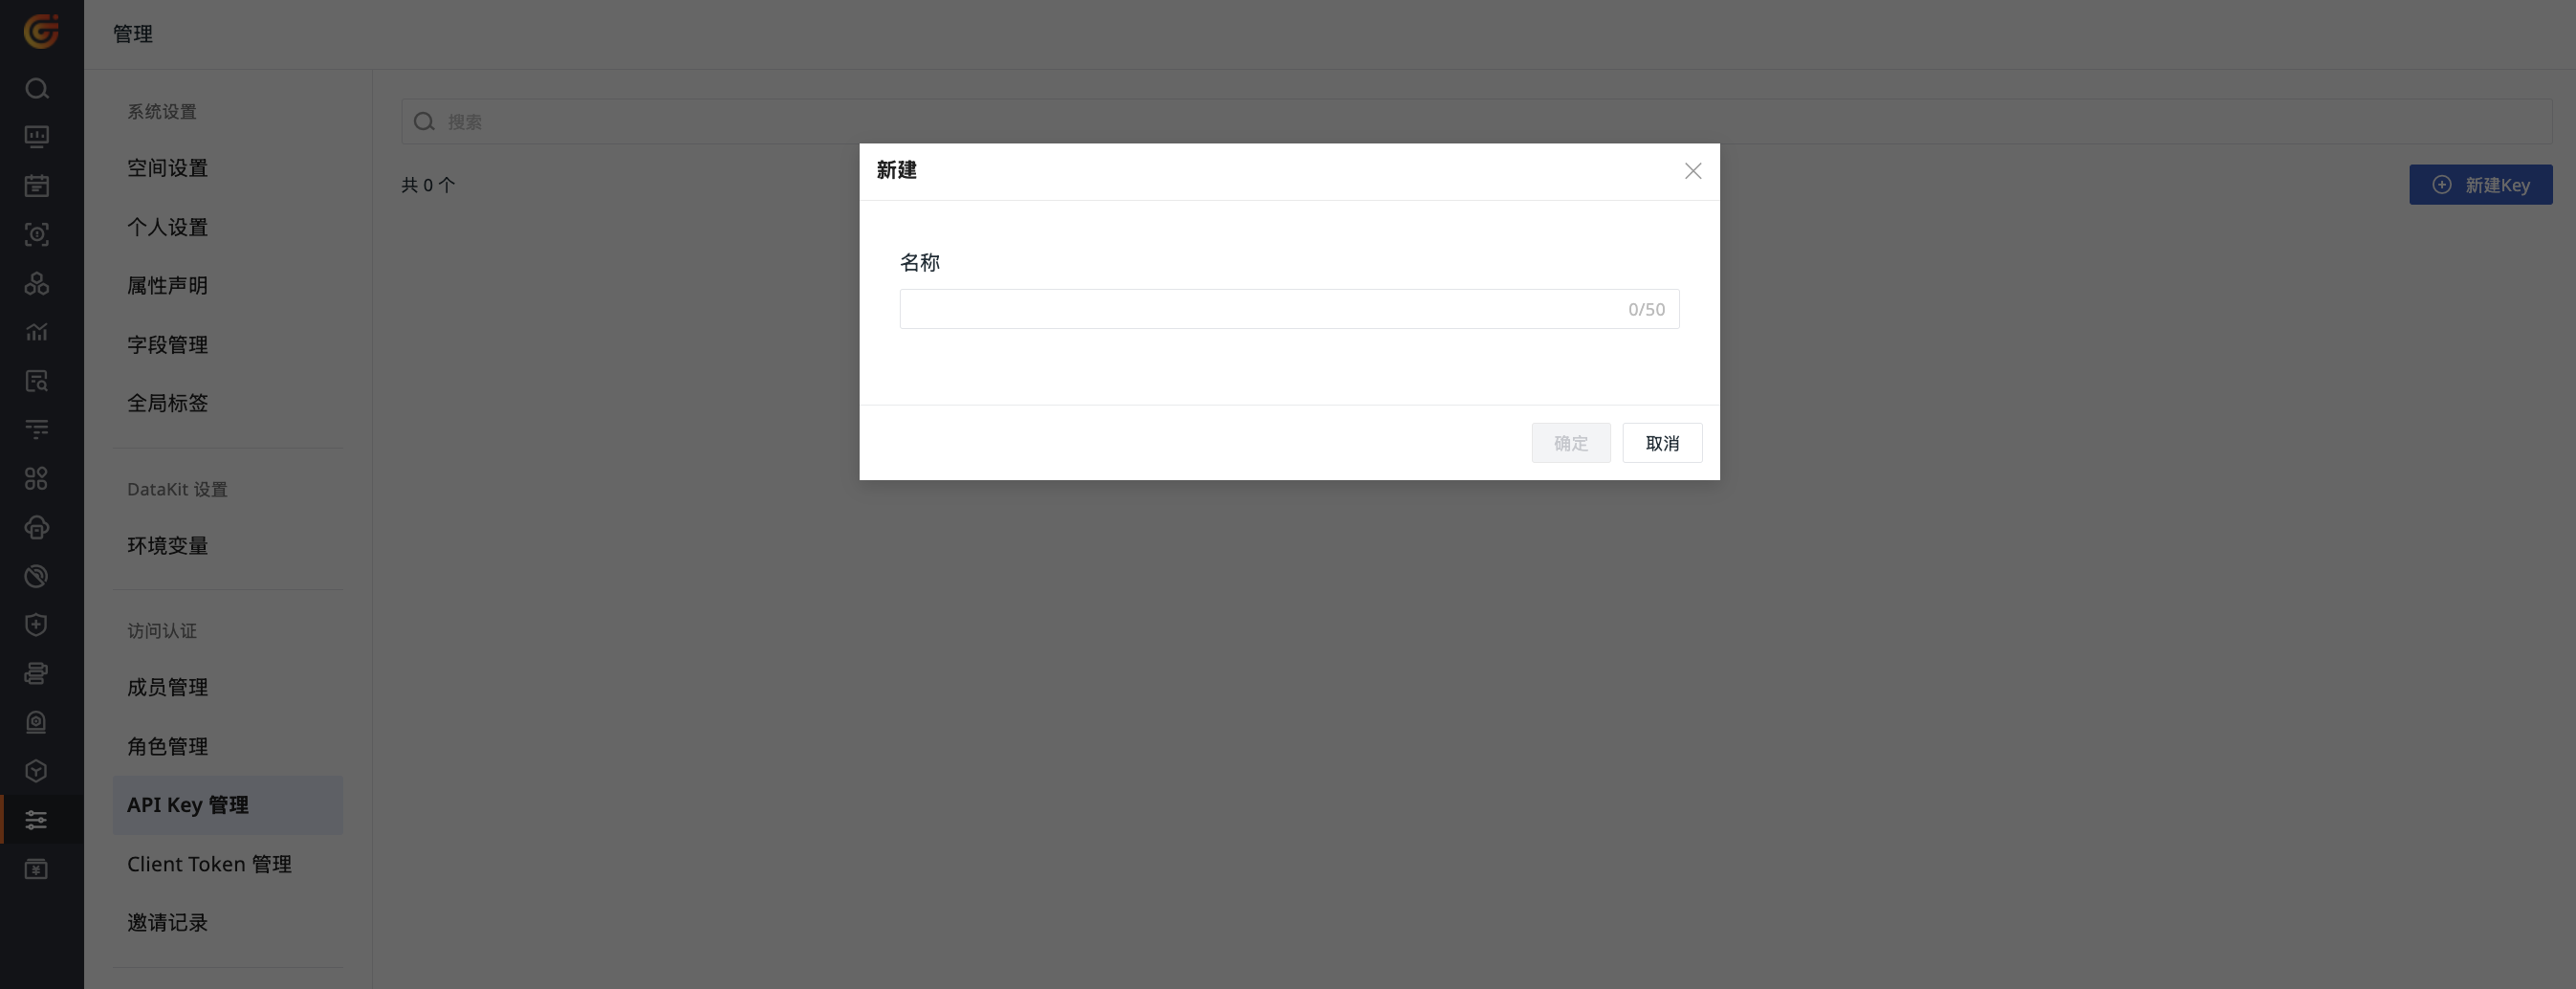
- Guance ワークスペース > 管理 > API Key 管理 に移動します。
- ページ右側の Key を新規作成 をクリックします。
- 名前を入力します。
- OK をクリックします。システムが自動的に API Key を作成します。API Key 内で確認できます。
詳細については、API Key 管理 を参照してください。
コネクタを使用する
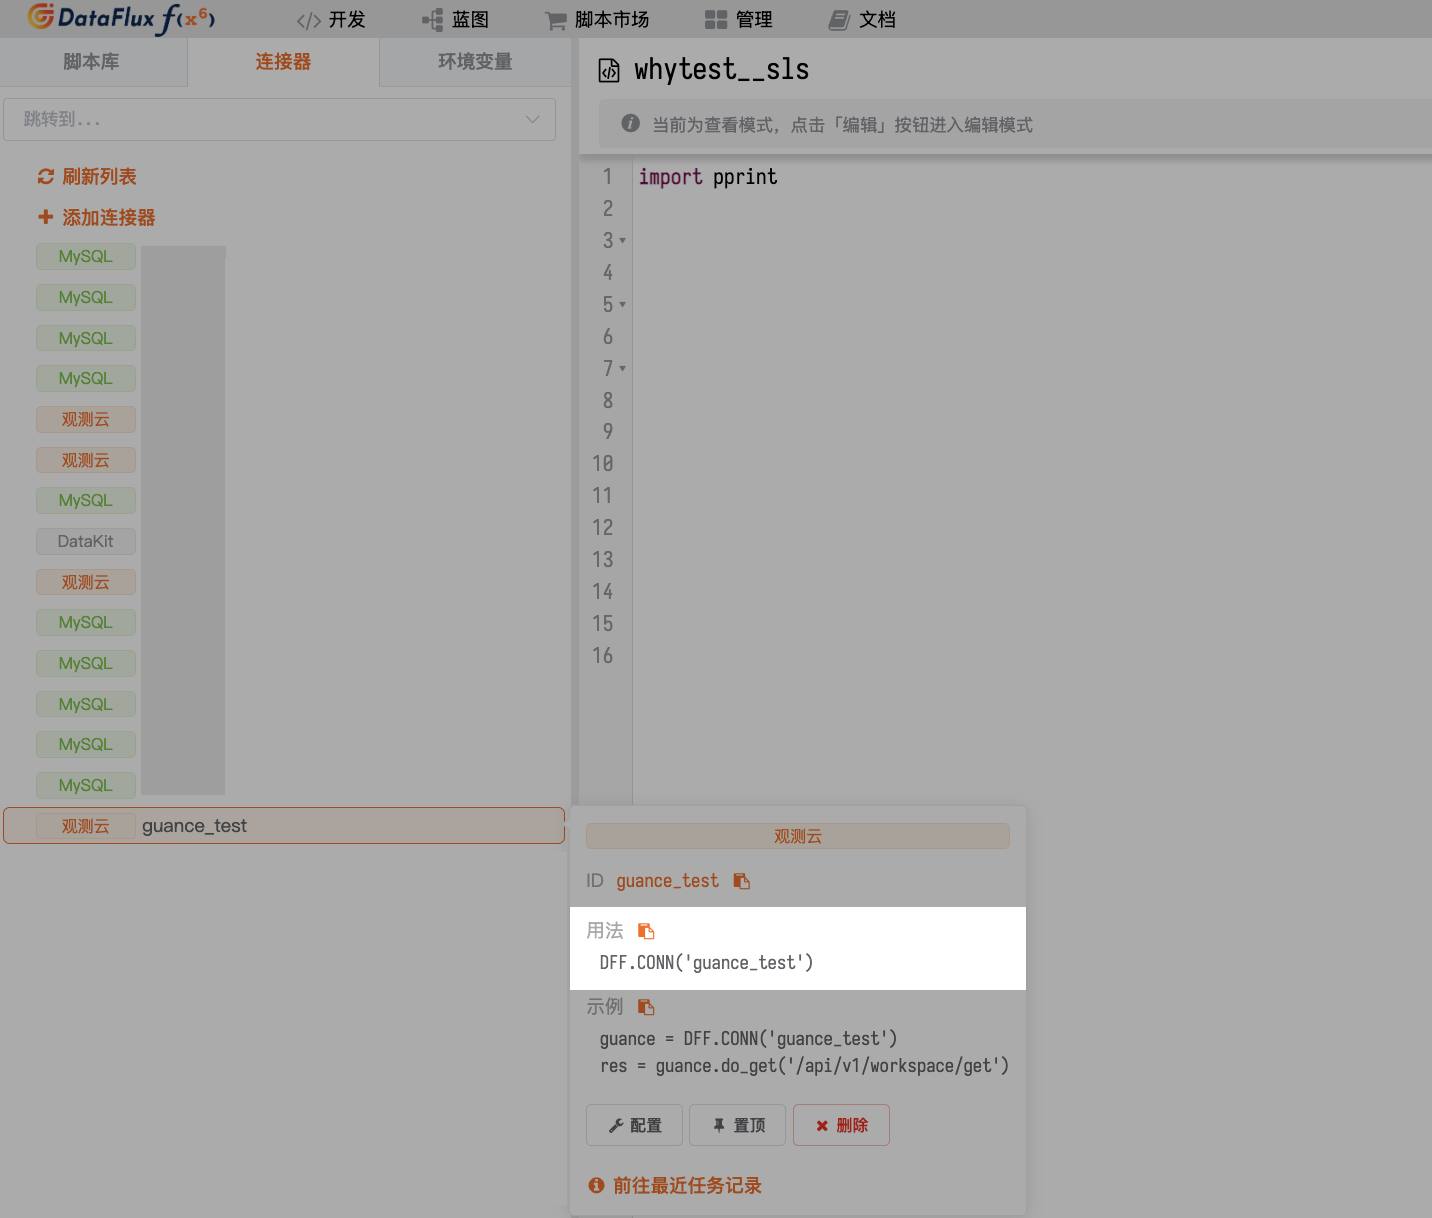
コネクタを正常に追加すると、スクリプト内でコネクタ ID を使用して、対応するコネクタの操作オブジェクトを取得できます。
上記のコネクタを例にとると、このコネクタの操作オブジェクトを取得するコードは次のとおりです。
スクリプトを自作する
コネクタを使用する以外に、関数を自作してデータをクエリすることもできます。
ユーザーが MySQL コネクタ(ID を mysql と定義)を正しく作成し、この MySQL に my_table というテーブルが存在し、以下のデータが含まれていると仮定します。
id |
userId |
username |
reqMethod |
reqRoute |
reqCost |
createTime |
|---|---|---|---|---|---|---|
| 1 | u-001 | admin | POST | /api/v1/scripts/:id/do/modify | 23 | 1730840906 |
| 2 | u-002 | admin | POST | /api/v1/scripts/:id/do/publish | 99 | 1730840906 |
| 3 | u-003 | zhang3 | POST | /api/v1/scripts/:id/do/publish | 3941 | 1730863223 |
| 4 | u-004 | zhang3 | POST | /api/v1/scripts/:id/do/publish | 159 | 1730863244 |
| 5 | u-005 | li4 | POST | /api/v1/scripts/:id/do/publish | 44 | 1730863335 |
| ... |
ここで、データクエリ関数を使用してこのテーブルのデータをクエリし、フィールド抽出ルールが次のようになっていると仮定します。
| 元のフィールド | 抽出先 |
|---|---|
createTime |
時間 time |
reqCost |
列 req_cost |
reqMethod |
列 req_method |
reqRoute |
列 req_route |
userId |
タグ user_id |
username |
タグ username |
この場合、完全な参考コードは次のとおりです。
- データクエリ関数の例
import json

@DFF.API('my_table からのデータをクエリ', category='dataPlatform.dataQueryFunc')
def query_from_my_table(time_range):
    # コネクタ操作オブジェクトを取得
    mysql = DFF.CONN('mysql')

    # MySQL クエリ文
    sql = '''
      SELECT
        createTime, userId, username, reqMethod, reqRoute, reqCost
      FROM
        my_table
      WHERE
        createTime     > ?
        AND createTime < ?
      LIMIT 5
    '''

    # 渡される time_range の単位はミリ秒だが、
    # MySQL の createTime フィールドの単位は秒なので変換が必要
    sql_params = [
      int(time_range[0] / 1000),
      int(time_range[1] / 1000),
    ]

    # クエリを実行
    db_res = mysql.query(sql, sql_params)

    # DQL ライクな戻り値に変換

    # タグが異なる場合、複数のデータ系列を生成する必要がある可能性がある
    # データ系列のタグをキーとしてマッピングテーブルを作成
    series_map = {}

    # 元データを走査し、構造を変換してマッピングテーブルに格納
    for d in db_res:
        # タグを収集
        tags = {
            'user_id' : d.get('userId'),
            'username': d.get('username'),
        }

        # タグをシリアライズ(タグキーをソートし、出力を統一)
        tags_dump = json.dumps(tags, sort_keys=True, ensure_ascii=True)

        # このタグのデータ系列がまだ作成されていない場合は作成
        if tags_dump not in series_map:
            # データ系列 series の基本構造
            series_map[tags_dump] = {
                'columns': [ 'time', 'req_cost', 'req_method', 'req_route' ], # 列(1 列目は固定で time )
                'tags'   : tags,                                              # タグ
                'values' : [],                                                # 値リスト
            }

        # 時間、列を抽出し、value に追加
        series = series_map[tags_dump]
        value = [
            d.get('createTime') * 1000, # 時間 time(出力単位はミリ秒。実際に応じて変換が必要)
            d.get('reqCost'),           # 列 req_cost
            d.get('reqMethod'),         # 列 req_method
            d.get('reqRoute'),          # 列 req_route
        ]
        series['values'].append(value)

    # DQL の外側の構造を追加
    dql_like_res = {
        # データ系列
        'series': [ list(series_map.values()) ] # ここではさらに配列でラップすることに注意
    }
    return dql_like_res
データ変換処理のみを理解したい場合や、クエリプロセスを気にしない場合(または実際のデータベースがない場合)は、次のコードを参照してください。
- データクエリ関数の例(MySQL クエリ部分なし)
import json

@DFF.API('どこかからのデータをクエリ', category='dataPlatform.dataQueryFunc')
def query_from_somewhere(time_range):
    # 何らかの方法で元データを取得したと仮定
    db_res = [
        {'createTime': 1730840906, 'reqCost': 23,   'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/modify',  'username': 'admin',  'userId': 'u-001'},
        {'createTime': 1730840906, 'reqCost': 99,   'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/publish', 'username': 'admin',  'userId': 'u-001'},
        {'createTime': 1730863223, 'reqCost': 3941, 'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/publish', 'username': 'zhang3', 'userId': 'u-002'},
        {'createTime': 1730863244, 'reqCost': 159,  'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/publish', 'username': 'zhang3', 'userId': 'u-002'},
        {'createTime': 1730863335, 'reqCost': 44,   'reqMethod': 'POST', 'reqRoute': '/api/v1/scripts/:id/do/publish', 'username': 'li4',    'userId': 'u-003'}
    ]

    # DQL ライクな戻り値に変換

    # タグが異なる場合、複数のデータ系列を生成する必要がある可能性がある
    # データ系列のタグをキーとしてマッピングテーブルを作成
    series_map = {}

    # 元データを走査し、構造を変換してマッピングテーブルに格納
    for d in db_res:
        # タグを収集
        tags = {
            'user_id' : d.get('userId'),
            'username': d.get('username'),
        }

        # タグをシリアライズ(タグキーをソートし、出力を統一)
        tags_dump = json.dumps(tags, sort_keys=True, ensure_ascii=True)

        # このタグのデータ系列がまだ作成されていない場合は作成
        if tags_dump not in series_map:
            # データ系列 series の基本構造
            series_map[tags_dump] = {
                'columns': [ 'time', 'req_cost', 'req_method', 'req_route' ], # 列(1 列目は固定で time )
                'tags'   : tags,                                              # タグ
                'values' : [],                                                # 値リスト
            }

        # 時間、列を抽出し、value に追加
        series = series_map[tags_dump]
        value = [
            d.get('createTime') * 1000, # 時間 time(出力単位はミリ秒。実際に応じて変換が必要)
            d.get('reqCost'),           # 列 req_cost
            d.get('reqMethod'),         # 列 req_method
            d.get('reqRoute'),          # 列 req_route
        ]
        series['values'].append(value)

    # DQL の外側の構造を追加
    dql_like_res = {
        # データ系列
        'series': [ list(series_map.values()) ] # ここではさらに配列でラップすることに注意
    }
    return dql_like_res
- 戻り値の例
{
  "series": [
    [
      {
        "columns": ["time", "req_cost", "req_method", "req_route"],
        "tags": {"user_id": "u-001", "username": "admin"},
        "values": [
          [1730840906000, 23, "POST", "/api/v1/scripts/:id/do/modify" ],
          [1730840906000, 99, "POST", "/api/v1/scripts/:id/do/publish"]
        ]
      },
      {
        "columns": ["time", "req_cost", "req_method", "req_route"],
        "tags": {"user_id": "u-002", "username": "zhang3"},
        "values": [
          [1730863223000, 3941, "POST", "/api/v1/scripts/:id/do/publish"],
          [1730863244000,  159, "POST", "/api/v1/scripts/:id/do/publish"]
        ]
      },
      {
        "columns": ["time", "req_cost", "req_method", "req_route"],
        "tags": {"user_id": "u-003", "username": "li4"},
        "values": [
          [1730863335000, 44, "POST", "/api/v1/scripts/:id/do/publish"]
        ]
      }
    ]
  ]
}
管理リスト
接続済みのすべてのデータソースは、インテグレーション > 外部データソース > 接続済みのデータソース で確認できます。
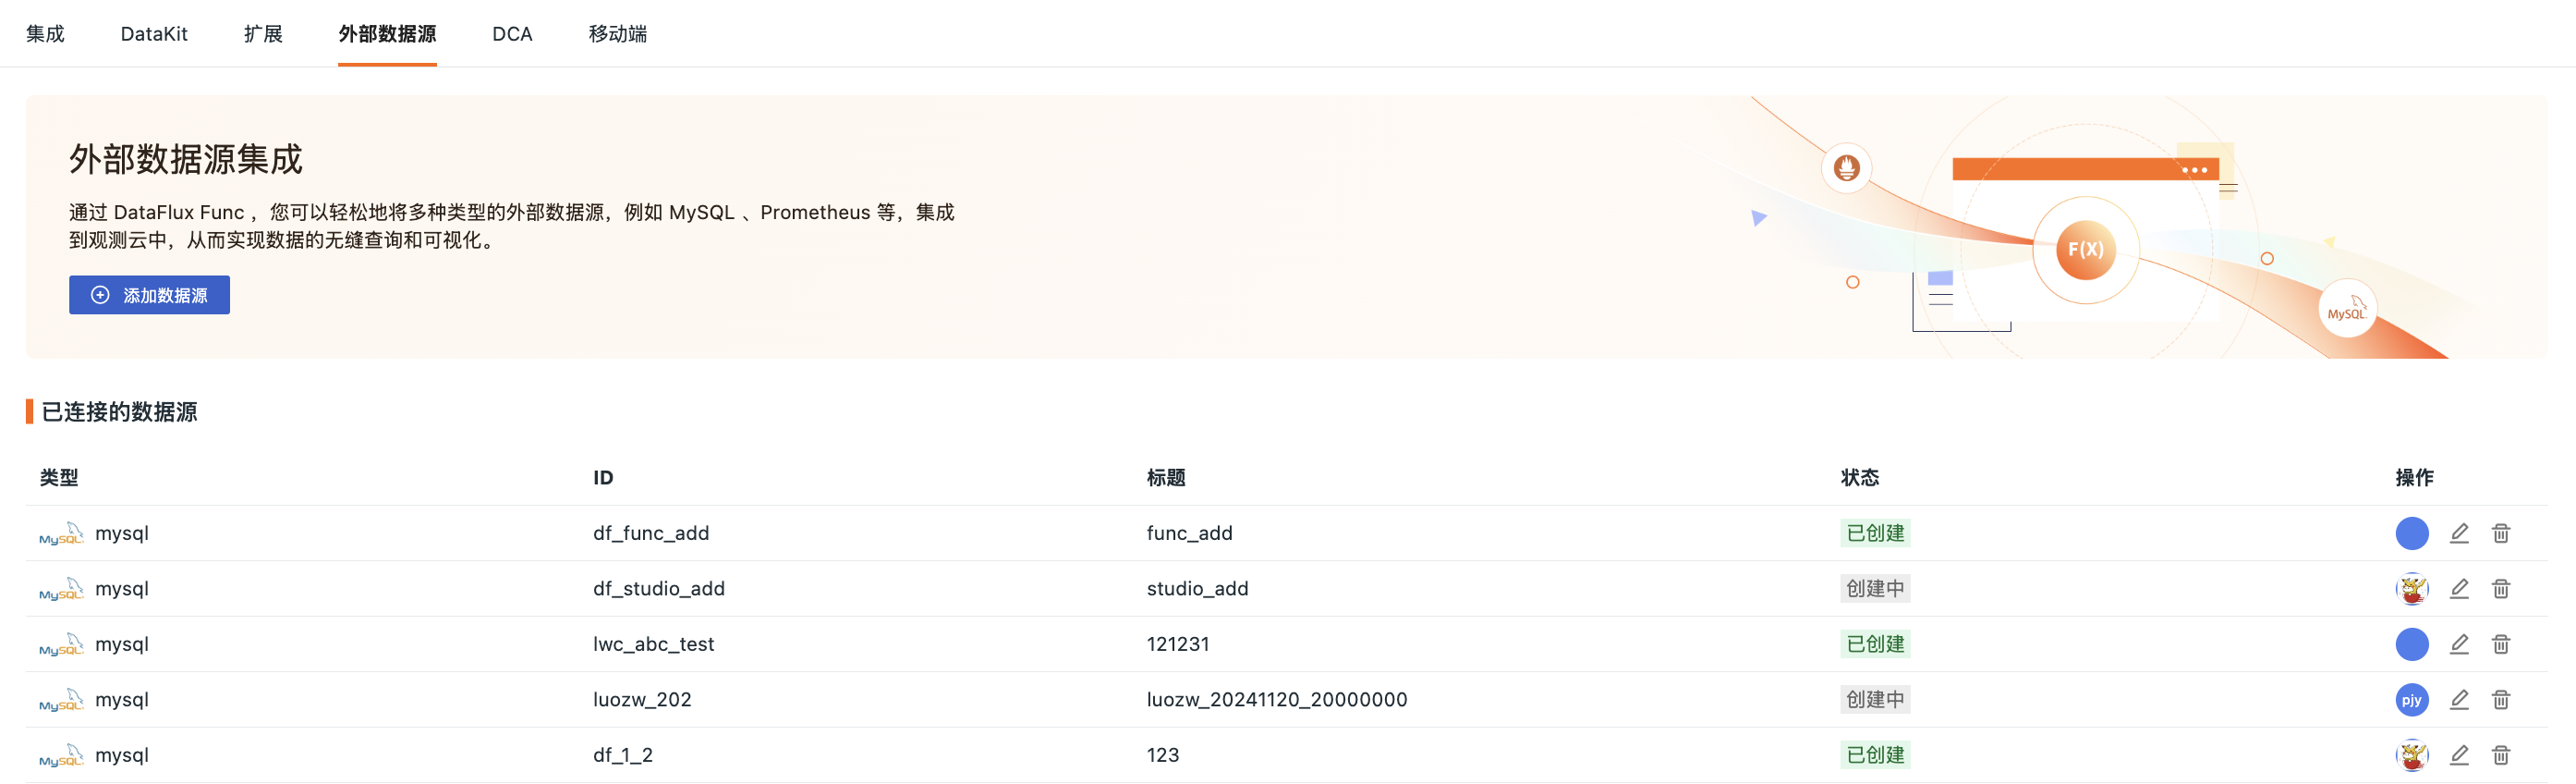
リストでは、次の操作を実行できます。
- データソースのタイプ、ID、ステータス、作成情報、更新情報などを表示します。
- データソースを編集し、DataFlux Func、データソースのタイプ、ID 以外の設定を変更します。
- データソースを削除します。
ユースケース
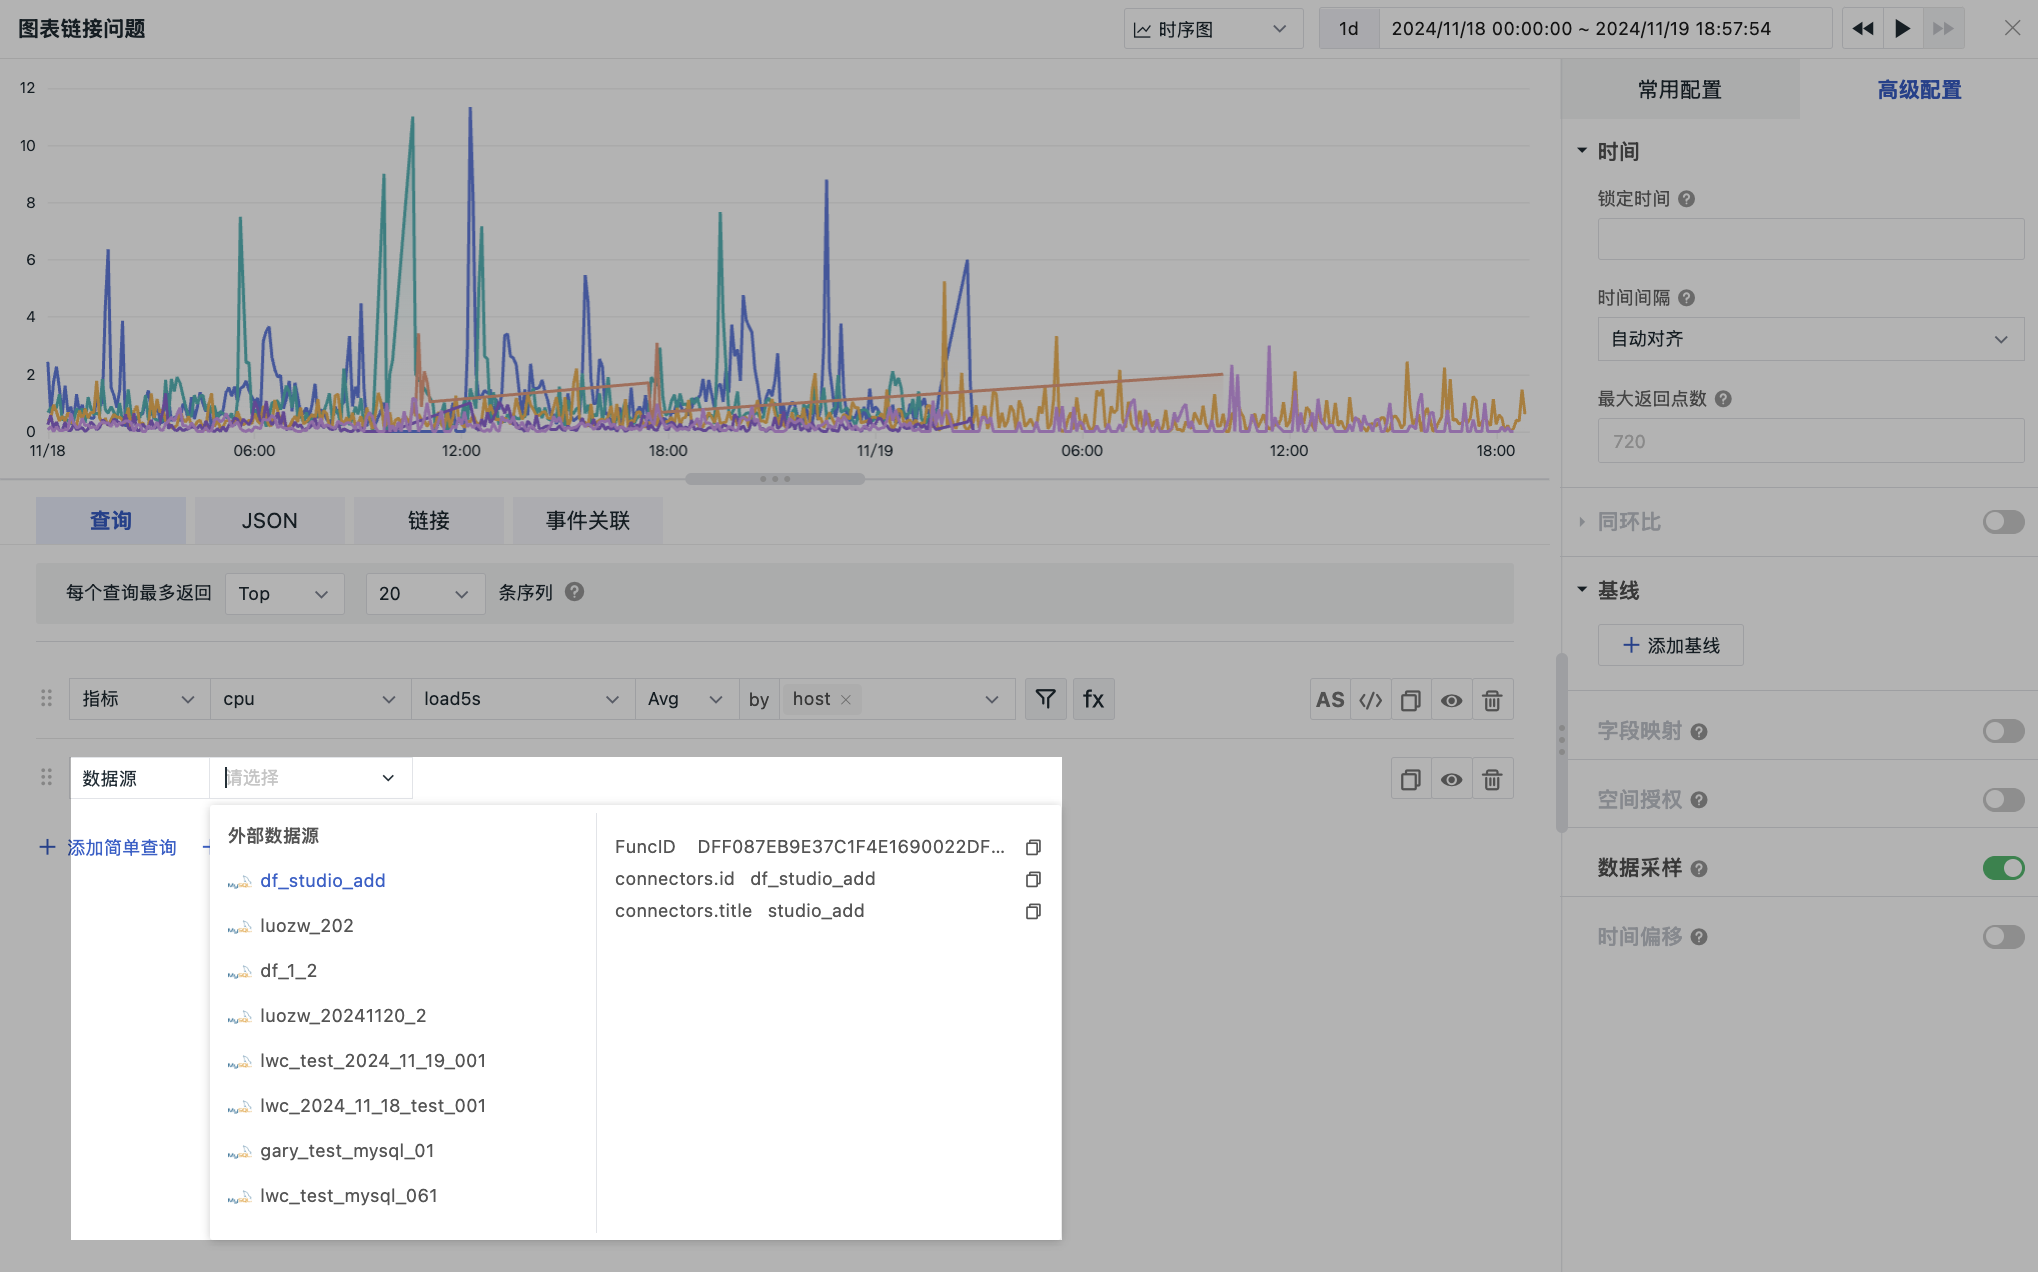
Guance で外部データソースを使用してクエリを実行する代表的なシナリオは、グラフ > グラフクエリです。
| グラフ別のデータ戻り値 | ||
|---|---|---|
| 折れ線グラフ | 円グラフ | テーブルグラフ |