DataKit ログ収集の概要
ログ データは、全体的な可観測性のための柔軟で変更可能な情報の組み合わせ方法を提供します。このため、メトリクスやトレースと比較して、さまざまな環境、アーキテクチャ、テクノロジー スタックの収集シナリオに適応するためのログ収集および処理方法がより多くあります。
一般に、DataKit には次のログ収集ソリューションがあります。
- fromディスクファイル取得ログ
- コンテナーの標準出力ログを収集する
- ログをリモートで DataKit にプッシュする
- サイドカー形式でのログ収集
上記のさまざまな収集方法は、特定の環境の違いにより多少の違いはありますが、通常はこれらの方法を組み合わせたものになります。以下、カテゴリに分けて一つずつ紹介していきます。
ディスクファイルからのログ収集
これはログ処理の最も原始的な方法です。開発者向けであっても、従来のログ収集ソリューションであっても、ログは通常、最初はディスク ファイルに直接書き込まれます。ディスク ファイルに書き込まれるログには次の特徴があります。
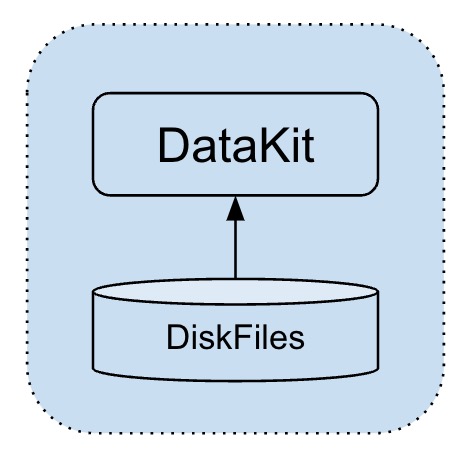
からログを抽出します
- シーケンシャル書き込み: 一般的なログ フレームワークは、ログをディスク ファイルに確実に保存し、時系列を維持できます。
- 自動ローテーション:ディスク上のログファイルは増え続けるため、ディスク容量を使い切らないよう、通常はログフレームワークが自動的にファイルをローテーションします。外部の常駐スクリプトでローテーションを行う場合もあります。
上記の特性に基づいて、DataKit はこれらのファイルの変更を監視する (つまり、最新の更新を収集する) だけを必要とすることは容易に想像できます。ログが書き込まれると、DataKit がそれを収集でき、その展開も非常に簡単です。ログ コレクターの conf に収集するファイル パス (またはワイルドカード パス) を入力するだけです。
アプリケーション ログはすぐに表示されない可能性があるため (たとえば、一部のアプリケーションのエラー ログは、エラーが発生した場合にのみ表示されます)、ログ パスをハードコーディングする代わりに、ワイルドカード パスを使用することをお勧めします (現在存在しないが将来表示されるファイルを構成することもできます)。
ディスク ファイルの収集に関して注意すべき点は、それが DataKit の開始以降に更新されたログ ファイルのみが収集されます。 であることです。構成されたログ ファイル (DataKit の開始以降) が更新されていない場合、それは 履歴データは収集されません です。
この機能により、ログ ファイルが更新され続け、DataKit が途中 (この期間中のログは収集されません。) で停止した場合、この問題を軽減するために後でいくつかの戦略が実装される可能性があります。
コンテナの stdout ログ
この収集方法は現在主に コンテナ環境の標準出力ログ を対象としています。この種のログでは、コンテナー (または Kubernetes ポッド) で実行されているアプリケーションがログを stdout に出力する必要があります。これらの stdout ログは実際にはノード上に配置されます。 DataKit は、対応するコンテナ ID を通じて対応するログ ファイルを見つけ、それを通常のディスク ファイルとして収集します。
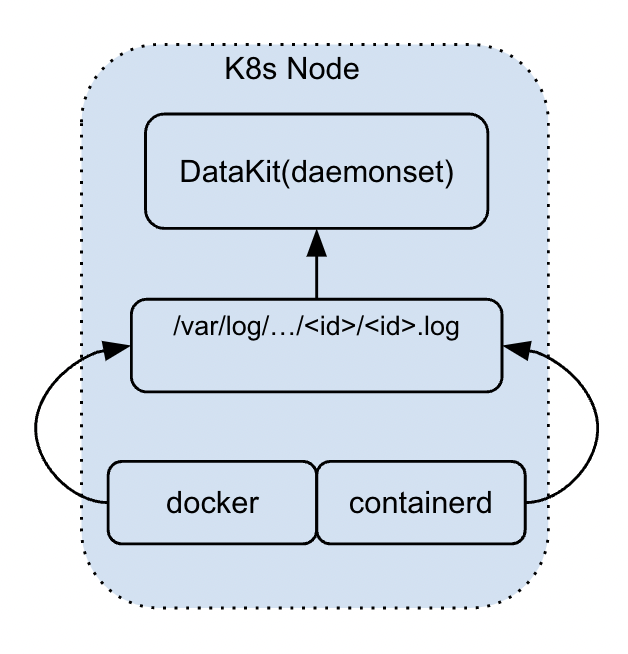
DataKit の既存の stdout 収集ソリューション (主に k8s 環境用) では、ログ収集には次の特徴があります。
-
コンテナ環境にデプロイされたアプリケーションは、対応するコンテナ イメージを構築する必要があるためです。 DataKit の場合、イメージ名に基づいて特定のアプリケーションのログを選択的に収集できます。
- ConfigMap のcontainer.conf で 画像名の一部を選択してください (またはそのワイルドカード) を設定して、固定ポイントで stdout ログを収集します。
- 染色マーク: Annotation を通じて Pod アノテーションを変更する、DataKit はこれらの特別な Pod を識別し、標準出力ログを収集できます。
これは、アプリケーションがログを標準出力に出力する必要があるこの戦略の欠陥でもあります。一般的なアプリケーション開発では、ログが stdout に直接書き込まれることはほとんどなく (ただし、主流のログ フレームワークは一般に stdout への出力をサポートしています)、開発者はログ構成を調整する必要があります。ただし、コンテナ化された展開ソリューションの人気が高まるにつれて、このソリューションは実行可能なログ収集方法と見なすことができます。
DataKit へのリモートログ送信
リモートログプッシュの場合、主に
-
開発者は、Javaのlog4j や Python ネイティブ
SocketHandlerなどの DataKit で指定されたサービスにアプリケーション ログをプッシュします。 を直接サポートし、リモート サービスへのログの送信をサポートします。
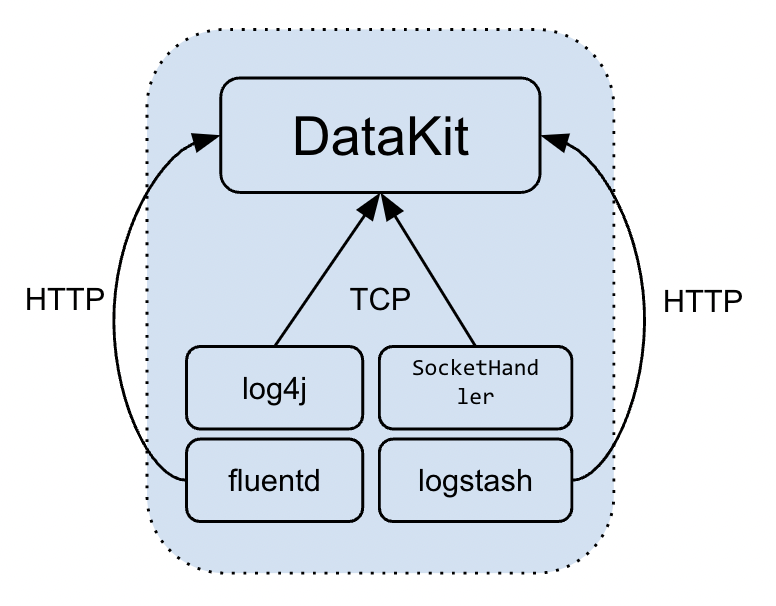
この形式の特徴は、ログを途中で保存することなく、直接 DataKit に送信されることです。この形式でログを収集する場合は、以下の点に注意してください。
- TCP ログ プッシュの場合、ログ タイプ (
source/service) が変更されると、DataKit で複数の TCP ポートを開く必要があります。
DataKit で 1 つ (または少数) の TCP ポートのみを開きたい場合は、後続の Pipeline 処理で解析 フィールドの特性を特定し、関数
set_tag()を使用してserviceとマークする必要があります (現在、ログのsourceフィールドを変更することは不可能であり、この関数には バージョン 1.2.8 以降でのみサポートされています のみがあります)。
- HTTP 形式でログをプッシュする場合、開発者は、DataKit による後続の処理を容易にするために、HTTPリクエストパラメータで優れた機能をマークする を指定する必要があります。
Sidecar によるログ収集
この収集方法は、実際にはディスク ログ収集とログ リモート プッシュを組み合わせたものです。具体的には、DataKit (つまり、logfwd) に一致する Sidecar アプリケーションをユーザーの Pod に追加します。回収方法は以下の通りです。
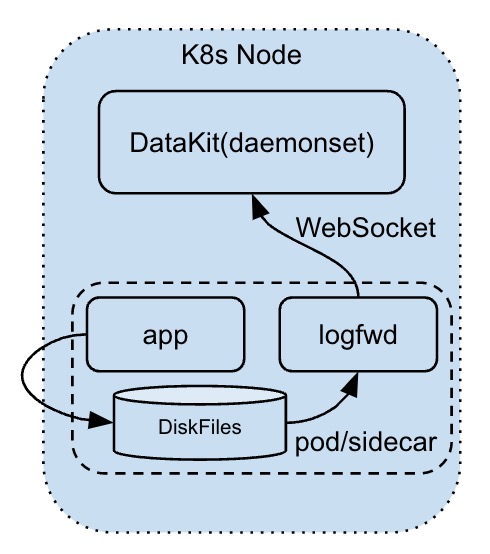
- まず、logfwd を使用してログをディスク ファイルとして取得します。
- 次に、logfwd がログをリモート (WebSocket) で DataKit にプッシュします。
このメソッドは現在、k8s 環境でのみ使用できます。次のような特徴があります。
- 単純なリモート ログ プッシュと比較して、Pod 名や k8s 名前空間情報など、Pod の一部の k8s 属性フィールドを自動的に追加できます。
- 開発者は、ログ構成を変更しなくても、ログをディスクに出力できます。 k8s 環境では、外部ストレージは必要ありません。 logfwd は、ポッド自体のストレージからログを直接取得してプッシュします (ただし、ポッドのストレージがいっぱいになるのを避けるために、ログは自動解析用に設定する必要があります)
ログの処理
上記のログが収集されると、それらはすべて後続のPipeline解析をサポートしますが、構成形式は若干異なります。
- ディスク ログ収集:logging.conf で直接設定し、Pipeline名を指定します。
- コンテナの stdout ログ収集:container.conf では Pipeline を設定できません。これは全コンテナのログ収集を対象としており、共通の Pipeline ですべてのログを処理するのが困難なためです。そのため、Annotation を使用して 対象 Pod の Pipeline 設定を指定 する必要があります。
- リモートログ収集:TCP/UDP 転送では、logging.conf で Pipeline 設定を指定できます。HTTP 転送では、開発者が HTTP リクエストパラメーターで Pipeline を設定 する必要があります。
- Sidecar によるログ収集:logfwd の設定 で、Sidecar を配置した Pod の Pipeline を設定します。コンテナの stdout 収集と同様に、対象 Pod に設定を付与する方式です。
ログ収集に共通する追加オプション
すべてのログ収集方式で、前述の Pipeline による解析に加え、次の設定を使用できます。
- 複数行ログの分割:ほとんどのログは単一行ですが、スタックトレースや MySQL のスローログなど、複数行にわたるログもあります。
- 文字エンコーディング:ログは最終的に UTF8 に変換して保存する必要があります。一部の Windows ログでは、エンコードとデコードの処理が必要になる場合があります。
まとめ
以上、DataKit の現在のログ収集方式を紹介しました。これらの方式で、主要なログ収集シナリオをおおむねカバーできます。ソフトウェア技術の進化に伴って新しいログ形式が登場した際には、DataKit も新たなシナリオに対応できるよう調整していきます。